Modern bir işlemci, bir programdaki talimatları sırayla ve sabırla bekleyerek çalıştırmaz; adeta aceleci bir satranç oyuncusu gibi bir sonraki hamleyi önceden kestirmeye çalışır. Dallanma tahmini (branch prediction), if, while, for ve fonksiyon dönüşleri gibi karar noktalarında hangi kod yolunun izleneceğini tahmin eden donanım tekniğidir. Doğru tahminler işlem hattını dolu tutar, yanlış tahminler ise pahalı bir geri sarma etkisi yaratır.
Devamı...
Büyük bir yazılım projesinde derleme süresi, kahve molasından uzun sürmeye başladıysa Bazel ile tanışma vakti gelmiş olabilir. Google tarafından geliştirilen Bazel; C++, Java, Python, Go ve daha birçok dili aynı depoda yönetebilen, bağımlılıkları açıkça tanımlayan ve sonuçları önbelleğe alan modern bir derleme sistemidir. Temel hedefi basittir: Makineniz, işletim sisteminiz veya ekip arkadaşınız değişse bile aynı kaynak kodundan aynı çıktıyı hızlı biçimde üretmek.
Devamı...
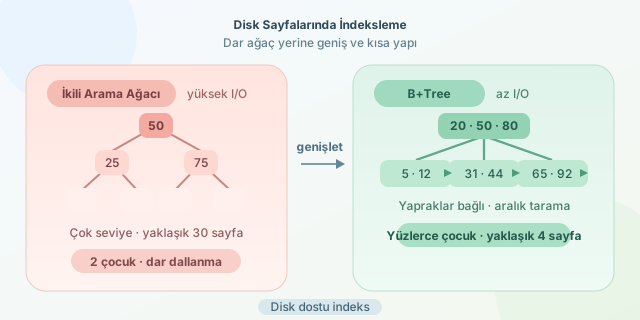
Bir veritabanında milyonlarca kaydı bulmak, bellekte küçük bir dizide arama yapmaktan oldukça farklıdır. Klasik ikili arama ağaçları (BST), teoride zarif görünür: her düğümün en fazla iki çocuğu vardır ve dengeli bir yapıda arama maliyeti $O(\log_2 N)$ olur. Ancak disk ve SSD üzerinde çalışan veritabanları için asıl pahalı işlem karşılaştırma değil, sayfa okuma yani I/O işlemidir. İşte B-Tree ve B+Tree bu maliyeti dramatik biçimde düşürmek için sahneye çıkar.
Devamı...
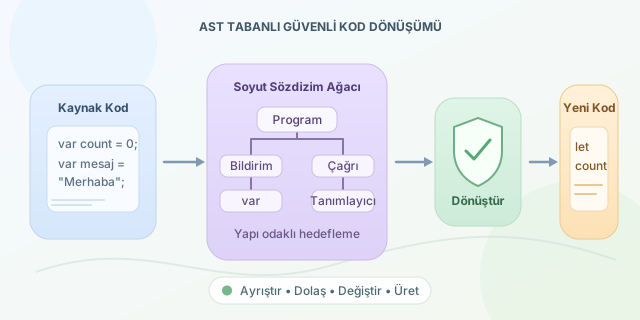
Kaynak kodunu metin olarak bul-değiştir yapmak ilk bakışta caziptir; ancak bir fonksiyon adını yorum satırında, metin içinde veya farklı bir kapsamda yanlışlıkla değiştirmek saniyeler içinde karmaşaya dönüşebilir. AST (Abstract Syntax Tree / Soyut Sözdizim Ağacı) tabanlı dönüşüm araçları, kodu karakter dizisi olarak değil, anlamlı program yapıları olarak ele alır. Böylece güvenli yeniden adlandırma, modern sözdizimine geçiş ve ekip standartlarına otomatik uyum mümkün olur.
Devamı...
Modern yazılımlarda performans sorunlarının önemli bir bölümü işlemciden değil, bellek tahsisinden doğar. Her geçici nesne için malloc, new ya da benzeri bir çağrı yapmak; ayırıcıyı kilitleme, uygun boş blok bulma ve parçalanmayı yönetme gibi ek maliyetler yaratır. Arena allocator yaklaşımı bu maliyeti dramatik biçimde azaltır: Büyük bir bellek bölgesi ayırır, küçük nesneleri bu bölge içinde sırayla yerleştirir ve iş bittiğinde hepsini tek hamlede temizler.
Devamı...
Bir ürün kataloğunda “kırmızı spor ayakkabı” aramak kolaydır; ancak “yağmurlu havada şehir yürüyüşüne uygun hafif bir şey” demek, klasik anahtar kelime aramasını zorlar. Vektör veritabanları tam burada devreye girer: metin, görsel, ses veya davranış verisini anlamı temsil eden sayısal koordinatlara dönüştürür ve birbirine en yakın kayıtları milisaniyeler içinde bulur.
Devamı...
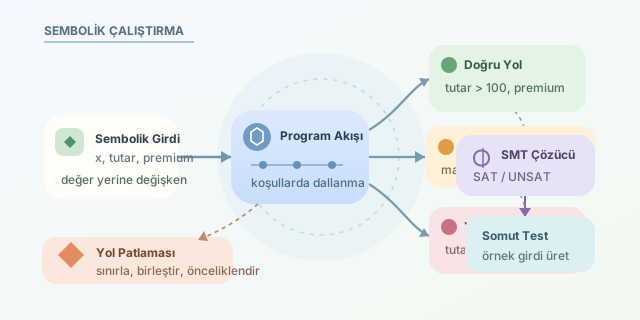
Bir programı test ederken birkaç örnek girdi vermek çoğu zaman yeterli görünür: 0, 42, belki negatif bir sayı… Ancak bu yaklaşım, kodun karanlıkta kalan dallarını kolayca kaçırır. Symbolic Execution (sembolik çalıştırma), somut değerler yerine sembolik değişkenlerle ilerleyerek programın ulaşılabilir tüm mantıksal yollarını analiz etmeyi amaçlayan gelişmiş bir test ve hata bulma tekniğidir. Kısacası programı tek tek örneklerle değil, olası girdilerin matematiksel temsilcileriyle yürütür.
Devamı...
Bir makine öğrenmesi modeli yüksek doğruluk verdiğinde ilk soru genellikle “Ne kadar başarılı?” olur; ikinci ve çoğu zaman daha kritik soru ise “Bu karara neden vardı?”dır. SHAP (SHapley Additive exPlanations), bir tahmini özelliklerin katkılarına bölerek bu soruya sayısal bir yanıt verir. Böylece kredi reddi, müşteri terk tahmini veya fiyat tahmini gibi sonuçlarda modelin hangi sinyalleri ne yönde kullandığını görünür kılar.
Devamı...
Büyük dil modelleri (LLM), eğitim verilerindeki örüntülerden etkileyici yanıtlar üretir; ancak eğitim tarihinden sonra yaşanan gelişmeleri doğal olarak bilemezler. Daha da önemlisi, kurum içi dokümanlar, ürün katalogları veya sürekli değişen mevzuat gibi özel bilgileri doğrudan modelin parametrelerine koymak hem pahalı hem de risklidir. Retrieval-Augmented Generation (RAG), modeli yeniden eğitmek yerine doğru bilgiyi doğru anda bularak bu açığı kapatan mimaridir.
Devamı...
Büyük dil modelleri ve görüntü ağları etkileyici sonuçlar üretse de bunun bir bedeli vardır: milyarlarca parametre, yüksek RAM/VRAM tüketimi ve gecikme. Quantization (nicemleme), modelin öğrendiği bilgiyi mümkün olduğunca koruyup sayısal temsilini daha düşük hassasiyetli formatlara taşıyarak bu bedeli azaltan temel optimizasyon tekniklerinden biridir. Kısacası, modelin bavulunu hafifletirken yolculuk performansını korumaya çalışırız.
Devamı...
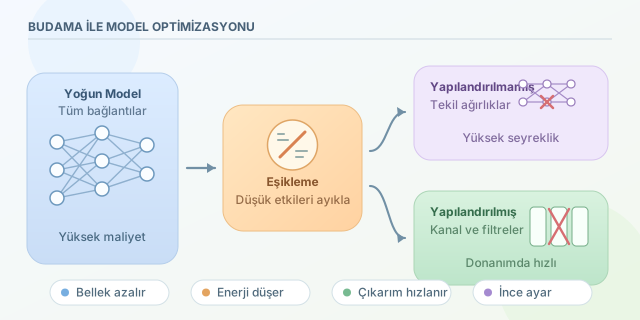
Derin öğrenme modelleri büyüdükçe doğrulukları genellikle artar; ancak bu büyümenin bir faturası vardır: daha fazla bellek, daha yüksek enerji tüketimi ve daha uzun çıkarım süresi. Pruning, yani budama, bir ağdaki düşük etkili ağırlıkları, nöronları veya hatta tüm katman parçalarını kaldırarak bu faturayı azaltmayı hedefler. Amaç modeli rastgele küçültmek değil, tahmin kalitesini mümkün olduğunca korurken gereksiz hesaplamaları ayıklamaktır.
Devamı...
Bir büyük dil modelinden tek seferde kapsamlı bir rapor yazmasını, verileri analiz etmesini, kaynakları denetlemesini ve sonucu belirli bir formatta sunmasını istemek caziptir. Ancak bu yaklaşım çoğu zaman belirsiz, tutarsız veya kolayca doğrulanamayan çıktılar üretir. Prompt chaining, büyük bir hedefi birbirini besleyen küçük istemlere ayırarak bu sorunu azaltan tekniktir. Zincirde her adım, önceki adımın çıktısını girdi olarak kullanır; böylece görev hem denetlenebilir hem de yeniden üretilebilir hâle gelir.
Devamı...
Bir programın kaynak kodu, insan gözüyle satırlardan oluşur; fakat analiz araçları için asıl değerli olan şey bu satırların taşıdığı yapıdır. Abstract Syntax Tree (AST), yani Soyut Sözdizim Ağacı, kodu değişken tanımı, fonksiyon çağrısı, koşul ve döngü gibi anlamlı düğümlere ayırır. Böylece otomatik kalite kontrolleri, güvenlik taramaları ve kod dönüşümleri düzenli ifadelerin kırılgan dünyasından kurtulur.
Devamı...
Bir yapay zeka modelini eğitmek çoğu zaman işin heyecanlı kısmıdır; asıl macera ise modeli üretime taşırken başlar. PyTorch ile eğitilmiş bir modeli Java tabanlı bir serviste, C# masaüstü uygulamasında veya edge cihazda çalıştırmak istediğinizde framework bağımlılıkları hız kesebilir. ONNX (Open Neural Network Exchange), modeller için ortak bir dil sunarak bu taşınabilirlik problemini çözmeyi hedefleyen açık standarttır.
Devamı...
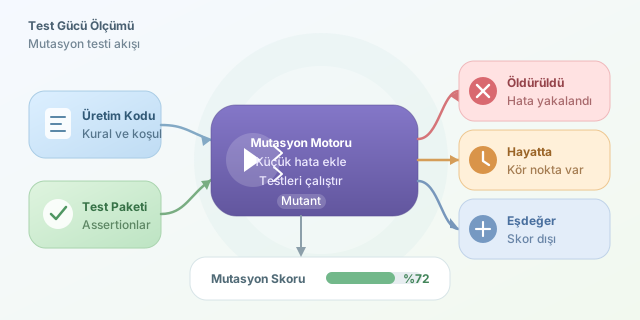
Bir test paketinin yeşil olması, uygulamanın iyi test edildiği anlamına gelmez. Testler yalnızca kodu çalıştırıyor, fakat yanlış sonucu fark etmiyor olabilir. Mutation testing (mutasyon testi), bu konfor alanını bozan bir tekniktir: Kodunuza kasıtlı, küçük hatalar ekler ve testlerinizin bu hataları yakalayıp yakalayamadığını ölçer. Kısacası soru “Kod çalışıyor mu?” değil, “Testlerim hatalı kodu reddedebiliyor mu?” olur.
Devamı...
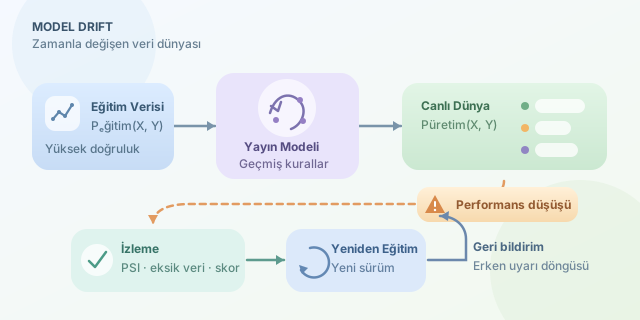
Bir makine öğrenmesi modelini yayına almak, yarışın bitiş çizgisi değil; aslında başlangıç tabancasıdır. Eğitim verisinde %95 doğruluk yakalayan bir dolandırıcılık, öneri ya da tahmin modeli, birkaç ay sonra beklenmedik biçimde hatalı kararlar vermeye başlayabilir. Bu olaya model drift denir: Modelin üretim ortamındaki performansının, zaman içinde eğitim dönemindeki performansından anlamlı biçimde uzaklaşmasıdır.
Devamı...
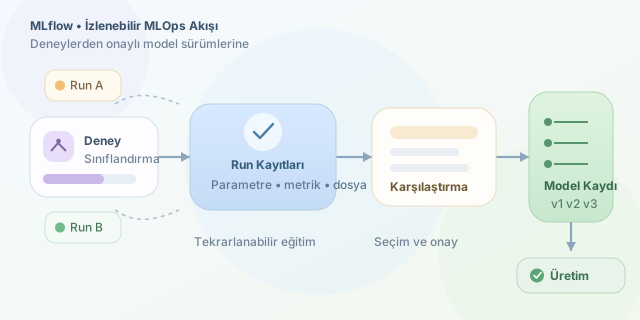
Bir makine öğrenmesi projesinde zor olan yalnızca yüksek doğruluk üreten modeli bulmak değildir; hangi veriyle, hangi parametrelerle ve hangi kod sürümüyle üretildiğini aylar sonra da kanıtlayabilmektir. MLflow, deney kayıtlarını, model dosyalarını ve dağıtıma uygun sürümleri aynı izlenebilir akışta toplayarak bu karmaşayı yönetir. Böylece “not defterimde çalışıyordu” cümlesi, yerini ölçülebilir ve tekrarlanabilir bir sürece bırakır.
Devamı...
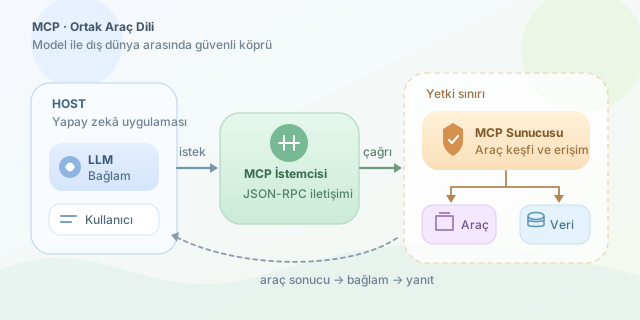
Büyük dil modelleri metin üretmekte çok başarılıdır; ancak tek başlarına takviminize bakamaz, veritabanınızdan müşteri kaydı çekemez veya GitHub’daki bir depoyu analiz edemezler. Bu noktada MCP (Model Context Protocol), yapay zekâ uygulamalarının harici araçlar ve veri kaynaklarıyla güvenli, düzenli ve standart bir biçimde konuşmasını sağlayan açık bir protokol olarak devreye girer.
Devamı...
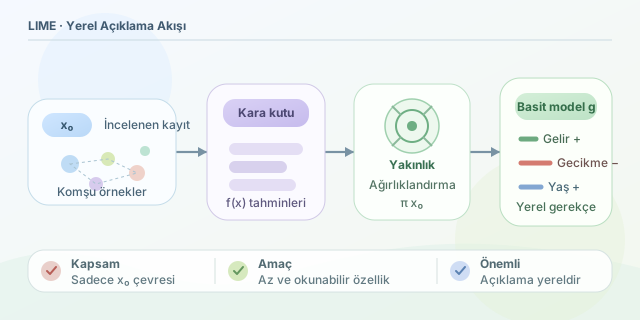
Derin öğrenme ve ansambl yöntemleri yüksek doğruluk sağlayabilir; fakat bir müşterinin kredi başvurusunun neden reddedildiğini ya da bir görselin neden “kedi” olarak etiketlendiğini açıklamak çoğu zaman zordur. LIME (Local Interpretable Model-agnostic Explanations), bu kara kutu hissini tamamen ortadan kaldırmasa da tek bir tahminin çevresine güçlü bir el feneri tutar: Karmaşık modelin belirli bir örnek için nasıl karar verdiğini, anlaşılabilir basit bir modelle yaklaşık olarak açıklar.
Devamı...
Bir yazılımın mutlu yolunda çalışması, onun her koşulda güvenli olduğu anlamına gelmez. Kullanıcıların boş metin, devasa dosya, bozuk karakter kodlaması veya beklenmeyen veri türleri gönderebildiği gerçek dünyada asıl sorunlar köşe durumlarda yaşanır. Fuzz testing ya da kısa adıyla fuzzing, uygulamalara otomatik biçimde sıra dışı, hatalı veya rastgele girdiler göndererek çökmeleri, istisnaları ve güvenlik açıklarını bulma disiplinidir. Bir bakıma yazılımınıza kontrollü kaos yaşatırsınız.
Devamı...