İçindekiler
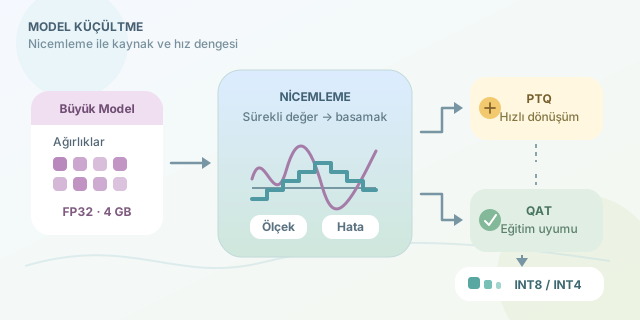
Büyük dil modelleri ve görüntü ağları etkileyici sonuçlar üretse de bunun bir bedeli vardır: milyarlarca parametre, yüksek RAM/VRAM tüketimi ve gecikme. Quantization (nicemleme), modelin öğrendiği bilgiyi mümkün olduğunca koruyup sayısal temsilini daha düşük hassasiyetli formatlara taşıyarak bu bedeli azaltan temel optimizasyon tekniklerinden biridir. Kısacası, modelin bavulunu hafifletirken yolculuk performansını korumaya çalışırız. ``
Neden model boyutu önemlidir?
Bir modeldeki her parametre bellekte belirli sayıda bit kaplar. Örneğin float32 türündeki bir ağırlık 32 bit, yani 4 bayt tüketir. Bir milyar parametreli modelin yalnızca ağırlıkları yaklaşık olarak şu alanı kullanır:
Bu hesap eğitim sırasında daha da büyür; gradyanlar, optimizer durumları ve ara tensörler de belleğe eklenir. Çıkarımda (inference) ise düşük hassasiyetli ağırlıklar özellikle mobil cihazlar, CPU sunucuları ve sınırlı VRAM’e sahip GPU’lar için hayat kurtarıcıdır.
Quantization mantığı: sürekli değerleri basamaklara oturtmak
Sinir ağı ağırlıkları çoğunlukla kayan noktalı sayılardır. Quantization, bu değerleri daha sınırlı sayıdaki temsil edilebilir seviyeye eşler. Simetrik bir int8 nicemleme yaklaşımında temel fikir şöyledir:
\[q = \operatorname{round}\left(\frac{x}{s}\right), \qquad \hat{x} = s \cdot q\]Burada $x$ orijinal değer, $q$ tamsayılaştırılmış değer, $s$ ise ölçek (scale) katsayısıdır. $\hat{x}$ geri dönüştürülmüş yaklaşık değerdir. Bu dönüşüm küçük bir hata üretir:
\[\epsilon = x - \hat{x}\]Amaç, bu hatayı modelin doğruluğunu gözle görülür biçimde düşürmeyecek kadar küçük tutmaktır. Her ağırlığı kusursuz saklamak yerine, görev için yeterince iyi olan daha kompakt bir temsil seçilir.
| Veri türü | Parametre başına alan | 1B parametre için yaklaşık boyut | Tipik kullanım |
|---|---|---|---|
| FP32 | 4 bayt | 4 GB | Eğitim, yüksek hassasiyet |
| FP16/BF16 | 2 bayt | 2 GB | GPU çıkarımı ve eğitim |
| INT8 | 1 bayt | 1 GB | Hızlı çıkarım |
| INT4 | 0,5 bayt | 0,5 GB | LLM dağıtımı, düşük bellek |
PTQ ve QAT: iki farklı yol
Quantization uygulamak için en yaygın iki yaklaşım Post-Training Quantization (PTQ) ve Quantization-Aware Training’dir (QAT). PTQ, eğitimi bitmiş modele sonradan uygulanır. Hızlıdır, ucuzdur ve çoğu pratik senaryoda ilk denenmesi gereken yöntemdir. QAT ise eğitim sırasında nicemleme hatasını simüle eder; model bu hataya uyum sağlamayı öğrenir. Özellikle doğruluk kaybına hassas görüntü sınıflandırma modellerinde daha iyi sonuç verebilir.
| Yaklaşım | Avantaj | Dezavantaj | Ne zaman seçilmeli? |
|---|---|---|---|
| PTQ | Hızlı ve düşük maliyetli | Doğruluk düşebilir | Hazır model, hızlı dağıtım |
| QAT | Daha iyi doğruluk potansiyeli | Yeniden eğitim gerekir | Kritik kalite gereksinimi |
| Dynamic quantization | Kolay uygulanır | Her katmanda eşit kazanç yok | CPU odaklı transformer modelleri |
PyTorch ile dinamik quantization için temel bir örnek şöyledir:
import torch
from torch.ao.quantization import quantize_dynamic

model = torch.load("model_fp32.pt", weights_only=False)
model.eval()

# Linear katmanlarının ağırlıklarını int8 formatına taşır.
quantized_model = quantize_dynamic(
    model,
    {torch.nn.Linear},
    dtype=torch.qint8
)

torch.save(quantized_model.state_dict(), "model_int8.pt")
Bu örnek özellikle Linear katmanları yoğun olan transformer benzeri mimarilerde faydalıdır. Ancak dosya boyutunu tek başına başarı ölçütü saymayın: gerçek kazanç için gecikme, saniye başına token, RAM tüketimi ve görev metrikleri birlikte ölçülmelidir.
Her modeli körlemesine INT4’e indirmeyin
Daha az bit her zaman daha iyi değildir. Aykırı değerler (outlier), aktivasyon dağılımları ve katman hassasiyetleri nedeniyle bazı katmanlar INT4’te ciddi kalite kaybedebilir. Bu yüzden karma hassasiyetli yaklaşım mantıklıdır: hassas katmanları FP16’da, daha dayanıklı katmanları INT8 veya INT4’te tutabilirsiniz.
Sonuç olarak quantization, modeli “daha kötü” yapmak değil, kaynaklarla kalite arasında bilinçli bir mühendislik anlaşması yapmaktır. Önce FP16 veya INT8 PTQ ile başlayın, temsilî bir doğrulama kümesi kullanın ve ölçmeden optimizasyon yaptığınıza asla inanmayın.
Yorumlar