İçindekiler
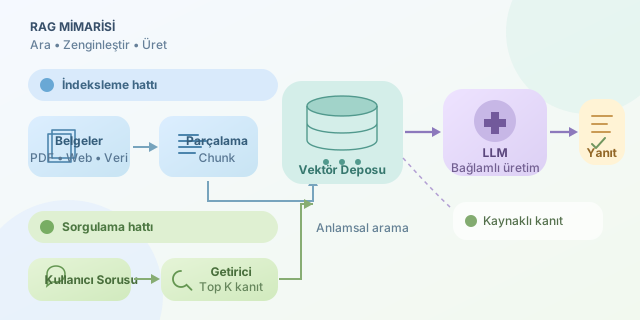
Büyük dil modelleri (LLM), eğitim verilerindeki örüntülerden etkileyici yanıtlar üretir; ancak eğitim tarihinden sonra yaşanan gelişmeleri doğal olarak bilemezler. Daha da önemlisi, kurum içi dokümanlar, ürün katalogları veya sürekli değişen mevzuat gibi özel bilgileri doğrudan modelin parametrelerine koymak hem pahalı hem de risklidir. Retrieval-Augmented Generation (RAG), modeli yeniden eğitmek yerine doğru bilgiyi doğru anda bularak bu açığı kapatan mimaridir. `` RAG yaklaşımını bir sınava açık kitapla giren öğrencinin stratejisi gibi düşünebilirsiniz. Model, dil anlama ve açıklama yeteneğine sahip öğrencidir; vektör veritabanı ise iyi indekslenmiş kütüphanedir. Soru geldiğinde sistem önce kütüphanede ilgili sayfaları bulur, sonra bu sayfaları modelin bağlamına ekler. Model de yanıtını yalnızca genel hafızasına değil, getirilen kanıtlara dayandırır.
Temel akış: Ara, zenginleştir, üret
Bir RAG hattı iki ana aşamadan oluşur: indeksleme ve sorgulama. İndeksleme aşamasında PDF, web sayfası veya veritabanı kayıtları küçük parçalara, yani chunk‘lara bölünür. Her parça bir embedding modeliyle sayısal vektöre dönüştürülür. Anlamca benzer metinlerin vektör uzayında birbirine yakın olması hedeflenir.
Benzerlik çoğunlukla kosinüs benzerliği ile hesaplanır:
\[\operatorname{cosine}(q,d)=\frac{q \cdot d}{\\vert q\\vert \\vert d\\vert }\]Burada $q$ sorgu vektörü, $d$ ise doküman parçası vektörüdür. Skoru yüksek olan ilk $k$ parça seçilir. Ardından kullanıcı sorusu ve seçilen içerikler bir istemde birleştirilerek LLM’e gönderilir. Bu süreci basitçe şöyle ifade edebiliriz:
\[\text{Yanıt}=LLM(\text{Soru}+\operatorname{TopK}(\text{Retriever},\text{Soru}))\]| Yaklaşım | Bilgi nerede durur? | Güncelleme maliyeti | Kaynak gösterme |
|---|---|---|---|
| Sadece LLM | Model parametrelerinde | Yeniden eğitim gerekir | Zor |
| Fine-tuning | Model parametrelerinde | Orta-yüksek | Sınırlı |
| RAG | Harici bilgi tabanında | Düşük | Güçlü |
Neden chunk boyutu kritik?
Çok büyük parçalar aramayı gürültülü hâle getirir: İlgili cümle bulunur ama yanında gereksiz sayfalar da taşınır. Çok küçük parçalar ise bağlamı koparabilir. Örneğin teknik dokümantasyonda 300-800 token arası parçalar ve %10-20 örtüşme sık kullanılan bir başlangıç noktasıdır. Elbette ideal değer; dil, belge tipi ve soru uzunluğuna göre ölçülerek seçilmelidir.
Aşağıdaki Python örneği, kavramsal olarak bir sorgunun en yakın metinleri nasıl getireceğini gösterir. Gerçek projede embeddings ve vector_store bileşenleri bir model ve FAISS, Chroma ya da Pinecone gibi bir depoyla değiştirilir.
query = "İade süresi kaç gündür?"
query_vector = embeddings.embed_query(query)

matches = vector_store.similarity_search(
    query_vector,
    k=3
)

context = "\n\n".join(doc.page_content for doc in matches)
prompt = f"""Soruyu yalnızca verilen kaynaklara göre yanıtla.
Kaynaklar:\n{context}\n\nSoru: {query}"""

answer = llm.generate(prompt)
print(answer)
Kodun önemli fikri, modelden önce arama yapılmasıdır. Ayrıca istemde “yalnızca kaynaklara göre yanıtla” demek halüsinasyonu azaltır; fakat tamamen sıfırlamaz. Modelin yeterli kanıt yoksa “bilmiyorum” diyebilmesi açıkça istenmelidir.
Kaliteli bir RAG için kontrol listesi
| Sorun | Belirti | İyileştirme |
|---|---|---|
| Zayıf getirme | Yanıt konu dışı | Hibrit arama ve yeniden sıralama kullanın |
| Eski içerik | Yanıt güncel değil | İndeksi düzenli yenileyin |
| Bağlam taşması | Maliyet ve gecikme artar | Daha iyi chunking, daha küçük $k$ seçin |
| Uydurma yanıt | Kaynakta olmayan iddia | Alıntı, güven eşiği ve ret politikası ekleyin |
Hibrit arama özellikle değerlidir: Semantik vektör araması anlam benzerliğini yakalarken, anahtar kelime araması ürün kodu veya yasa maddesi gibi tam eşleşmelerde başarılıdır. Son aşamada bir reranker, getirilen adayları soru ile birlikte tekrar puanlayarak ilk sonuçların kalitesini artırabilir.
Özetle RAG, LLM’i her şeyi bilen bir kahin olmaktan çıkarıp kanıtla çalışan yetkin bir asistana dönüştürür. Başarının anahtarı yalnızca güçlü bir model seçmek değil; temiz veri, doğru parçalama, ölçülebilir retrieval kalitesi ve kaynak odaklı üretim tasarlamaktır.
Yorumlar