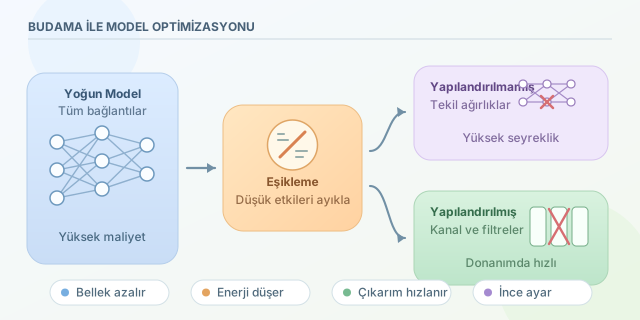
Derin öğrenme modelleri büyüdükçe doğrulukları genellikle artar; ancak bu büyümenin bir faturası vardır: daha fazla bellek, daha yüksek enerji tüketimi ve daha uzun çıkarım süresi. Pruning, yani budama, bir ağdaki düşük etkili ağırlıkları, nöronları veya hatta tüm katman parçalarını kaldırarak bu faturayı azaltmayı hedefler. Amaç modeli rastgele küçültmek değil, tahmin kalitesini mümkün olduğunca korurken gereksiz hesaplamaları ayıklamaktır.
``
Bir sinir ağındaki bağlantıyı ağırlık değeri $w$ ile düşünelim. Ağırlığın mutlak değeri küçükse, ilgili bağlantının çıktıya katkısı çoğu zaman sınırlıdır. Basit eşik tabanlı budamada kural şöyledir:
\[w' = \begin{cases} 0, & \vert w\vert < \tau \\ w, & \vert w\vert \geq \tau \end{cases}\]Burada $\tau$ budama eşiğidir. Eşik arttıkça daha fazla ağırlık sıfırlanır; model küçülür ama doğruluk kaybetme riski de yükselir. Bu nedenle pruning, “ne kadarını silebiliriz?” sorusundan çok, “hangi parçalar gerçekten önemli?” sorusudur.
Budama yaklaşımları
Pruning teknikleri iki temel gruba ayrılır: yapılandırılmamış ve yapılandırılmış budama. İlki tek tek ağırlıkları sıfırlarken ikincisi filtre, kanal veya nöron gibi donanımın daha kolay işleyebileceği blokları kaldırır.
| Özellik | Yapılandırılmamış Pruning | Yapılandırılmış Pruning |
|---|---|---|
| Kaldırılan birim | Tekil ağırlıklar | Kanal, filtre, nöron, blok |
| Sıkıştırma oranı | Genellikle yüksektir | Orta ila yüksek |
| Standart donanımda hızlanma | Her zaman belirgin değildir | Genellikle daha belirgindir |
| Uygulama karmaşıklığı | Seyrek matris desteği gerekebilir | Daha kolay dağıtılır |
Yapılandırılmamış yaklaşımda matrisin birçok elemanı sıfır olur. Bu durum dosya boyutunu azaltabilir, fakat CPU veya GPU bu sıfırları atlayacak biçimde optimize edilmemişse gerçek hız kazancı beklenenden düşük kalabilir. Yapılandırılmış pruning ise örneğin bir CNN katmanındaki az katkı veren kanalları tamamen kaldırır. Böylece sonraki katmanın giriş boyutu da küçülür; yani hesaplama zincirinin tamamı hafifler.
Magnitude pruning nasıl uygulanır?
En yaygın başlangıç yöntemi, ağırlıkları büyüklüklerine göre sıralayıp en küçüklerini budamaktır. Aşağıdaki PyTorch örneği, doğrusal bir katmandaki ağırlıkların yüzde 30’unu sıfırlar. Bu işlem eğitim sonrasında uygulanabilir; daha iyi sonuç için ardından kısa bir fine-tuning turu yapılmalıdır.
import torch
import torch.nn.utils.prune as prune

layer = torch.nn.Linear(128, 64)

# En küçük mutlak değere sahip ağırlıkların %30'unu maskele.
prune.l1_unstructured(
    layer,
    name="weight",
    amount=0.30
)

# Maskeyi kalıcı hale getir; weight_orig ve weight_mask birleşir.
prune.remove(layer, "weight")

sparsity = (layer.weight == 0).float().mean()
print(f"Seyreklik oranı: {sparsity:.0%}")
Bu kod yalnızca ağırlıkları sıfırlar; modelin doğruluğunu otomatik olarak garanti etmez. Budama sonrası eğitimde daha düşük bir öğrenme oranı kullanmak, modelin kalan bağlantılara yeniden uyum sağlamasına yardım eder. Bu süreçte kayıp fonksiyonu tipik olarak $\mathcal{L}_{task}$ iken, seyrekliği teşvik etmek için $L_1$ cezası da eklenebilir:
\[\mathcal{L} = \mathcal{L}_{task} + \lambda \sum_i \vert w_i\vert\]$\lambda$ büyüdükçe küçük ağırlıklar sıfıra yaklaşma eğilimi gösterir. Ancak aşırı büyük bir değer, modelin öğrenme kapasitesini erkenden kısıtlayabilir.
Ne zaman hangi yöntemi seçmeli?
| Senaryo | Önerilen yaklaşım | Neden |
|---|---|---|
| Model dosyasını küçültmek | Yapılandırılmamış pruning + sıkıştırma | Çok sayıda sıfır üretir |
| Mobilde gecikmeyi azaltmak | Kanal/filtre pruning | Yoğun tensör işlemleri küçülür |
| Hızlı prototip | Global magnitude pruning | Kolay uygulanır |
| Kritik doğruluk gereksinimi | Kademeli pruning + fine-tuning | Ani kalite düşüşünü azaltır |
En güvenli strateji, hedef seyreklik oranına bir anda ulaşmak yerine kademeli ilerlemektir. Örneğin eğitim boyunca seyreklik oranını $0\%$’dan $80\%$’e yükseltmek, ağın değişime adapte olmasını sağlar. Sonuçta iyi bir pruning süreci; doğruluk, gecikme, bellek ve donanım desteğini birlikte ölçen küçük ama disiplinli bir optimizasyon macerasıdır.
Yorumlar