İçindekiler
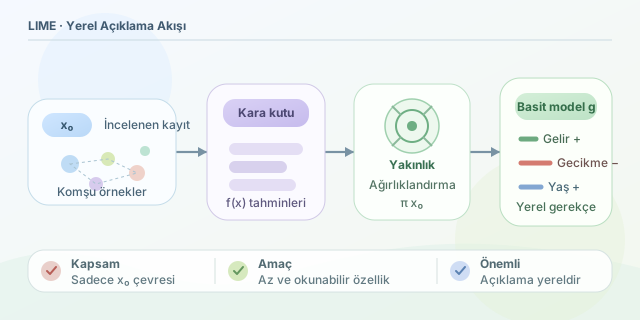
Derin öğrenme ve ansambl yöntemleri yüksek doğruluk sağlayabilir; fakat bir müşterinin kredi başvurusunun neden reddedildiğini ya da bir görselin neden “kedi” olarak etiketlendiğini açıklamak çoğu zaman zordur. LIME (Local Interpretable Model-agnostic Explanations), bu kara kutu hissini tamamen ortadan kaldırmasa da tek bir tahminin çevresine güçlü bir el feneri tutar: Karmaşık modelin belirli bir örnek için nasıl karar verdiğini, anlaşılabilir basit bir modelle yaklaşık olarak açıklar. ``
LIME’ın adındaki üç kelime yaklaşımın özüdür. Local, açıklamanın modelin her yerinde değil, incelenen örneğin yakınında geçerli olduğunu söyler. Interpretable, açıklama için lineer regresyon veya küçük karar ağacı gibi insanların okuyabileceği modeller kullanıldığını anlatır. Model-agnostic ise yöntemin; lojistik regresyon, XGBoost, sinir ağı veya dışarıdan erişilen bir API fark etmeksizin, tahmin olasılıklarına erişebildiği her modelle çalışabilmesidir.
Temel fikir: Yakında basit, uzakta karmaşık
Elimizde karmaşık bir tahmin fonksiyonu $f(x)$ ve açıklamak istediğimiz gözlem $x_0$ olsun. LIME, $x_0$ çevresinde sentetik komşular üretir. Örneğin metin verisinde bazı kelimeleri kaldırır; tablo verisinde gelir veya yaş gibi değişkenleri küçük aralıklarda değiştirir; görüntüde ise süperpiksel bölgelerini kapatır. Ardından her komşu için kara kutu modelin tahminini alır.
Ancak her komşu eşit derecede önemli değildir. $x_0$’a yakın örneklere daha yüksek ağırlık verilir. Sonra bu ağırlıklı veri üzerinde basit bir açıklayıcı model $g$ eğitilir. Kavramsal optimizasyon şöyledir:
\[\xi(x_0)=\arg\min_{g \in G}\; \mathcal{L}(f,g,\pi_{x_0}) + \Omega(g)\]Burada $\mathcal{L}$, basit modelin karmaşık modeli yerel bölgede ne kadar iyi taklit ettiğini; $\pi_{x_0}$ yakınlık ağırlıklarını; $\Omega(g)$ ise açıklamanın karmaşıklığını temsil eder. Amaç yalnızca doğru taklit değil, aynı zamanda az sayıda ve okunabilir kuralla açıklama üretmektir.
| Kavram | Karmaşık ana model $f$ | LIME açıklayıcısı $g$ |
|---|---|---|
| Kapsam | Tüm veri uzayı | $x_0$ çevresindeki bölge |
| Öncelik | Tahmin başarımı | İnsan tarafından yorumlanabilirlik |
| Örnek model | Random Forest, CNN, Transformer | Seyrek lineer model, küçük ağaç |
| Çıktı | Sınıf veya skor | Özellik katkıları ve yerel gerekçe |
Python ile tablo verisi örneği
Aşağıdaki örnek, eğitilmiş bir Random Forest modelinin tek bir test kaydı için hangi özelliklerden etkilendiğini gösterir. LimeTabularExplainer, sayısal değişkenlerin eğitim dağılımını kullanarak anlamlı komşular üretir.
from lime.lime_tabular import LimeTabularExplainer

explainer = LimeTabularExplainer(
    training_data=X_train.values,
    feature_names=X_train.columns.tolist(),
    class_names=["Reddedildi", "Onaylandı"],
    mode="classification"
)

kayit = X_test.iloc[0].values
aciklama = explainer.explain_instance(
    data_row=kayit,
    predict_fn=model.predict_proba,
    num_features=5
)

print(aciklama.as_list())
aciklama.show_in_notebook()
as_list() çıktısı örneğin “gelir > 50.000” koşulunun onay sınıfını pozitif, “gecikmiş ödeme sayısı > 2” koşulunun ise negatif etkilediğini gösterebilir. Buradaki katsayılar küresel özellik önemleri değildir; yalnızca seçilen kaydın yakınındaki karar mantığını anlatır.
Güçlü yanlar ve dikkat edilmesi gerekenler
LIME hızlı, modelden bağımsız ve görsel olarak anlaşılırdır. Buna karşılık sentetik örnekleme rastgelelik içerdiğinden aynı kayıt için farklı çalıştırmalarda küçük değişimler görülebilir. Ayrıca veri uzayında gerçekte mümkün olmayan komşular üretmek, açıklamayı yanıltabilir. Örneğin yaş ile meslek arasında gerçek hayatta güçlü bir ilişki varken bu değişkenleri bağımsız oynatmak risklidir.
| Durum | LIME için öneri |
|---|---|
| Açıklama kararsız görünüyor | Farklı random_state değerleriyle sonuçları karşılaştırın |
| Çok fazla özellik var | num_features değerini azaltıp seyrek açıklama isteyin |
| Özellikler bağımlı | Alan bilgisiyle üretilen komşuların gerçekçiliğini denetleyin |
| Küresel davranış merak ediliyor | LIME’ı SHAP, PDP veya permütasyon önemleriyle tamamlayın |
Özetle LIME, “model genel olarak ne yapıyor?” sorusundan çok “bu tahmin neden çıktı?” sorusunun aracıdır. Kritik karar sistemlerinde onu nihai gerçek olarak değil; veri kalitesi, adalet analizleri ve alternatif açıklama yöntemleriyle birlikte kullanılan yerel bir inceleme aracı olarak değerlendirmek en sağlıklı yaklaşımdır.
Yorumlar