İçindekiler
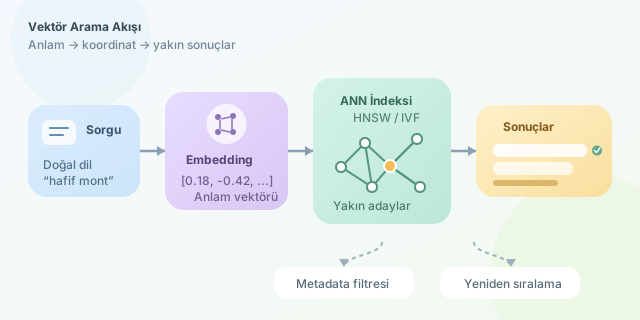
Bir ürün kataloğunda “kırmızı spor ayakkabı” aramak kolaydır; ancak “yağmurlu havada şehir yürüyüşüne uygun hafif bir şey” demek, klasik anahtar kelime aramasını zorlar. Vektör veritabanları tam burada devreye girer: metin, görsel, ses veya davranış verisini anlamı temsil eden sayısal koordinatlara dönüştürür ve birbirine en yakın kayıtları milisaniyeler içinde bulur. ``
Embedding: Anlamın koordinatları
Vektör veritabanının temel girdisi embedding adı verilen sayısal dizidir. Bir embedding modeli, örneğin bir cümleyi 768 ya da 1.536 boyutlu bir vektöre çevirir. Model eğitim sırasında benzer bağlamları yakın, ilgisiz bağlamları uzak konumlandırmayı öğrenir. Böylece “kedi bakımı” ile “evcil hayvan sağlığı” salt kelimeleri aynı olmasa bile komşu olabilir.
Bir kaydın yalnızca vektörü tutulmaz. Genellikle özgün metin, belge kimliği, tarih, kullanıcı yetkisi ve kategori gibi metadata alanları da saklanır. Arama anında önce anlam yakınlığı hesaplanır, ardından metadata filtresi uygulanabilir: “Sadece Türkçe, 2025 sonrası ve premium kullanıcının görebileceği belgeler.”
Yakınlık hangi matematikle ölçülür?
İki vektör arasındaki ilişki için yaygın metrikler aşağıdadır. $q$ sorgu vektörü, $x$ ise veri vektörü olsun:
| Metrik | Formül | Ne zaman uygundur? |
|---|---|---|
| Kosinüs benzerliği | $\cos(\theta)=\frac{q\cdot x}{\vert q\vert \vert x\vert }$ | Yönün, yani anlamsal ilişkinin önemli olduğu metin aramalarında |
| Öklid uzaklığı | $d(q,x)=\sqrt{\sum_i(q_i-x_i)^2}$ | Vektör büyüklüğünün de anlam taşıdığı uzaylarda |
| İç çarpım | $q\cdot x$ | Bazı öneri sistemleri ve modele özgü embeddinglerde |
Kosinüs benzerliğinde değer 1’e yaklaştıkça yönler benzerdir. Ancak kritik kural şudur: Sorgu ve veri vektörleri aynı embedding modeliyle üretilmeli, seçilen mesafe metriği de modelin önerisiyle uyumlu olmalıdır. Aksi halde pusulayla termometreyi karşılaştırmış olursunuz.
Neden her vektörle tek tek karşılaştırmıyoruz?
Tam (exact) arama, sorguyu tüm $N$ vektörlerle karşılaştırır. Bu yaklaşım doğru sonucu garanti eder; fakat maliyeti yaklaşık $O(Nd)$’dir. Burada $d$, vektör boyutudur. Milyonlarca kayıt ve binlerce boyut söz konusu olduğunda bu maliyet can sıkıcıdır.
Bu yüzden modern sistemler yaklaşık en yakın komşu (ANN) indeksleri kullanır. HNSW, vektörleri farklı katmanlarda komşuluk grafiğine bağlar; arama üst katmanlarda büyük sıçramalar yapıp alt katmanlarda hassaslaşır. IVF ise uzayı kümelere böler, sorgunun yakınındaki birkaç kümeyi tarar. Hız karşılığında çok küçük bir “en iyi sonucu kaçırma” olasılığı kabul edilir.
| Yaklaşım | Avantaj | Bedel |
|---|---|---|
| Exact search | En yüksek doğruluk | Büyük veri kümelerinde yavaş |
| HNSW | Düşük gecikme, yüksek geri çağırım | Bellek tüketimi ve ekleme maliyeti |
| IVF | Büyük koleksiyonlarda ölçeklenebilir | Küme ayarlarına hassas |
Basit bir arama akışı
Aşağıdaki Python örneği, bir istemcinin tipik işleyişini gösterir. Gerçek projede embed() bir model API’si veya yerel transformer çağrısı olur.
query = "kamp için su geçirmez hafif mont"
query_vector = embed(query)  # Metni sayısal anlamsal temsile dönüştürür.

results = collection.search(
    vector=query_vector,
    limit=5,
    filter={"language": "tr", "stock": True}
)

for item in results:
    print(item["score"], item["metadata"]["title"])
Sistem önce sorguyu embedding’e dönüştürür, ANN indeksiyle adayları bulur, filtreleri uygular ve en alakalı sonuçları döndürür. Daha kaliteli sonuç için ilk 20 adayı bir reranker modele verip en iyi 5 sonucu yeniden sıralamak da yaygındır.
Vektör veritabanları SQL’in rakibi değildir; çoğu zaman tamamlayıcısıdır. SQL kesin koşulları, vektör arama ise belirsiz insan niyetini yakalar. İkisini birlikte kullanmak, hem “fiyatı 2.000 TL altı” kadar net hem de “minimalist ve seyahat dostu” kadar insani aramalar üretir.
Yorumlar