Bir makine öğrenmesi projesinde zor olan yalnızca yüksek doğruluk üreten modeli bulmak değildir; hangi veriyle, hangi parametrelerle ve hangi kod sürümüyle üretildiğini aylar sonra da kanıtlayabilmektir. MLflow, deney kayıtlarını, model dosyalarını ve dağıtıma uygun sürümleri aynı izlenebilir akışta toplayarak bu karmaşayı yönetir. Böylece “not defterimde çalışıyordu” cümlesi, yerini ölçülebilir ve tekrarlanabilir bir sürece bırakır.
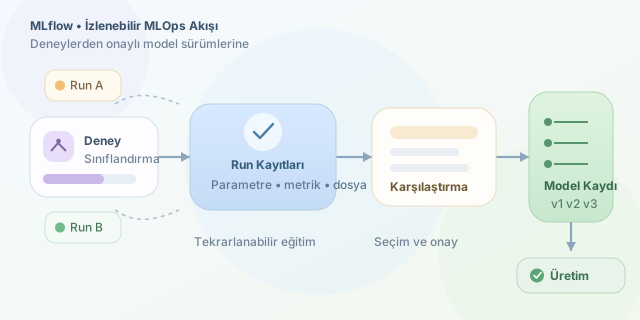
`` MLflow’un temel fikri, bir model eğitimini run adı verilen kayıt altına alınmış bir olay olarak ele almaktır. Bir run; parametreleri, metrikleri, etiketleri ve üretilen dosyaları (artifact) içerir. Birden fazla run ise bir experiment altında gruplanır. Bu yapı, aynı problemi farklı algoritmalarla veya hiperparametrelerle çözmeye çalışırken son derece kullanışlıdır.
Teorik olarak bir sınıflandırıcının başarısını yalnızca accuracy ile değerlendirmek risklidir. Özellikle sınıflar dengesizse precision ve recall birlikte okunmalıdır:
\[Precision = \frac{TP}{TP + FP}, \qquad Recall = \frac{TP}{TP + FN}\]MLflow bu metrikleri her eğitim çalışması için saklar. Böylece en yüksek accuracy değerine sahip modelin, düşük recall nedeniyle kritik örnekleri kaçırıp kaçırmadığını karşılaştırabilirsiniz.
| Kavram | MLflow karşılığı | Pratik fayda |
|---|---|---|
| Eğitim denemesi | Run | Tek bir eğitimin tüm izlerini saklar |
| Deneme koleksiyonu | Experiment | Aynı iş problemindeki çalışmaları ayırır |
| Dosya çıktısı | Artifact | Model, grafik, veri şeması ve rapor tutar |
| Yayınlanabilir model | Registered Model | Onaylı model sürümlerini merkezileştirir |
İlk adımda mlflow paketini kurup bir deney adı belirlemek yeterlidir. Aşağıdaki örnek, Scikit-learn ile eğitilen bir lojistik regresyon modelinin parametrelerini, metriklerini ve model nesnesini kaydeder. Kodun amacı sadece skor üretmek değil, skorun arkasındaki koşulları da kalıcı hâle getirmektir.
import mlflow
import mlflow.sklearn
from sklearn.datasets import load_iris
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

X, y = load_iris(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

mlflow.set_experiment("iris-siniflandirma")

with mlflow.start_run():
    c = 1.0
    model = LogisticRegression(C=c, max_iter=300)
    model.fit(X_train, y_train)

    accuracy = accuracy_score(y_test, model.predict(X_test))
    mlflow.log_param("C", c)
    mlflow.log_metric("accuracy", accuracy)
    mlflow.sklearn.log_model(model, "model")
Çalıştırma sonrasında mlflow ui komutu ile arayüzü açabilirsiniz. Arayüz, run’ları tablo biçiminde karşılaştırır; parametre filtreleri sayesinde örneğin C=0.1 ve C=1.0 denemelerinin metrik farkını hızla görürsünüz. Ayrıca confusion matrix görselini PNG olarak artifact şeklinde kaydetmek, sayısal sonuçlara görsel bağlam ekler.
Deney takibi ile model kaydı aynı şey değildir. Deney takibi araştırma alanıdır; model kaydı ise seçilmiş çıktının yaşam döngüsüdür. Başarılı modeli kayıt altına almak için model URI’siyle bir kayıt oluşturulabilir:
result = mlflow.register_model(
    "runs:/RUN_ID/model",
    "iris-uretim-modeli"
)
print(result.version)
| Yaklaşım | Ne zaman yeterli? | Eksik kalan nokta |
|---|---|---|
Dosyayı model.pkl olarak saklamak |
Kişisel, küçük denemeler | Köken ve onay süreci belirsizdir |
| Sadece deney metriklerini kaydetmek | Araştırma aşaması | Üretim sürümü yönetilemez |
| MLflow Model Registry kullanmak | Ekip ve üretim ortamları | Süreç disiplini gerektirir |
Model Registry, aynı model adına bağlı 1, 2, 3 gibi sürümler üretir. Her sürüme açıklama, etiket ve doğrulama notu eklemek; “hangi model canlıda?” sorusunu tahmin olmaktan çıkarır. Üretime alma kararında yalnızca performansı değil, eğitim veri tarihi, kütüphane sürümleri ve sorumlu kişi gibi bilgileri de etiketleyin. MLflow bu disiplinin sihirli değneği değil, güvenilir kayıt defteridir; değerini ise ekibin düzenli kayıt alışkanlığı belirler.
Yorumlar