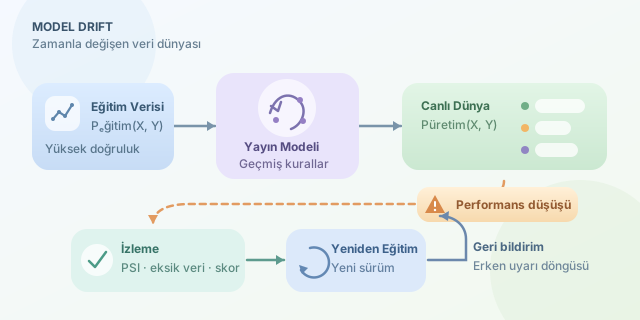
Bir makine öğrenmesi modelini yayına almak, yarışın bitiş çizgisi değil; aslında başlangıç tabancasıdır. Eğitim verisinde %95 doğruluk yakalayan bir dolandırıcılık, öneri ya da tahmin modeli, birkaç ay sonra beklenmedik biçimde hatalı kararlar vermeye başlayabilir. Bu olaya model drift denir: Modelin üretim ortamındaki performansının, zaman içinde eğitim dönemindeki performansından anlamlı biçimde uzaklaşmasıdır.
Devamı...
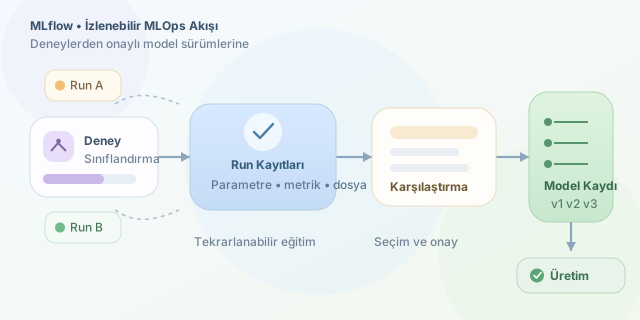
Bir makine öğrenmesi projesinde zor olan yalnızca yüksek doğruluk üreten modeli bulmak değildir; hangi veriyle, hangi parametrelerle ve hangi kod sürümüyle üretildiğini aylar sonra da kanıtlayabilmektir. MLflow, deney kayıtlarını, model dosyalarını ve dağıtıma uygun sürümleri aynı izlenebilir akışta toplayarak bu karmaşayı yönetir. Böylece “not defterimde çalışıyordu” cümlesi, yerini ölçülebilir ve tekrarlanabilir bir sürece bırakır.
Devamı...
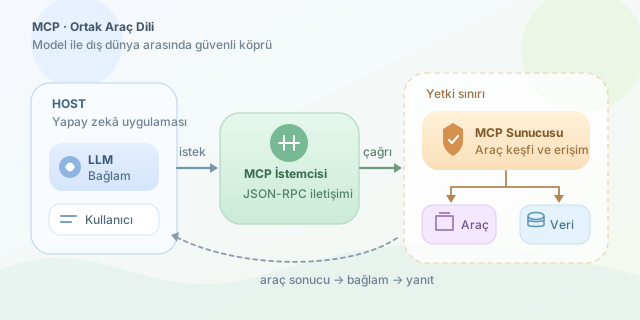
Büyük dil modelleri metin üretmekte çok başarılıdır; ancak tek başlarına takviminize bakamaz, veritabanınızdan müşteri kaydı çekemez veya GitHub’daki bir depoyu analiz edemezler. Bu noktada MCP (Model Context Protocol), yapay zekâ uygulamalarının harici araçlar ve veri kaynaklarıyla güvenli, düzenli ve standart bir biçimde konuşmasını sağlayan açık bir protokol olarak devreye girer.
Devamı...
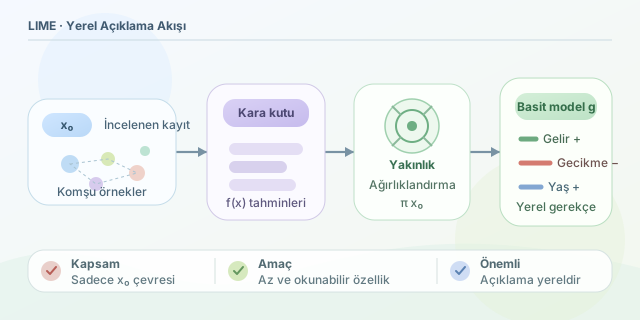
Derin öğrenme ve ansambl yöntemleri yüksek doğruluk sağlayabilir; fakat bir müşterinin kredi başvurusunun neden reddedildiğini ya da bir görselin neden “kedi” olarak etiketlendiğini açıklamak çoğu zaman zordur. LIME (Local Interpretable Model-agnostic Explanations), bu kara kutu hissini tamamen ortadan kaldırmasa da tek bir tahminin çevresine güçlü bir el feneri tutar: Karmaşık modelin belirli bir örnek için nasıl karar verdiğini, anlaşılabilir basit bir modelle yaklaşık olarak açıklar.
Devamı...
Bir yazılımın mutlu yolunda çalışması, onun her koşulda güvenli olduğu anlamına gelmez. Kullanıcıların boş metin, devasa dosya, bozuk karakter kodlaması veya beklenmeyen veri türleri gönderebildiği gerçek dünyada asıl sorunlar köşe durumlarda yaşanır. Fuzz testing ya da kısa adıyla fuzzing, uygulamalara otomatik biçimde sıra dışı, hatalı veya rastgele girdiler göndererek çökmeleri, istisnaları ve güvenlik açıklarını bulma disiplinidir. Bir bakıma yazılımınıza kontrollü kaos yaşatırsınız.
Devamı...
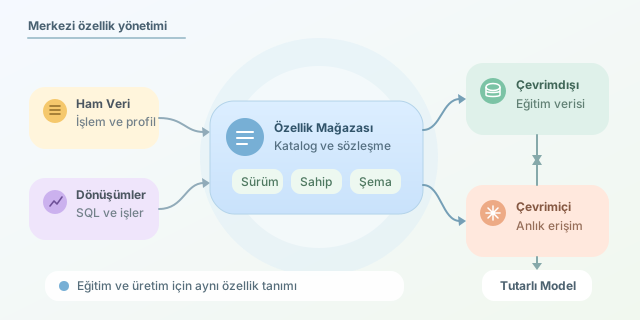
Makine öğrenmesi projelerinde model seçimi çoğu zaman sahnenin yıldızı gibi görünür; ancak gerçek hayatta performansı belirleyen oyuncu genellikle verilerdir. Özellikle özellikler (feature) farklı ekipler, SQL sorguları, notebook’lar ve üretim servisleri arasında dağınıksa aynı müşteri yaşı, satın alma toplamı veya risk puanı birbirinden farklı hesaplanabilir. Feature Store, bu karmaşayı azaltmak için özellikleri merkezi, tekrar kullanılabilir, izlenebilir ve güvenilir biçimde yöneten veri platformu katmanıdır.
Devamı...
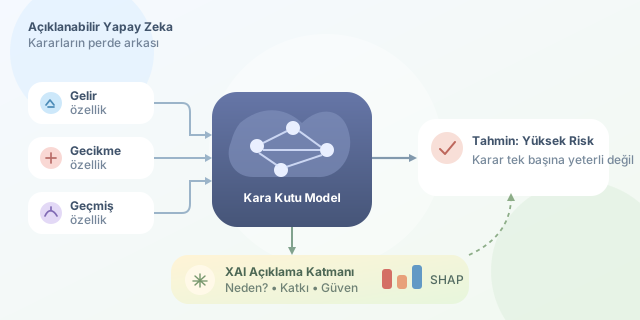
Bir kredi başvurusunun neden reddedildiğini, bir görüntünün neden “kedi” olarak sınıflandırıldığını veya bir tıbbi modelin neden yüksek risk uyarısı verdiğini bilmek isteriz. Klasik makine öğrenmesi modelleri çoğu zaman yüksek doğruluk sunarken karar süreçlerini gizleyen birer “kara kutu” gibi davranır. Explainable AI (XAI), yani Açıklanabilir Yapay Zeka, bu kutunun kapağını aralayarak modelin hangi verilere, hangi yönde ve ne kadar ağırlık vererek karar aldığını anlaşılır hale getiren yöntemler bütünüdür.
Devamı...
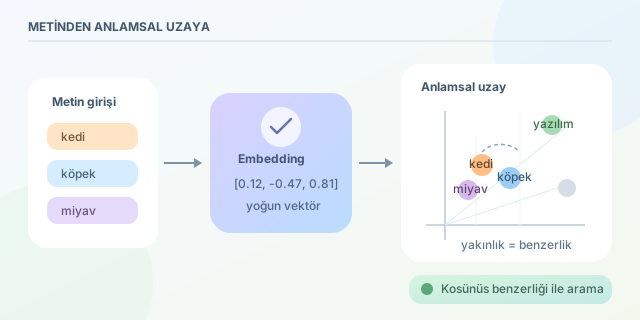
Bilgisayarlar için “kedi” ile “köpek” kelimeleri, ilk bakışta yalnızca farklı karakter dizileridir. Oysa insan zihni ikisinin de hayvan olduğunu, “kedi” ile “miyav” arasında güçlü bir ilişki bulunduğunu sezebilir. Embedding (gömme), metin, kelime, cümle ya da belge gibi verileri; bu anlamsal ilişkileri korumaya çalışan sayısal vektörlere dönüştürme yöntemidir. Böylece arama motorları, öneri sistemleri ve yapay zekâ uygulamaları metnin yalnızca yazılışını değil, yaklaşık anlamını da karşılaştırabilir.
Devamı...
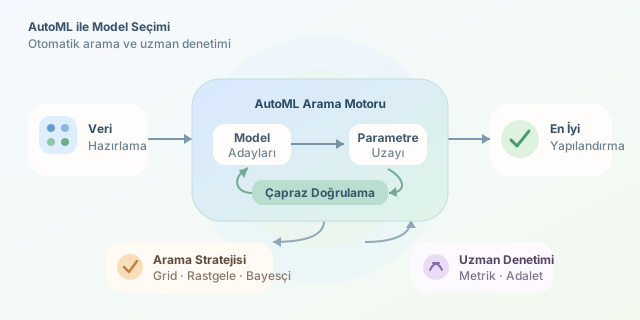
Makine öğrenmesi projelerinde en zor kısım çoğu zaman modeli eğitmek değil, hangi modeli denemek gerektiğine ve bu modelin ayarlarının nasıl yapılacağına karar vermektir. Karar ağacı mı, gradyan artırma mı, yoksa lojistik regresyon mu? Öğrenme oranı kaç olmalı? İşte AutoML (Automated Machine Learning), bu tekrar eden deneme-yanılma döngüsünü akıllı bir otomasyona dönüştürür. Amaç, veri bilimcisini ortadan kaldırmak değil; onu sonsuz parametre ayarı ekranından kurtarmaktır.
Devamı...
Tek bir büyük dil modeli etkileyici cevaplar üretebilir; ancak gerçek dünyadaki işler çoğunlukla araştırma, planlama, araç kullanımı, doğrulama ve raporlama gibi farklı uzmanlıklar ister. Ajan tabanlı yapay zeka mimarisi, bu yükü tek bir modele bırakmak yerine rolleri belirlenmiş birden fazla ajana dağıtır. Bunu küçük ama disiplinli bir yazılım ekibi gibi düşünebilirsiniz: biri işi parçalar, biri veri toplar, diğeri sonucu test eder, bir başkası da son kararı gözden geçirir.
Devamı...
Mikro servis mimarisi büyüdükçe asıl zorluk yalnızca servis yazmak değildir; servislerin birbirini güvenli, hızlı ve gözlemlenebilir biçimde çağırmasını sağlamaktır. Service mesh, bu iletişim katmanını uygulama kodundan ayıran altyapı yaklaşımıdır. Böylece Java, Go, Python ya da Node.js ile yazılmış servisler; tekrar tekrar istemci kütüphanesi eklemeden ortak ağ politikalarından yararlanabilir.
Devamı...
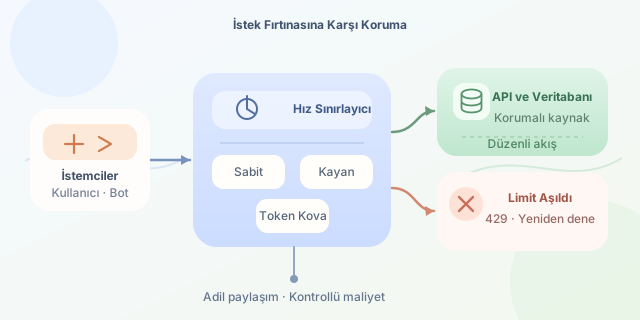
Bir API’nin başarısı bazen aldığı istek sayısıyla ölçülür; fakat kontrolsüz trafik, başarı hikâyesini saniyeler içinde kesinti raporuna dönüştürebilir. Rate limiting, belirli bir kullanıcı, IP adresi, API anahtarı veya uç nokta için kabul edilen istek miktarını sınırlayan savunma katmanıdır. Amaç yalnızca kötü niyetli botları engellemek değildir: adil kaynak paylaşımı sağlamak, maliyetleri öngörülebilir tutmak ve veritabanı gibi hassas bağımlılıkları korumaktır.
Devamı...
Dağıtık sistemlerde servislerin birbirini beklemeden iletişim kurması, hem performans hem de dayanıklılık için kritik önemdedir. RabbitMQ ve Apache Kafka bu ihtiyacı karşılayan iki güçlü araçtır; ancak aynı problemi farklı felsefelerle çözerler. Biri görev dağıtan hızlı bir postacı, diğeri ise olayların değişmez tarihçesini tutan dev bir günlük gibi düşünülebilir.
Devamı...
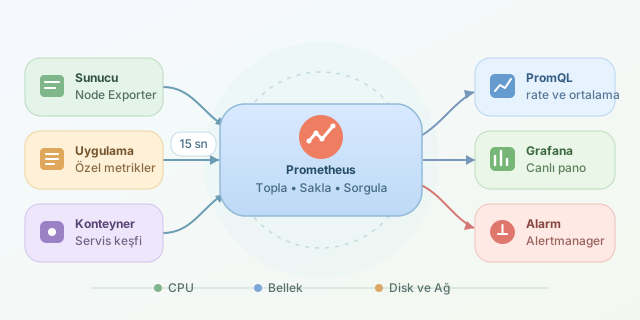
Bir sunucunun CPU kullanımı %95’e ulaştığında bunu kullanıcılar şikâyet etmeden önce görmek, modern operasyon ekiplerinin süper gücüdür. Prometheus; sunucular, uygulamalar ve konteynerler için zaman serisi verisi toplayan, sorgulayan ve alarm üreten açık kaynaklı bir izleme sistemidir. Temel hedefi basittir: “Şu anda ne oluyor, geçmişte ne oldu ve kötüye giderse bana kim haber verecek?” sorularını ölçülebilir verilerle yanıtlamak.
Devamı...
Dağıtık uygulamalarda bir isteğin nerede yavaşladığını bulmak, tek sunuculu günlerin rahatlığını özletebilir. Kullanıcı “sipariş ver” düğmesine basar; istek API ağ geçidinden ödeme servisine, stok servisine, kuyruk sistemine ve veritabanına uğrar. Hata ekranı ise yalnızca 500 döndürür. OpenTelemetry (OTel), bu karmaşık yolculuğu standart araçlarla görünür hâle getirerek izleme, hata ayıklama ve kapasite planlama süreçlerini aynı dilde buluşturur.
Devamı...
Bir API geliştirmek, yalnızca çalışan endpoint’ler yazmaktan ibaret değildir. Bu endpoint’lerin hangi veriyi beklediği, hangi yanıtları döndüğü, hata durumlarında nasıl davranacağı ve yetkilendirmenin nasıl yapılacağı da açıkça anlatılmalıdır. İşte OpenAPI ve Swagger, API geliştiricileri ile API tüketicileri arasındaki bu iletişim sorununu standartlaştırılmış, canlı ve test edilebilir bir sözleşmeye dönüştürür.
Devamı...
Yoğun trafikli bir web uygulamasında sorun çoğu zaman yalnızca sunucu işlemcisinin yetersiz olması değildir. Asıl mesele, her isteğin ne kadar kaynak tükettiği, bağlantıların nasıl yönetildiği ve statik içeriklerin uygulama katmanına uğramadan ne kadar hızlı servis edildiğidir. NGINX; olay güdümlü mimarisi, reverse proxy yetenekleri ve düşük bellek tüketimi sayesinde bu problemlerin çözümünde güçlü bir araçtır.
Devamı...
Kubernetes, konteynerleri çalıştırma işini oldukça iyi yapar; ancak veritabanı kümesi kurmak, yedek almak, sürüm yükseltmek veya arızalı bir düğümü güvenle değiştirmek gibi uygulamaya özgü işler daha fazla bilgi ister. Kubernetes Operatörü tam burada devreye girer: Bir uzmanın operasyonel bilgisini kodlayarak uygulamanın yaşam döngüsünü sürekli yöneten özel bir denetleyici oluşturur. Kısacası Operatör, YAML dosyalarınızın yanında nöbet tutan, yorulmayan bir SRE yardımcısıdır.
Devamı...
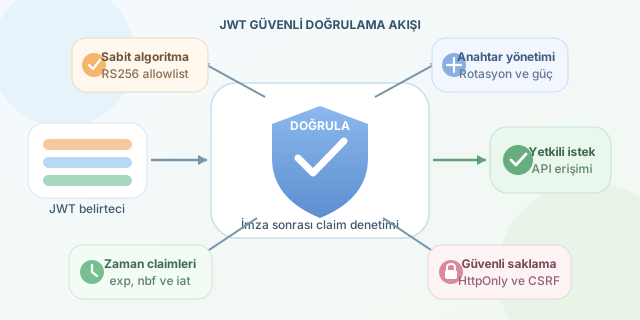
JWT’ler (JSON Web Token), oturum bilgisini sunucu yerine imzalı bir belirteçte taşıyarak ölçeklenebilir kimlik doğrulama sağlar. Ancak “imzalı” olması, token’ın otomatik olarak güvenli olduğu anlamına gelmez. Güvenlik; imza algoritması, anahtar yönetimi, claim doğrulaması, tarayıcıda saklama biçimi ve token yaşam döngüsünün birlikte doğru tasarlanmasına bağlıdır.
Devamı...
Dağıtık sistemlerde aynı HTTP isteğinin yalnızca bir kez ulaştığını varsaymak, yağmurda şemsiyesiz dolaşmak gibidir: bazen sorun çıkmaz, ama çıktığında ıslanırsınız. Ağ zaman aşımları, istemcinin otomatik yeniden denemesi ve kullanıcıların iki kez tıklaması; ödeme alma, sipariş oluşturma veya e-posta gönderme gibi işlemleri istemeden çoğaltabilir. İdempotent API tasarımı, aynı isteğin tekrar edilmesi hâlinde sistemin nihai durumunu güvenli biçimde korur.
Devamı...