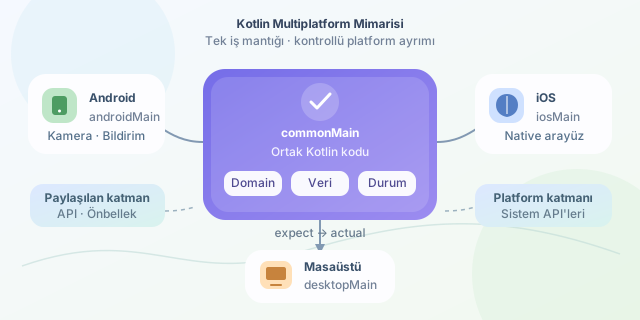
Android, iOS ve masaüstü için ayrı ekipler, ayrı iş listeleri ve aynı hatanın üç farklı yerde düzeltilmesi… Tanıdık bir senaryoysa Kotlin Multiplatform (KMP) güçlü bir çıkış noktasıdır. KMP, uygulamanın iş mantığını tek bir ortak modülde yazıp Android, iOS, Windows, macOS ve Linux hedeflerine derlemenizi sağlar. Amaç “her şeyi sihirli biçimde tek seferde yazmak” değil; tekrar eden mantığı merkezileştirip platforma özgü katmanları kontrollü biçimde ayırmaktır.
Devamı...
Yılan oyunu, küçük görünmesine rağmen oyun programlamasının en önemli sorularını barındırır: Zaman nasıl ilerler, klavye girdisi nasıl alınır, rastgele yem nereye çıkar ve ekran nasıl çizilir? Haskell bu sorulara ilginç bir ayrım getirir: Oyunun kuralları saf fonksiyonlarda yaşar; klavye, saat, rastgelelik ve terminal gibi dış dünya ayrıntıları ise kontrollü biçimde IO içinde tutulur. Böylece test edilebilir, tahmin edilebilir ve genişletilebilir bir oyun döngüsü elde ederiz.
Devamı...
Bir görüntü sınıflandırıcısının yüksek doğruluk vermesi, onun güvenli olduğu anlamına gelmez. İnsan gözüne neredeyse görünmez küçük piksel değişimleri, bir modelin “kedi” gördüğü görüntüyü büyük bir özgüvenle “uçak” diye etiketlemesine yol açabilir. Bu olaya karşıt örnek denir. Özellikle güvenlik kamerası, tıbbi görüntüleme ve otonom sistemler gibi alanlarda mesele yalnızca test doğruluğu değil, modelin kasıtlı olarak zorlanmış girdiler karşısındaki davranışıdır.
Devamı...
Graf sinir ağları (GNN), kullanıcılar, ürünler, makaleler veya moleküller gibi ilişkili nesneleri öğrenmek için düğüm özelliklerini bağlantı yapısıyla birleştirir. Düğüm sınıflandırmada amaç her düğüme bir etiket vermek; bağlantı tahmininde ise iki düğüm arasında yeni ya da eksik bir kenar olup olmadığını kestirmektir. GCN, GraphSAGE ve GAT aynı sahnede oynasa da bilgiyi komşulardan toplama biçimleri oldukça farklıdır.
Devamı...
Bir sınıfa ait yüzlerce, hatta binlerce etiketli örnek bulmak her zaman mümkün değildir. Tıbbi görüntüler, nadir hata kayıtları veya yeni ürün kategorileri gibi alanlarda modelin sadece birkaç örnekle öğrenmesi gerekir. Few-shot learning, tam olarak bu kısıtta genelleme yapmayı hedefler. Prototip ağları (Prototypical Networks) ise sınıfları karmaşık karar sınırlarıyla ezberlemek yerine, her sınıfı temsil eden bir “merkez” öğrenerek bu işi şaşırtıcı derecede zarif biçimde yapar.
Devamı...
Bir uygulamayı Android, iOS, web ve masaüstünde çalıştırmak eskiden ayrı ekipler, ayrı kod tabanları ve bolca senkronizasyon toplantısı anlamına gelirdi. Flutter bu tabloyu değiştirmeyi hedefler: Dart ile yazılan tek bir arayüz kodu, farklı platformlarda yerel hissi veren deneyimlere dönüşür. Üstelik mesele yalnızca “bir kere yaz, her yerde çalıştır” değildir; Flutter’ın güçlü çizim altyapısı sayesinde geçişler, mikro etkileşimler ve karmaşık animasyonlar da tutarlı biçimde üretilebilir.
Devamı...
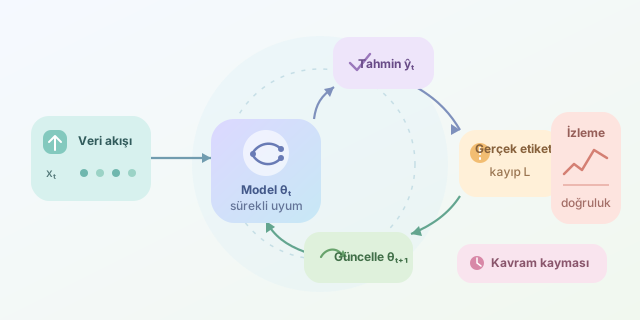
Bir makine öğrenmesi modelini bir kez eğitip sonsuza dek görev başında bırakmak, dünün hava durumuyla bugün şemsiye seçmeye benzer. Gerçek dünyadaki veriler; kullanıcı tercihleri, dolandırıcılık yöntemleri, sensör ölçümleri ve piyasa davranışlarıyla birlikte sürekli değişir. Çevrimiçi öğrenme (online learning), modelin tüm geçmiş veriyi yeniden işlemeye ihtiyaç duymadan yeni gözlemler geldikçe kendini küçük adımlarla güncellemesini sağlar.
Devamı...
Bir oyunun tüm kurallarını C++ ile derlemek hızlıdır; ancak zıplama yüksekliği, düşman davranışı veya görev ödülleri için her değişiklikte motoru yeniden derlemek üretim hızını düşürür. Lua, hafif çalışma zamanı ve sade sözdizimiyle bu sorunu çözer: performans kritik çekirdek C++ içinde kalırken, tasarımcıların sık değiştirdiği oyun mantığı betiklere taşınır.
Devamı...
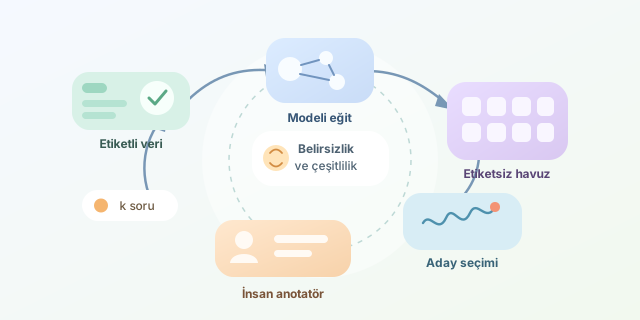
Etiketli veri, makine öğrenmesinin kahvesidir: model onsuz güne başlayamaz. Fakat gerçek hayatta her örneği uzmanlara etiketletmek pahalı, yavaş ve bazen de oldukça sıkıcıdır. Aktif öğrenme (active learning), elinizde küçük bir etiketli küme ve büyük bir etiketsiz havuz varken modele söz hakkı verir: Model, öğrenmesine en fazla katkıyı sağlayacak örneklerin etiketini ister. Ama kritik soru şudur: Modelin hangi örnekleri sormasına izin vermeliyiz?
Devamı...
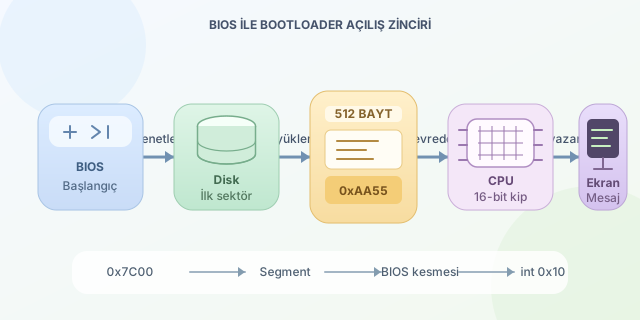
Bir bilgisayarın açılışında işletim sistemi henüz sahnede değildir: ekran kartına görüntü çizdirecek sürücüler, dosya sistemi ve hatta bellek yöneticisi yoktur. Buna rağmen işlemci birkaç talimat çalıştırarak makineyi hayata döndürür. Bootloader yazmak, bu minimal ortamda BIOS, disk ve CPU ile doğrudan konuşmayı öğrenmektir. Küçücük bir 512 baytlık programla ekrana mesaj basmak, donanım ile işletim sistemi arasındaki köprünün ilk tahtasını yerleştirmek gibidir.
Devamı...
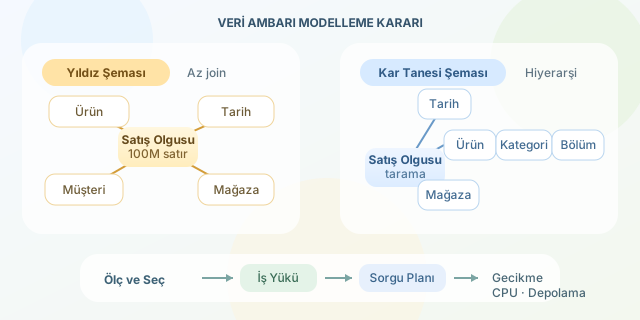
Veri ambarı tasarımında en tartışmalı kararlardan biri, boyut tablolarını sade bırakıp yıldız şeması kullanmak mı, yoksa onları alt tablolara ayırıp kar tanesi şeması ile normalize etmek mi sorusudur. Bu tercih yalnızca diyagramın estetiğini değil; disk tüketimini, ETL akışını, sorgu planını ve analistlerin bekleme süresini doğrudan etkiler. Sağlıklı bir karar için sezgilere değil, temsilî iş yüküyle yapılan modelleme çalışmasına ihtiyaç vardır.
Devamı...
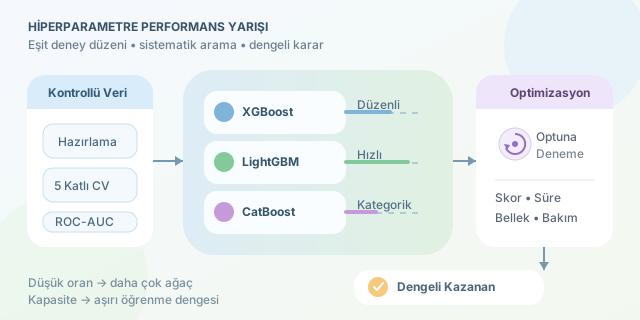
Gradient boosting ailesi, tabular verilerdeki güçlü performansıyla veri biliminin Formula 1 aracı gibidir: doğru ayarlarla inanılmaz hızlıdır, yanlış ayarla ise duvara çarpması kolaydır. XGBoost, LightGBM ve CatBoost aynı temel fikri paylaşsa da ağaçları büyütme stratejileri, kategorik veriye yaklaşımları ve düzenlileştirme seçenekleri farklıdır. Bu nedenle adil bir karşılaştırma, varsayılan parametrelerle değil; kontrollü veri hazırlama, çapraz doğrulama ve sistematik hiperparametre optimizasyonu ile yapılmalıdır.
Devamı...
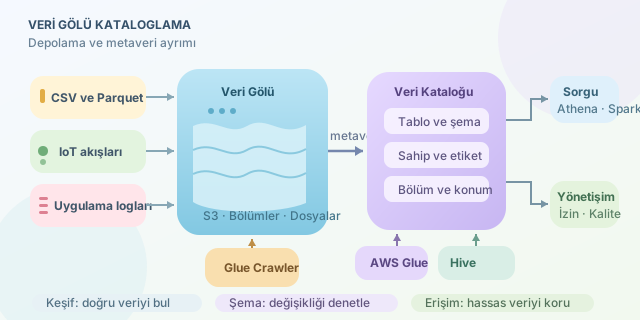
Veri gölü, ham CSV dosyalarından IoT akışlarına, Parquet tablolarından uygulama loglarına kadar farklı kaynakları düşük maliyetle saklar. Fakat klasörler büyüdükçe klasik “dosya nerede?” yaklaşımı hızla yetersiz kalır. Veri kataloglama; dosyaların fiziksel konumunu, şemasını, sahipliğini, etiketlerini ve kullanım kurallarını merkezi bir envantere dönüştürür. Böylece analistler doğru veriyi bulur, veri mühendisleri aynı tabloyu tekrar üretmez, yönetişim ekipleri ise erişimi denetlenebilir biçimde yönetir.
Devamı...
Bulut altyapısını elle yönetmek, ilk birkaç sunucuda masum görünür; fakat dev, test ve prod ortamları çoğaldıkça aynı güvenlik grubu, ağ ve veritabanı ayarlarını kopyalamak hızla bir bakım kabusuna dönüşür. Terraform modülleri bu sorunu, altyapı bileşenlerini parametre alan küçük ve tekrar kullanılabilir paketlere dönüştürerek çözer. Böylece ekipler aynı mimari standardı her ortamda korurken, yalnızca ortama özgü değerleri değiştirir.
Devamı...
Tek bir makine öğrenmesi modeli her zaman yıldız oyuncu olmayabilir; bazen farklı yeteneklere sahip modelleri aynı takımda oynatmak daha iyi sonuç verir. Süper öğrenme ya da yaygın adıyla stacking, birden fazla temel modelin tahminlerini yeni bir modelin girdisi haline getirir. Amaç, modellerin güçlü yanlarını birleştirirken birbirlerinin hatalarını dengelemektir. Örneğin doğrusal bir model genel eğilimi yakalarken, ağaç tabanlı bir model karmaşık ve doğrusal olmayan ilişkileri keşfedebilir.
Devamı...
Bir kullanıcıya yeni sipariş, mesaj, fiyat değişimi veya sistem alarmı ulaştırmak istediğinizde klasik HTTP istek-cevap modeli yetersiz kalır. Tarayıcının sürekli “Yeni bir şey var mı?” diye sorması hem gecikme hem de gereksiz sunucu yükü üretir. SSE (Server-Sent Events) ve WebSocket, sunucu ile istemci arasındaki bağlantıyı canlı tutarak bu sorunu çözer; fakat aynı probleme farklı yönlerden yaklaşırlar.
Devamı...
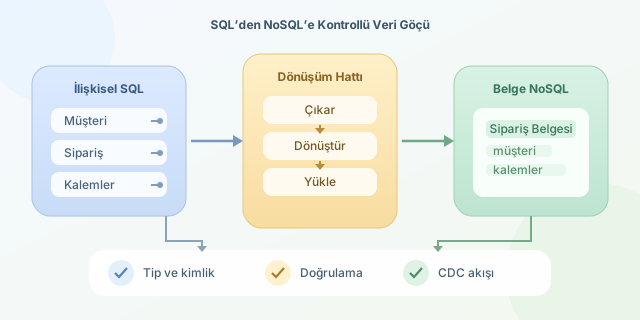
SQL ve NoSQL arasında veri göçü, yalnızca bir tablodan diğerine kayıt kopyalamak değildir; veri modelinin dünyayı yorumlama biçimini değiştirmektir. İlişkisel sistemler tutarlılığı tablolar, anahtarlar ve kısıtlarla korurken; NoSQL sistemleri ölçeklenebilirlik, esnek şema ve erişim desenlerini öne çıkarır. Bu nedenle başarılı bir göçün temel sorusu “Veriyi nasıl taşırım?” değil, “Uygulama bu veriyi hangi sorgularla kullanacak?” olmalıdır.
Devamı...
Veri sıkıştırma, disk alanını azaltmaktan çok daha fazlasıdır: ağ maliyeti, önbellek verimliliği, yedekleme süresi ve işlemci tüketimi arasında yapılan bir pazarlıktır. Snappy, Zstd ve Gzip bu pazarlığın üç farklı karakteridir. Snappy mümkün olan en düşük gecikmeye odaklanır, Gzip köklü ve yaygın uyumluluğu temsil eder, Zstd ise modern donanımlarda hem yüksek hız hem de güçlü oran hedefler. Sağlıklı bir seçim için ezbere değil, temsilî verinizle ölçüme ihtiyaç vardır.
Devamı...
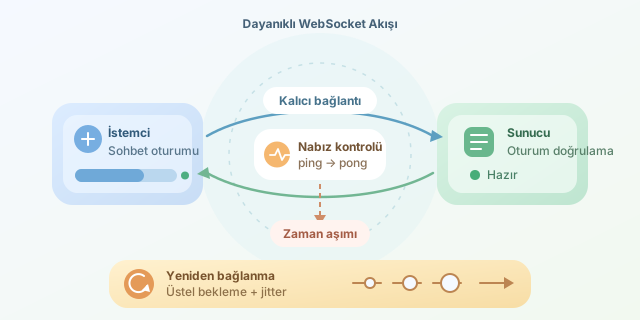
Gerçek zamanlı sohbet uygulamalarında kullanıcılar bağlantının her zaman açık kalmasını bekler. Ancak mobil ağ değişimleri, tarayıcının uykuya geçmesi, sunucu yeniden başlatmaları ve geçici paket kayıpları bu beklentiyi kolayca bozar. Sağlam bir WebSocket istemcisi, kopmayı bir hata sonu değil, yönetilmesi gereken normal bir durum olarak görür. Bu noktada iki temel araç devreye girer: yeniden bağlanma (reconnection) ve heartbeat, yani nabız kontrolü.
Devamı...
Mikroservis mimarisinde bir siparişin oluşturulması, ödemenin alınması ve stok rezervasyonu tek bir veritabanı işlemi değildir; her servis kendi verisine sahiptir. Klasik ACID transaction yaklaşımını servisler arasında yaymak hem pahalı hem de kırılgandır. Saga deseni, büyük işlemi yerel işlemlere böler ve bir adım başarısız olduğunda önceki adımları geri almak için telafi edici işlemler (compensating transactions) çalıştırır. Böylece sistem, anlık tutarlılık yerine kontrollü bir eventual consistency modeli benimser.
Devamı...