Bir görüntü sınıflandırıcısının yüksek doğruluk vermesi, onun güvenli olduğu anlamına gelmez. İnsan gözüne neredeyse görünmez küçük piksel değişimleri, bir modelin “kedi” gördüğü görüntüyü büyük bir özgüvenle “uçak” diye etiketlemesine yol açabilir. Bu olaya karşıt örnek denir. Özellikle güvenlik kamerası, tıbbi görüntüleme ve otonom sistemler gibi alanlarda mesele yalnızca test doğruluğu değil, modelin kasıtlı olarak zorlanmış girdiler karşısındaki davranışıdır.
``
Karşıt saldırıların temelinde modelin karar sınırları bulunur. Bir sınıflandırıcı, girdiyi $x$, gerçek etiketi $y$ ve parametreleri $\theta$ ile gösterildiğinde genellikle $f_\theta(x)$ fonksiyonu olarak yazılır. Saldırgan, girdiye küçük bir $\delta$ bozuntusu ekleyerek kaybı yükseltmeye çalışır:
\[\max_{\\vert \delta\\vert _\infty \leq \epsilon} \mathcal{L}(f_\theta(x + \delta), y)\]Buradaki $\epsilon$, değişikliğin büyüklüğünü sınırlar. FGSM saldırısında bu amaç için kaybın girişe göre gradyan işareti kullanılır: $x_{adv}=x+\epsilon\,\mathrm{sign}(\nabla_x\mathcal{L})$. PGD ise aynı fikri birçok küçük adımda uygular; bu nedenle savunmaları değerlendirmek için daha güçlü ve daha güvenilir bir başlangıç noktasıdır.
| Yaklaşım | Ana fikir | Güçlü yanı | Kritik risk |
|---|---|---|---|
| Gradient masking | Gradyan bilgisini yanıltmak veya zayıflatmak | Bazı basit saldırıları bozabilir | Gerçek dayanıklılığı gizleyebilir |
| Adversarial training | Eğitimde saldırılı örnek kullanmak | Güçlü beyaz-kutu saldırılara daha dirençli | Eğitim maliyeti ve temiz doğruluk kaybı |
| Standart eğitim | Yalnızca temiz veriyle öğrenmek | Hızlı ve basit | Küçük bozuntulara kırılgan |
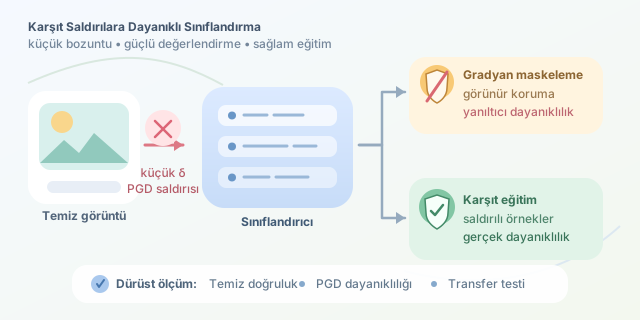
Gradient masking, adından dolayı ilk bakışta çekici görünür: Gradyanlar işe yaramazsa saldırgan yön bulamaz gibi düşünülür. Ancak bu çoğu zaman güvenlik değil, ölçüm hatasıdır. Savunma; gradyanı keskinleştiriyor, sayısal olarak kararsızlaştırıyor veya anlamsız hale getiriyorsa FGSM başarısız olabilir. Buna rağmen saldırgan, BPDA, EOT, transfer saldırıları ya da karar-temelli yöntemlerle engeli aşabilir. Dolayısıyla “tek adımlı saldırıya dayanıklı” sonucu, “gerçekten dayanıklı” anlamına gelmez.
Daha sağlam yaklaşım olan adversarial training, iç optimizasyonla üretilen saldırılı örnekleri eğitime dahil eder. Amaç artık temiz kaybı değil, bozuntu kümesindeki en kötü kaybı azaltmaktır:
\[\min_\theta\; \mathbb{E}_{(x,y)}\left[\max_{\\vert \delta\\vert _\infty\leq\epsilon}\mathcal{L}(f_\theta(x+\delta),y)\right]\]PyTorch ile basitleştirilmiş bir eğitim adımı aşağıdaki gibi kurulabilir. Kod, her mini-batch için kısa bir PGD saldırısı üretir ve modelin bu örneklerde öğrenmesini sağlar.
import torch
import torch.nn.functional as F

def pgd_attack(model, x, y, eps=8/255, alpha=2/255, steps=5):
    x_adv = x.detach() + torch.empty_like(x).uniform_(-eps, eps)
    x_adv = x_adv.clamp(0, 1)

    for _ in range(steps):
        x_adv.requires_grad_(True)
        loss = F.cross_entropy(model(x_adv), y)
        grad = torch.autograd.grad(loss, x_adv)[0]
        x_adv = x_adv.detach() + alpha * grad.sign()
        x_adv = torch.max(torch.min(x_adv, x + eps), x - eps).clamp(0, 1)
    return x_adv.detach()

# Eğitim döngüsünde: temiz x yerine saldırılı x_adv kullanılır
x_adv = pgd_attack(model, images, labels)
optimizer.zero_grad()
loss = F.cross_entropy(model(x_adv), labels)
loss.backward()
optimizer.step()
Deney tasarımında temiz doğruluk ile robust accuracy değerlerini birlikte raporlayın. Ayrıca saldırıyı eğitime kullanılan PGD adım sayısından daha güçlü ayarlarla tekrar edin. Savunmanız yalnızca zayıf FGSM altında iyi, fakat çok adımlı PGD altında çöküyorsa muhtemelen gradient masking etkisi görüyorsunuzdur.
| Ölçüm | Ne anlatır? | Sağlıklı yorum |
|---|---|---|
| Clean accuracy | Normal görüntülerde başarı | Tek başına yeterli değildir |
| PGD robust accuracy | Saldırılı görüntülerde başarı | Birden fazla $\epsilon$ ile ölçülmeli |
| Transfer başarısı | Başka modelden gelen saldırının etkisi | Maskelenmiş gradyanları yakalayabilir |
Sonuç olarak gradient masking bir savunma stratejisinden çok dikkat edilmesi gereken bir anti-pattern olarak ele alınmalıdır. Adversarial training ise pahalı olsa da açık tehdit modeli, güçlü saldırılar ve dürüst değerlendirme ile birleştirildiğinde görüntü sınıflandırıcılarını gerçekten daha dayanıklı hale getirmenin en pratik yollarından biridir.
Yorumlar