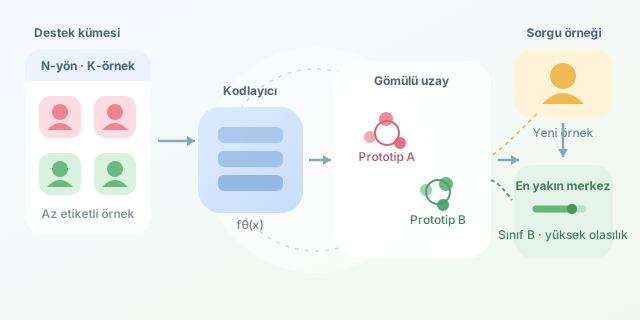
Bir sınıfa ait yüzlerce, hatta binlerce etiketli örnek bulmak her zaman mümkün değildir. Tıbbi görüntüler, nadir hata kayıtları veya yeni ürün kategorileri gibi alanlarda modelin sadece birkaç örnekle öğrenmesi gerekir. Few-shot learning, tam olarak bu kısıtta genelleme yapmayı hedefler. Prototip ağları (Prototypical Networks) ise sınıfları karmaşık karar sınırlarıyla ezberlemek yerine, her sınıfı temsil eden bir “merkez” öğrenerek bu işi şaşırtıcı derecede zarif biçimde yapar. ``
Temel fikir, her sınıf için destek kümesindeki (support set) örneklerin gömülü uzaydaki ortalamasını almaktır. Bu ortalama, sınıfın prototipidir. Sorgu kümesindeki (query set) yeni bir örnek, hangi prototipe daha yakınsa o sınıfa atanır. Böylece model, “Bu görüntü daha önce gördüğüm kedilere mi, yoksa köpeklere mi benziyor?” sorusunu ham piksel düzeyinde değil, öğrendiği anlamlı özellik uzayında yanıtlar.
Bir bölümde $N$ sınıf ve sınıf başına $K$ destek örneği olsun. Kodlayıcı ağımız $f_\theta(x)$ ile bir örneği vektöre dönüştürsün. $k$ sınıfının prototipi şu şekilde hesaplanır:
\[\mathbf{c}_k = \frac{1}{\vert S_k\vert }\sum_{(x_i, y_i) \in S_k} f_\theta(x_i)\]Sorgu örneği $x$ için sınıf olasılığı ise negatif uzaklıkların softmax’ı ile elde edilir:
\[p(y=k \mid x) = \frac{\exp(-d(f_\theta(x), \mathbf{c}_k))}{\sum_j \exp(-d(f_\theta(x), \mathbf{c}_j))}\]Buradaki kritik karakter benzerlik metriğidir. Kodlayıcı iyi olsa bile seçilen mesafe, küçük veri koşullarında sonucu ciddi biçimde değiştirebilir.
| Metrik | Formül | Güçlü yanı | Dikkat edilmesi gereken |
|---|---|---|---|
| Öklidyen | $\vert a-b\vert _2^2$ | Prototip ağlarının klasik ve kararlı seçeneği | Vektör büyüklüğüne duyarlıdır |
| Kosinüs | $1-\frac{a\cdot b}{\vert a\vert \vert b\vert }$ | Yön bilgisini öne çıkarır | Norm bilgisi kaybolabilir |
| Mahalanobis | $(a-b)^T\Sigma^{-1}(a-b)$ | Özelliklerin ölçek ve ilişkilerini hesaba katar | Kovaryans tahmini küçük veride kararsız olabilir |
Aşağıdaki PyTorch örneği, gömülmüş destek verilerinden prototip üretir ve sorguları kareli Öklidyen uzaklıkla sınıflandırır. Gerçek bir projede encoder, görüntüler için CNN veya metinler için bir Transformer olabilir.
import torch
import torch.nn.functional as F

def prototypical_logits(support_z, support_y, query_z, n_classes):
    # Her sınıfın embedding ortalamasını, yani prototipini oluşturur.
    prototypes = torch.stack([
        support_z[support_y == cls].mean(dim=0)
        for cls in range(n_classes)
    ])

    # [sorgu, sınıf] biçiminde kareli Öklidyen uzaklık matrisi.
    distances = ((query_z[:, None, :] - prototypes[None, :, :]) ** 2).sum(dim=-1)
    return -distances  # Softmax, yakın prototiplere yüksek olasılık verir.

logits = prototypical_logits(support_z, support_y, query_z, n_classes=3)
loss = F.cross_entropy(logits, query_y)
Genelleme yeteneğini gerçekten test etmek için eğitim ve değerlendirme sınıflarını ayırın. Örneğin model eğitimde A, B, C sınıflarını; testte daha önce hiç görmediği D, E, F sınıflarını görmelidir. Her deney bölümü için rastgele $N$-way $K$-shot destek kümesi ve ayrı sorgu kümesi oluşturun. Sonra doğruluğu birçok bölüm üzerinde ortalayın; tek bir bölüm, şanslı veya şanssız örneklerden etkilenebilir.
| Deney | Ne ölçer? | Beklenen yorum |
|---|---|---|
| 1-shot ve 5-shot karşılaştırması | Ek örneğin etkisi | 5-shot belirgin iyileşiyorsa prototipler daha güvenilirleşmiştir |
| Öklidyen ve kosinüs karşılaştırması | Geometri etkisi | Fark büyükse embedding normları bilgi taşıyor olabilir |
| Görülmemiş sınıflarda test | Gerçek few-shot başarısı | Eğitim sınıflarında yüksek skor tek başına yeterli değildir |
Son olarak, küçük veri mucize değildir: veri artırma, dengeli bölüm örneklemesi ve güven aralıkları önemlidir. Yine de prototip ağları, az veride ezber yerine ilişki öğrenmeyi teşvik eden net, hızlı ve güçlü bir başlangıç noktasıdır.
Yorumlar