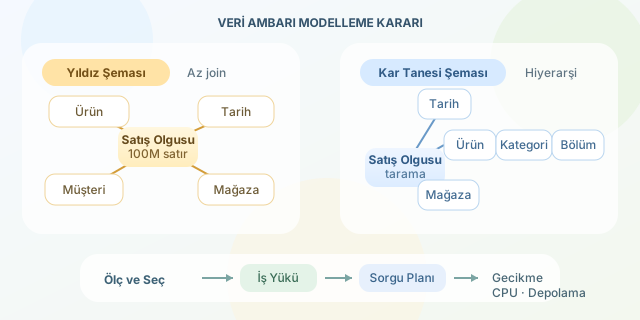
Veri ambarı tasarımında en tartışmalı kararlardan biri, boyut tablolarını sade bırakıp yıldız şeması kullanmak mı, yoksa onları alt tablolara ayırıp kar tanesi şeması ile normalize etmek mi sorusudur. Bu tercih yalnızca diyagramın estetiğini değil; disk tüketimini, ETL akışını, sorgu planını ve analistlerin bekleme süresini doğrudan etkiler. Sağlıklı bir karar için sezgilere değil, temsilî iş yüküyle yapılan modelleme çalışmasına ihtiyaç vardır. ``
Yıldız şemasında merkezde büyük bir olgu tablosu bulunur; ürün, müşteri, tarih ve mağaza gibi boyutlar doğrudan bu tabloya bağlanır. Örneğin dim_product içinde ürünün adı, kategorisi ve markası birlikte tutulabilir. Kar tanesi şemasında ise ürün boyutu ayrıştırılır: ürün kategoriye, kategori de departmana bağlanır. Bu, klasik ilişkisel normalleştirmenin veri ambarındaki karşılığıdır.
Teorik performans çerçevesi
Analitik sorgularda maliyetin önemli kısmı, olgu tablosundan okunan satır sayısı ve yapılan birleştirmelerden oluşur. Basitleştirilmiş bir maliyet modeli şöyle yazılabilir:
\[C_{query} \approx C_{scan}(F \times s) + \sum_{i=1}^{j} C_{join}(D_i)\]Burada $F$ olgu tablosundaki satır sayısını, $s$ filtrelerin seçiciliğini, $j$ join sayısını temsil eder. Yıldız şemasında $j$ genellikle daha düşüktür. Buna karşılık denormalize boyut satırları daha geniş olduğundan bellek ve depolama maliyeti artabilir. Kar tanesi şeması depolamayı azaltabilir; ancak kategori veya departman filtresi için ek join zincirleri gerektirir.
| Özellik | Yıldız şeması | Kar tanesi şeması |
|---|---|---|
| Boyut yapısı | Denormalize, geniş | Normalize, parçalı |
| Join sayısı | Az | Daha fazla |
| Sorgu okunabilirliği | Yüksek | Orta |
| Depolama tekrarı | Daha yüksek | Daha düşük |
| BI araçlarıyla uyum | Genellikle güçlü | Modellemeye bağlı |
Deney tasarımı: varsayım yerine ölçüm
Modelleme çalışmasında iki eşdeğer fiziksel model kurun. Her ikisinde de örneğin 100 milyon satırlı bir fact_sales tablosu olsun. Yıldız sürümünde ürün bilgilerini tek boyutta, kar tanesi sürümünde ise product, category ve department tablolarında tutun. Ardından aynı veri dağılımı, aynı indeksleme yaklaşımı ve aynı donanımla sorguları çalıştırın.
Özellikle üç iş yükü önemlidir: tarih aralığında toplam satış, kategori bazında satış kırılımı ve ürün-marka-departman filtreli ayrıntılı rapor. Ölçümlerde yalnızca toplam süreye bakmayın; taranan bayt, CPU süresi, bellek taşması ve sorgu planındaki join stratejisini de kaydedin.
-- Kar tanesi şemasında departman bazında satış analizi
SELECT d.department_name,
       SUM(f.net_amount) AS total_revenue
FROM fact_sales AS f
JOIN dim_product AS p ON f.product_key = p.product_key
JOIN dim_category AS c ON p.category_key = c.category_key
JOIN dim_department AS d ON c.department_key = d.department_key
WHERE f.sale_date >= DATE '2026-01-01'
  AND f.sale_date < DATE '2026-04-01'
GROUP BY d.department_name
ORDER BY total_revenue DESC;
Bu sorgu, kar tanesi yapısının temel bedelini gösterir: olgu tablosuna ulaşmadan önce veya sonra üç boyut join’i yapılır. Sütun tabanlı modern ambarlar, küçük boyut tablolarında broadcast join kullanarak bu maliyeti azaltabilir. Yine de optimizasyonun gerçekleşip gerçekleşmediği yürütme planından doğrulanmalıdır.
| Ölçüm | Yıldızda beklenen sonuç | Kar tanesinde beklenen sonuç |
|---|---|---|
| Basit dashboard sorgusu | Daha kısa gecikme | Yakın veya biraz yüksek gecikme |
| Hiyerarşik filtre | Az sayıda join | Ek join maliyeti |
| Boyut güncellemesi | Tek tabloda daha geniş değişim | Daha az tekrar, daha kontrollü güncelleme |
| Depolama | Görece yüksek | Görece düşük |
Sonuçta evrensel bir kazanan yoktur. Sorgu ağırlıklı, self-service BI kullanılan ortamlarda yıldız şeması çoğu kez daha hızlı ve anlaşılırdır. Çok derin hiyerarşiler, sık değişen referans verileri veya depolama kısıtları varsa kar tanesi şeması anlamlı olabilir. En iyi tasarım, sentetik bir benchmark değil, gerçek filtreleri, kardinaliteyi ve eşzamanlı kullanıcı sayısını temsil eden ölçümlerin sonucunda seçilendir.
Yorumlar