Bir kullanıcıya yeni sipariş, mesaj, fiyat değişimi veya sistem alarmı ulaştırmak istediğinizde klasik HTTP istek-cevap modeli yetersiz kalır. Tarayıcının sürekli “Yeni bir şey var mı?” diye sorması hem gecikme hem de gereksiz sunucu yükü üretir. SSE (Server-Sent Events) ve WebSocket, sunucu ile istemci arasındaki bağlantıyı canlı tutarak bu sorunu çözer; fakat aynı probleme farklı yönlerden yaklaşırlar.
Devamı...
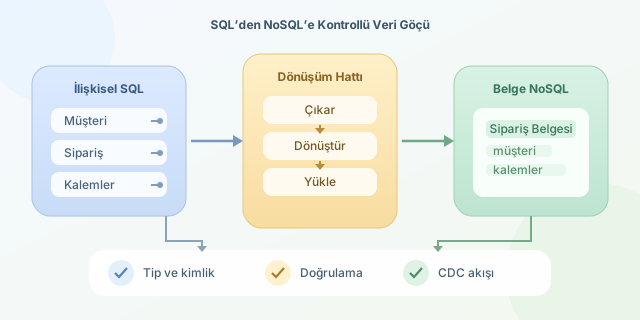
SQL ve NoSQL arasında veri göçü, yalnızca bir tablodan diğerine kayıt kopyalamak değildir; veri modelinin dünyayı yorumlama biçimini değiştirmektir. İlişkisel sistemler tutarlılığı tablolar, anahtarlar ve kısıtlarla korurken; NoSQL sistemleri ölçeklenebilirlik, esnek şema ve erişim desenlerini öne çıkarır. Bu nedenle başarılı bir göçün temel sorusu “Veriyi nasıl taşırım?” değil, “Uygulama bu veriyi hangi sorgularla kullanacak?” olmalıdır.
Devamı...
Veri sıkıştırma, disk alanını azaltmaktan çok daha fazlasıdır: ağ maliyeti, önbellek verimliliği, yedekleme süresi ve işlemci tüketimi arasında yapılan bir pazarlıktır. Snappy, Zstd ve Gzip bu pazarlığın üç farklı karakteridir. Snappy mümkün olan en düşük gecikmeye odaklanır, Gzip köklü ve yaygın uyumluluğu temsil eder, Zstd ise modern donanımlarda hem yüksek hız hem de güçlü oran hedefler. Sağlıklı bir seçim için ezbere değil, temsilî verinizle ölçüme ihtiyaç vardır.
Devamı...
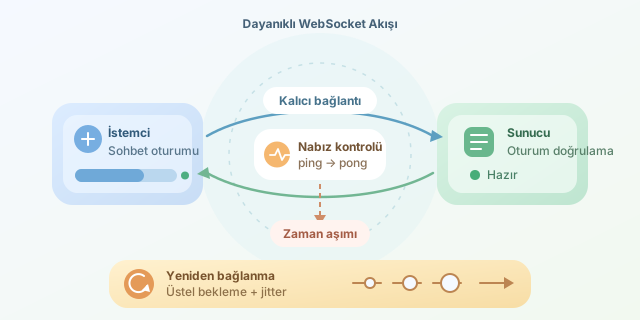
Gerçek zamanlı sohbet uygulamalarında kullanıcılar bağlantının her zaman açık kalmasını bekler. Ancak mobil ağ değişimleri, tarayıcının uykuya geçmesi, sunucu yeniden başlatmaları ve geçici paket kayıpları bu beklentiyi kolayca bozar. Sağlam bir WebSocket istemcisi, kopmayı bir hata sonu değil, yönetilmesi gereken normal bir durum olarak görür. Bu noktada iki temel araç devreye girer: yeniden bağlanma (reconnection) ve heartbeat, yani nabız kontrolü.
Devamı...
Mikroservis mimarisinde bir siparişin oluşturulması, ödemenin alınması ve stok rezervasyonu tek bir veritabanı işlemi değildir; her servis kendi verisine sahiptir. Klasik ACID transaction yaklaşımını servisler arasında yaymak hem pahalı hem de kırılgandır. Saga deseni, büyük işlemi yerel işlemlere böler ve bir adım başarısız olduğunda önceki adımları geri almak için telafi edici işlemler (compensating transactions) çalıştırır. Böylece sistem, anlık tutarlılık yerine kontrollü bir eventual consistency modeli benimser.
Devamı...
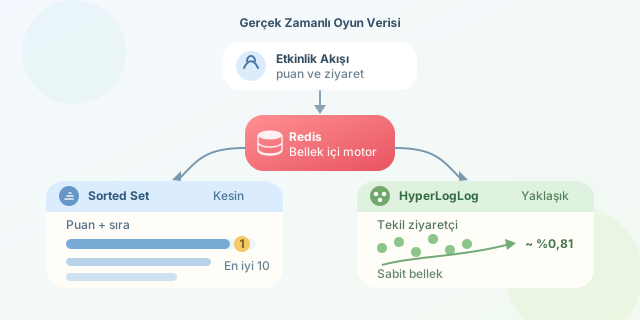
Bir oyun uygulamasında en iyi oyuncuları saniyeler içinde sıralamak ya da bir kampanyayı kaç farklı kullanıcının gördüğünü hesaplamak, ilk bakışta basit görünür. Ancak trafik arttığında klasik SQL sorguları, sürekli güncellenen sayaçlar ve büyük DISTINCT işlemleri pahalılaşır. Redis; bellekte çalışan, düşük gecikmeli veri yapıları sayesinde bu iki problemi zarif biçimde çözer: lider tabloları için Sorted Set, yaklaşık tekil sayım için ise HyperLogLog.
Devamı...
Dağıtık sistemlerde bir mesajın tüketiciye ulaşması, başarıyla işlendiği anlamına gelmez. Veritabanı geçici olarak kapalı olabilir, üçüncü taraf API’si hata verebilir ya da mesajın verisi gerçekten bozuk olabilir. RabbitMQ’nun Dead Letter Exchange (DLX) ve gecikmeli yeniden deneme kurgusu, bu durumlarda mesajları kaybetmeden kontrollü biçimde yönetmeyi sağlar. Amaç, aynı hatalı mesajı sonsuza kadar ana kuyruğu kilitleyecek şekilde tüketmek değil; geçici hatalara zaman tanımak, kalıcı hataları ise görünür ve incelenebilir hale getirmektir.
Devamı...
Büyük veri sistemlerinde dosya formatı seçimi, yalnızca depolama maliyetini değil; Spark, Hive, Trino veya Presto gibi araçlardaki sorgu süresini de doğrudan belirler. Parquet ve ORC, satır bazlı CSV ya da JSON yerine sütun bazlı veri saklayarak analitik iş yüklerini hızlandıran iki güçlü formattır. Ancak benzer hedeflere sahip olsalar da metadata organizasyonları, sıkıştırma stratejileri ve ekosistem uyumları farklıdır.
Devamı...
MongoDB, büyüyen uygulamalarda yalnızca daha fazla veri saklama problemiyle değil, aynı anda gelen binlerce isteği güvenle işleme problemiyle de karşılaşır. Bu noktada replication, sistemin ayakta kalmasını sağlayan güvenlik ağıdır; sharding ise veriyi ve yazma yükünü birden fazla makineye dağıtan ölçekleme motorudur. İkisini birlikte doğru tasarlamak, hem kesintilere dayanıklı hem de yüksek yazma kapasiteli bir mimari oluşturur.
Devamı...
Mikroservis mimarisinde tek bir kullanıcı isteği, çoğu zaman API Gateway’den başlayıp kimlik doğrulama, katalog, ödeme, stok ve bildirim servisleri arasında dolaşır. Bir sayfanın üç saniyede açılması can sıkıcıdır; fakat asıl zor soru şudur: Bu üç saniyeyi hangi servis, hangi veritabanı sorgusu veya hangi ağ çağrısı tüketti? Distributed tracing, isteğin yolculuğunu uçtan uca görünür hâle getirerek tahmin oyununu ölçülebilir bir performans araştırmasına dönüştürür.
Devamı...
Kubernetes kümesinde trafik bazen sakin bir mahalle, bazen de indirim gününde açılmış bir mağaza gibidir. Horizontal Pod Autoscaler (HPA), bu dalgalanmayı izleyip uygulamanın pod sayısını otomatik artırır veya azaltır. Ancak HPA bir “CPU yükseldi, pod ekle” düğmesi değildir; metrikleri hedeflerle karşılaştıran, oran hesaplayan ve kararsızlığı önleyen kontrollü bir karar mekanizmasıdır. Bu mekanizmayı anlamak, hem gereksiz maliyetleri hem de yoğun saatlerde yaşanan gecikmeleri azaltmanın anahtarıdır.
Devamı...
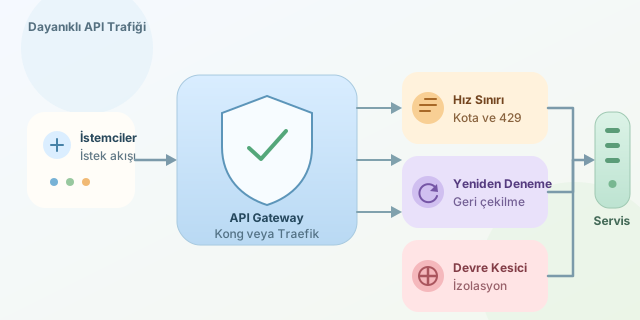
Modern mikroservis mimarisinde API Gateway yalnızca istekleri doğru servise yönlendiren bir trafik polisi değildir; aynı zamanda sistemin kapısındaki güvenlik görevlisi, tamponu ve kriz yöneticisidir. Kong ve Traefik gibi gateway’ler üzerinden rate limiting, circuit breaker ve retry politikaları tanımlamak; ani trafik patlamalarının, geçici ağ hatalarının ve domino etkisi yaratan servis arızalarının tüm platformu devirmesini engeller.
Devamı...
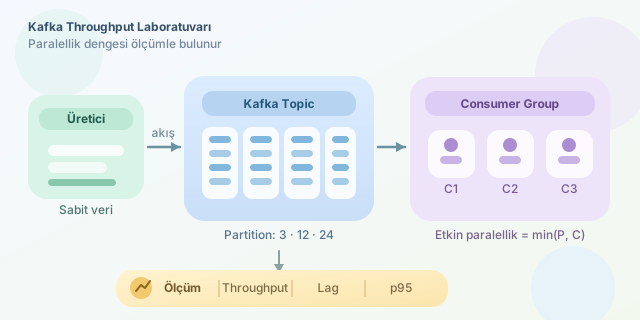
Apache Kafka’da yüksek iş hacmi yalnızca daha güçlü sunucular eklemekle elde edilmez; partition sayısı, consumer group içindeki tüketici sayısı, mesaj boyutu ve disk-ağ kapasitesi birlikte çalışır. En iyi yapılandırma, tahminle değil ölçümle bulunur. Bu yazıda kontrollü deneyler kurarak partition ve consumer group kararlarının üretim (produce) ve tüketim (consume) throughput’unu nasıl değiştirdiğini inceleyeceğiz.
Devamı...
JWT tabanlı kimlik doğrulama, stateless yapısı sayesinde ölçeklenebilir uygulamalarda oldukça popülerdir; ancak token çalınması, uzun oturumlar ve cihaz yönetimi gibi konular dikkatli tasarlanmadığında ciddi güvenlik açıkları doğurur. Bu noktada kısa ömürlü access token ve rotasyona tabi refresh token ikilisi, hem kullanıcı deneyimini hem de güvenlik seviyesini dengeler.
Devamı...
Mikroservis mimarisinde bir isteğin kaç farklı servisten geçtiğini takip etmek bile bazen dedektiflik gerektirir. Güvenlik açısından daha kritik soru ise şudur: Bu servisler gerçekten birbirleriyle konuştuğunu sandıkları servisler mi? Servis ağı (service mesh), uygulama kodunu güvenlik ve ağ politikalarıyla şişirmeden bu sorunu çözmek için tasarlanır. Istio ve Linkerd; şifreleme, kimlik doğrulama, yetkilendirme, gözlemlenebilirlik ve trafik yönetimini altyapı katmanına taşır.
Devamı...
Modern servisler yalnızca istek alıp JSON döndüren yapılardan ibaret değil: canlı konum, borsa verisi, oyun olayları ve telemetri akışları sürekli iletişim bekliyor. Bu noktada gRPC’nin HTTP/2 üzerinde çalışan streaming modeli, REST’in klasik istek-cevap ritmine güçlü bir alternatif sunar. Ancak “gRPC her zaman hızlıdır” demek yerine; gecikme, mesaj boyutu, eşzamanlı bağlantı ve iş yükü türü üzerinden ölçüm yapmak gerekir.
Devamı...
GraphQL, istemciye ihtiyacı olan veriyi seçme özgürlüğü verir; fakat bu esneklik resolver katmanında gizli bir maliyet doğurabilir. Kullanıcıları ve her kullanıcının gönderilerini listeleyen basit bir sorgu düşünün: kullanıcılar için bir sorgu, ardından her kullanıcı için ayrı gönderi sorgusu çalışır. Veri tabanı açısından masum görünen bu akış, kullanıcı sayısı arttıkça bir sorgu fırtınasına dönüşür. İşte bu klasik N+1 problemidir.
Devamı...
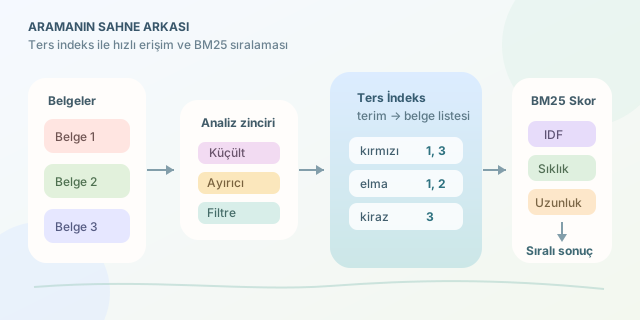
Elasticsearch, milyonlarca belge arasında milisaniyeler içinde arama yapabilmesini büyük ölçüde ters indeks (inverted index) adlı yapıya borçludur. Klasik bir veritabanında “bu belgenin içinde hangi kelimeler var?” sorusu öne çıkarken, ters indeks “bu kelime hangi belgelerde geçiyor?” sorusunu merkeze alır. Arama motoru dünyasının sihirbaz şapkası tam olarak budur.
Devamı...
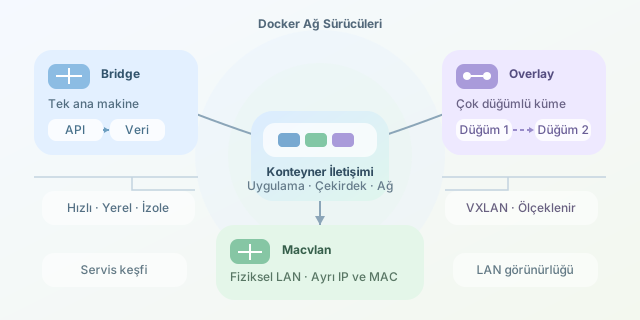
Docker’da ağ sürücüsü seçmek, sadece konteynerlere IP dağıtmak değildir; erişim sınırlarını, servis keşfini, gecikmeyi ve altyapının ölçeklenme biçimini belirler. Aynı uygulamanın yerel bir makinede, çok düğümlü bir kümede veya fiziksel ağda görünür olması gerektiğinde farklı sürücüler anlam kazanır. Bu yazıda bridge, overlay ve macvlan sürücülerini küçük ama tekrarlanabilir deneylerle karşılaştıralım.
Devamı...
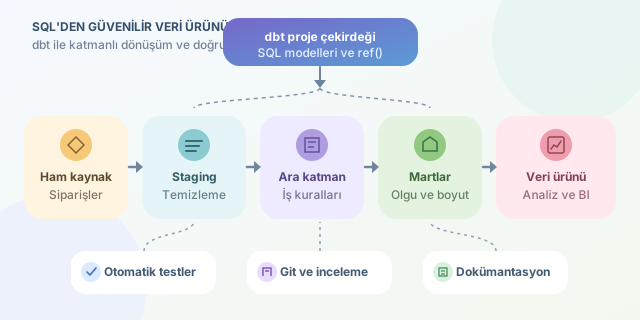
Modern veri ekiplerinde asıl zorluk, veriyi depoya taşımaktan çok onu güvenilir, anlaşılır ve yeniden üretilebilir biçimde dönüştürmektir. dbt (data build tool), bu problemi SQL dönüşümlerini yazılım geliştirme disiplinleriyle birleştirerek çözer. Böylece karmaşık ETL betikleri yerine Git ile izlenen modeller, testler, dokümantasyon ve bağımlılık grafikleriyle yönetilen bir veri platformu elde edersiniz.
Devamı...