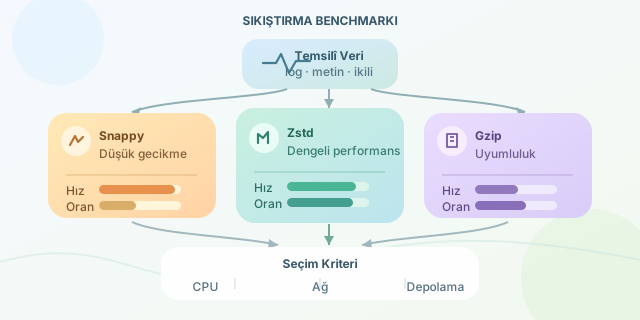
Veri sıkıştırma, disk alanını azaltmaktan çok daha fazlasıdır: ağ maliyeti, önbellek verimliliği, yedekleme süresi ve işlemci tüketimi arasında yapılan bir pazarlıktır. Snappy, Zstd ve Gzip bu pazarlığın üç farklı karakteridir. Snappy mümkün olan en düşük gecikmeye odaklanır, Gzip köklü ve yaygın uyumluluğu temsil eder, Zstd ise modern donanımlarda hem yüksek hız hem de güçlü oran hedefler. Sağlıklı bir seçim için ezbere değil, temsilî verinizle ölçüme ihtiyaç vardır.
``
Bir sıkıştırıcının başarısını yalnızca “dosyayı ne kadar küçülttü?” sorusuyla değerlendirmek yanıltıcıdır. Sıkıştırma oranı genellikle şu şekilde hesaplanır:
\[R = \frac{S_{orijinal}}{S_{sıkıştırılmış}}\]Burada $R$ büyüdükçe dosya daha iyi küçülür. Ancak üretim ortamında sıkıştırma hızı ($V_s$) ve açma hızı ($V_a$) da kritiktir. Örneğin günlükleri arşivleyen bir sistem yüksek $R$ isteyebilirken, gerçek zamanlı RPC trafiği düşük gecikme için yüksek $V_s$ ve $V_a$ talep eder. Toplam faydayı kabaca $F = \alpha R + \beta V_s + \gamma V_a$ şeklinde düşünebilirsiniz; katsayılar uygulamanızın öncelikleridir.
Algoritmaların karakteri
Gzip, DEFLATE algoritmasını kullanır ve uzun yıllardır .gz dosyalarının varsayılanıdır. Özellikle metin tabanlı verilerde makul oranlar sunar; fakat yüksek sıkıştırma seviyelerinde işlemci maliyeti hissedilir. Snappy, Google tarafından gecikme odaklı tasarlanmıştır. Sıkıştırma oranından bilinçli olarak feragat edip çok hızlı kodlama ve çözme sağlar. Zstd ise sözlükler, geniş seviye aralığı ve modern algoritmik optimizasyonlarla iki uç arasında etkileyici bir denge kurar.
| Algoritma | Baskın hedef | Sıkıştırma oranı | Sıkıştırma hızı | Açma hızı | Tipik kullanım |
|---|---|---|---|---|---|
| Snappy | Düşük gecikme | Düşük-Orta | Çok yüksek | Çok yüksek | Kafka, sütunlu veri formatları |
| Gzip | Uyumluluk | Orta | Orta-Düşük | Orta | HTTP, arşivler, eski sistemler |
| Zstd | Dengeli performans | Orta-Yüksek | Yüksek | Çok yüksek | Log, yedek, API ve veri gölleri |
Adil bir benchmark nasıl kurulur?
Tek bir JSON dosyasıyla yapılan test, “algoritma”dan çok “o dosyanın yapısı”nı ölçer. Bu nedenle en az üç veri kümesi kullanın: tekrar eden uygulama logları, JSON/CSV gibi metin verileri ve JPEG/PDF gibi zaten sıkıştırılmış ikili veriler. Son grupta oranların zayıf kalması hata değildir; sıkıştırıcıların çıkarabileceği fazlalık zaten azdır.
Python ile temel bir test iskeleti şöyle kurulabilir. Gerçek projede her testi birkaç kez çalıştırıp medyan değeri almak, disk önbelleği ve anlık CPU dalgalanmalarının etkisini azaltır.
import time
import gzip
import zstandard as zstd
import snappy

raw = open("ornek.log", "rb").read()
algoritmalar = {
    "gzip-6": lambda d: gzip.compress(d, compresslevel=6),
    "zstd-3": lambda d: zstd.ZstdCompressor(level=3).compress(d),
    "snappy": snappy.compress,
}

for ad, compress in algoritmalar.items():
    baslangic = time.perf_counter()
    packed = compress(raw)
    saniye = time.perf_counter() - baslangic
    oran = len(raw) / len(packed)
    hiz = len(raw) / saniye / 1024 / 1024
    print(f"{ad}: oran={oran:.2f}x, hız={hiz:.1f} MiB/s")
Bu kod, aynı ham veriyi her algoritmaya verir; süreyi ölçer, oranı ve MiB/s cinsinden hızı raporlar. Benchmark’a açma süresini de eklemeyi unutmayın. Çünkü bazı iş yüklerinde veri bir kez yazılır ama binlerce kez okunur.
Sonucu yorumlamak
Zstd için seviye 1, 3, 9 ve 19; Gzip için 1, 6 ve 9 test edilmelidir. Seviye yükseldikçe oran genellikle artar, fakat hız doğrusal olmayan biçimde düşebilir. Çoğu genel amaçlı iş yükünde Zstd seviye 3 güçlü bir başlangıç noktasıdır. En kritik metrik gecikmeyse Snappy, dış dünya ile dosya paylaşımı ve maksimum uyumluluk gerekiyorsa Gzip mantıklıdır. En iyi algoritma, en küçük çıktıyı üreten değil; sisteminizin CPU, ağ ve depolama bütçesinde en düşük toplam maliyeti oluşturan algoritmadır.
Yorumlar