Etiketli veri, makine öğrenmesinin kahvesidir: model onsuz güne başlayamaz. Fakat gerçek hayatta her örneği uzmanlara etiketletmek pahalı, yavaş ve bazen de oldukça sıkıcıdır. Aktif öğrenme (active learning), elinizde küçük bir etiketli küme ve büyük bir etiketsiz havuz varken modele söz hakkı verir: Model, öğrenmesine en fazla katkıyı sağlayacak örneklerin etiketini ister. Ama kritik soru şudur: Modelin hangi örnekleri sormasına izin vermeliyiz?
``
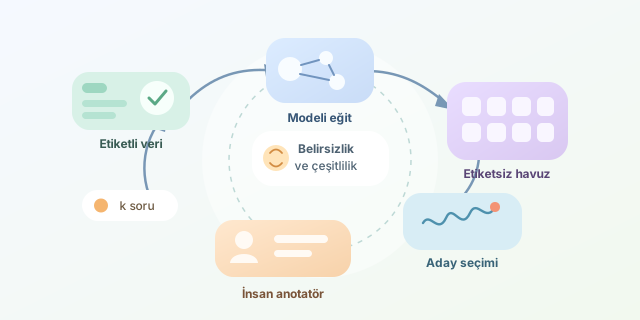
Aktif öğrenmenin temel döngüsü dört adımdan oluşur: Başlangıçtaki etiketli veriyle bir model eğitilir, etiketsiz havuzdaki örnekler puanlanır, en değerli $k$ örnek insan anotatöre gönderilir ve yeni etiketlerle model yeniden eğitilir. Bu süreç, etiket bütçesi bitene veya hedef başarıya erişilene dek devam eder.
Teoride hedef, seçilen sorgu kümesinin beklenen bilgi kazancını artırmaktır. Bir sınıflandırıcının bir örnek için ürettiği olasılık dağılımı $p(y\mid x)$ ise, belirsizlik çoğu zaman entropiyle ölçülür:
\[H(y\mid x)=-\sum_{c=1}^{C}p(y=c\mid x)\log p(y=c\mid x)\]Entropi yüksekse model sınıflar arasında kararsızdır; bu örnek genellikle iyi bir soru adayıdır. Ancak “en kararsız örneği seç” kuralı tek başına her zaman kazanmaz. Model gürültülü, aykırı veya veri dağılımının dışında kalan örneklerde de çok kararsız olabilir. Yani model bazen gerçekten öğrenmek için değil, sadece kafası karıştığı için soru sorar.
| Strateji | Seçim mantığı | Güçlü yanı | Dikkat edilmesi gereken |
|---|---|---|---|
| En az güven (least confidence) | $1-\max_c p(c\mid x)$ en büyük örnek | Basit ve hızlı | Sınıf olasılıklarının tamamını kullanmaz |
| Marj örneklemesi | İlk iki olasılık farkı en küçük örnek | Karar sınırına odaklanır | Çok sınıflı yapıda hassas olabilir |
| Entropi örneklemesi | Entropisi en yüksek örnek | Tüm dağılımı değerlendirir | Aykırı değerlere yönelebilir |
| Çeşitlilik tabanlı seçim | Temsil uzayında farklı örnekler | Tekrarlı sorguları azaltır | Kümeleme maliyeti getirir |
Örneğin marj örneklemesinde $p_1$ ve $p_2$, en olası iki sınıfın skorları olsun. Sorgu skoru $p_1-p_2$ ile ifade edilir; küçük marj, modelin karar sınırına yakın bir gözlemi işaret eder. Bu yaklaşım, “kedi mi köpek mi?” sorusunda %51-%49 arasında kalan bir görseli, %99-%1 kadar emin olunan bir görsele tercih eder.
Pratikte en dengeli yaklaşım belirsizlik ve çeşitliliği birleştirmektir. Önce belirsiz örneklerden geniş bir aday listesi çıkarın; sonra bu liste içinden birbirine benzemeyen örnekleri seçin. Böylece modele aynı türden yüzlerce bulanık fotoğraf göstermek yerine, farklı karar bölgelerini kapsayan sorular sorarsınız. Aşağıdaki Python örneği, olasılıklardan entropi hesaplayıp en belirsiz kayıtları seçer:
import numpy as np

# model.predict_proba(X_pool) çıktısı: (örnek_sayısı, sınıf_sayısı)
probs = model.predict_proba(X_pool)
eps = 1e-12
entropy = -np.sum(probs * np.log(probs + eps), axis=1)

budget = 20
query_idx = np.argsort(entropy)[-budget:]
X_query = X_pool[query_idx]

# X_query anotatöre gönderilir; dönen etiketler eğitim kümesine eklenir.
Kodda $\epsilon$ eklenmesinin sebebi $\log(0)$ kaynaklı sayısal sorunları önlemektir. Seçilen query_idx kayıtları etiketlendikten sonra hem X_pool içinden çıkarılmalı hem de eğitim verisine eklenmelidir. Aksi hâlde model aynı soruyu tekrar soran unutkan bir stajyere dönüşür.
Başarıyı yalnızca doğrulukla ölçmeyin. Aynı etiket bütçesinde pasif, yani rastgele örnekleme yapan bir temel yöntem kurun. Ardından öğrenme eğrilerini karşılaştırın: yatay eksen etiket sayısı, dikey eksen F1 veya doğruluk olsun. Aktif öğrenme gerçekten faydalıysa, daha az etiketle aynı kaliteye ulaşmalıdır. Özellikle sınıf dengesizliği varsa, seçim kotası veya sınıf başına çeşitlilik eklemek de az görülen sınıfların tamamen unutulmasını engeller.
Yorumlar