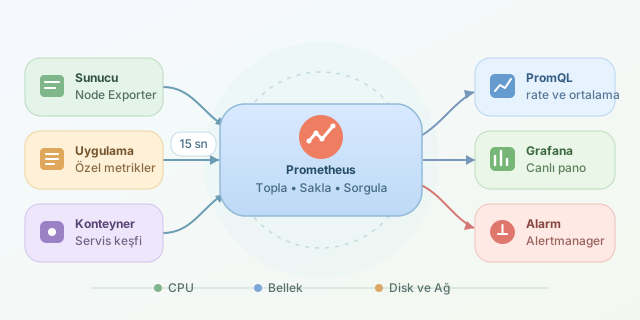
Bir sunucunun CPU kullanımı %95’e ulaştığında bunu kullanıcılar şikâyet etmeden önce görmek, modern operasyon ekiplerinin süper gücüdür. Prometheus; sunucular, uygulamalar ve konteynerler için zaman serisi verisi toplayan, sorgulayan ve alarm üreten açık kaynaklı bir izleme sistemidir. Temel hedefi basittir: “Şu anda ne oluyor, geçmişte ne oldu ve kötüye giderse bana kim haber verecek?” sorularını ölçülebilir verilerle yanıtlamak.
``
Prometheus’un merkezinde metrik kavramı bulunur. Metrik, zaman damgasına bağlı sayısal bir gözlemdir. Örneğin node_cpu_seconds_total, işlemcinin hangi modda ne kadar süre çalıştığını; node_memory_MemAvailable_bytes ise kullanılabilir belleği anlatır. Her metrik, onu filtrelemeyi sağlayan etiketler (labels) de taşıyabilir. Böylece tek bir isim altında instance, job, cpu veya mode gibi boyutlarla ayrıntılı analiz yapılır.
Pull modeli neden önemlidir?
Prometheus çoğunlukla pull modeliyle çalışır: Prometheus sunucusu, belirli aralıklarla hedeflerin /metrics adresine HTTP isteği gönderir ve metrikleri alır. Hedefe doğrudan metrik ekleyemediğimiz durumlarda ise Pushgateway gibi bileşenler devreye girebilir. Pull yaklaşımı, hangi hedeflerin gerçekten erişilebilir olduğunu merkezi olarak görmeyi kolaylaştırır.
| Kavram | Görevi | Örnek |
|---|---|---|
| Prometheus Server | Metrikleri toplar, saklar ve sorgular | 15 saniyede bir scrape işlemi |
| Exporter | Sistem verisini Prometheus biçimine çevirir | Node Exporter |
| PromQL | Zaman serilerini sorgular | CPU kullanım oranı |
| Alertmanager | Alarm bildirimlerini yönlendirir | Slack, e-posta, PagerDuty |
Sunucu izlemede en yaygın başlangıç noktası Node Exporter‘dır. Linux işletim sistemi istatistiklerini okunabilir Prometheus metrikleri olarak sunar. Örneğin aşağıdaki prometheus.yml, yerel makinedeki exporter’ı 15 saniyede bir tarar:
global:
  scrape_interval: 15s

scrape_configs:
  - job_name: node
    static_configs:
      - targets: ["localhost:9100"]
Bu yapılandırmada job_name, hedef grubunun mantıksal adıdır. targets alanı ise exporter adreslerini içerir. Gerçek ortamda IP listesi yerine Kubernetes servis keşfi, Consul veya dosya tabanlı keşif kullanmak yönetimi ciddi biçimde kolaylaştırır.
Ham sayıdan anlamlı orana
Bazı metrikler doğrudan yorumlanamaz. CPU sayacı sürekli artan bir değerdir; anlık kullanımı bulmak için değişim hızı hesaplanmalıdır. Boşta geçen CPU süresinin oranı çıkarıldığında yaklaşık kullanım oranı elde edilir:
\[CPU\ Kullanımı = 100 \times \left(1 - \operatorname{avg}(rate(node\_cpu\_seconds\_total\{mode="idle"\}[5m]))\right)\]PromQL karşılığı şöyledir:
100 * (1 - avg by(instance) (
  rate(node_cpu_seconds_total{mode="idle"}[5m])
))
rate(...[5m]), son beş dakikadaki sayaç artış hızını hesaplar. avg by(instance) tüm CPU çekirdeklerini sunucu bazında ortalar. Kısa pencere daha hızlı tepki verirken gürültü üretir; uzun pencere ise daha sakin ama daha geç tepki veren grafikler oluşturur.
| Metrik tipi | Davranış | Uygun PromQL fonksiyonu |
|---|---|---|
| Counter | Sürekli artar, yeniden başlamada sıfırlanabilir | rate(), increase() |
| Gauge | Anlık olarak artıp azalabilir | Doğrudan değer, avg_over_time() |
| Histogram | Gözlem dağılımı ve gecikme kovaları tutar | histogram_quantile() |
İzleme yalnızca grafik çizmek değildir; aksiyon alınabilir alarm üretmektir. Örneğin CPU beş dakika boyunca %85 üzerindeyse alarm kuralı tanımlanabilir:
groups:
  - name: sunucu-kurallari
    rules:
      - alert: YuksekCPU
        expr: 100 * (1 - avg by(instance) (rate(node_cpu_seconds_total{mode="idle"}[5m]))) > 85
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "{{ $labels.instance }} üzerinde CPU kullanımı yüksek"
Buradaki for: 5m, kısa süreli CPU sıçramalarının gereksiz bildirim üretmesini engeller. Prometheus veriyi toplar ve kuralı değerlendirir; Alertmanager ise benzer alarmları gruplar, susturma kurallarını uygular ve doğru kanala iletir.
Son olarak, iyi bir dashboard için yalnızca CPU’ya odaklanmayın. CPU, bellek, disk doluluk oranı, disk I/O, ağ trafiği, HTTP hata oranı ve yanıt süresi birlikte değerlendirilmelidir. Prometheus’u Grafana ile birleştirdiğinizde bu metrikler canlı panolara dönüşür. Böylece “sunucu yavaş” gibi belirsiz bir cümle, hangi makinede, ne zaman ve hangi kaynağın tükendiğini söyleyen somut bir teşhise dönüşür.
Yorumlar