İçindekiler
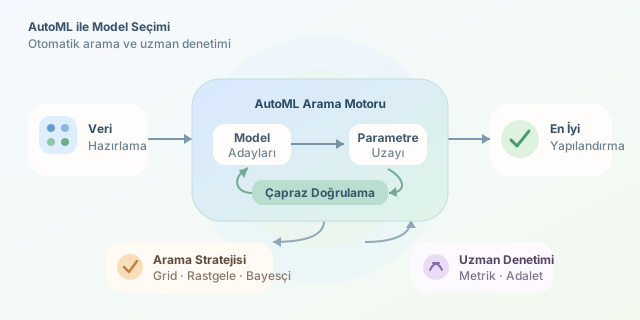
Makine öğrenmesi projelerinde en zor kısım çoğu zaman modeli eğitmek değil, hangi modeli denemek gerektiğine ve bu modelin ayarlarının nasıl yapılacağına karar vermektir. Karar ağacı mı, gradyan artırma mı, yoksa lojistik regresyon mu? Öğrenme oranı kaç olmalı? İşte AutoML (Automated Machine Learning), bu tekrar eden deneme-yanılma döngüsünü akıllı bir otomasyona dönüştürür. Amaç, veri bilimcisini ortadan kaldırmak değil; onu sonsuz parametre ayarı ekranından kurtarmaktır. ``
AutoML tam olarak neyi otomatikleştirir?
Tipik bir AutoML sistemi yalnızca tek bir algoritmayı çalıştırmaz. Veri hazırlama, özellik dönüştürme, model adaylarının oluşturulması, çapraz doğrulama ve en iyi yapılandırmanın seçimi gibi aşamaları bir araya getirir. Bir modelin başarısı genel olarak şu optimizasyon problemiyle ifade edilebilir:
\[(m^*, \lambda^*) = \arg\min_{m \in \mathcal{M},\, \lambda \in \Lambda_m} \mathcal{L}(m, \lambda; D_{validation})\]Burada $\mathcal{M}$ model ailesini, $\lambda$ hiperparametreleri ve $\mathcal{L}$ ise kayıp fonksiyonunu temsil eder. Örneğin sınıflandırmada hata oranı veya log-loss; regresyonda MAE ya da RMSE kullanılabilir. AutoML’in görevi, büyük bir olasılık uzayında bu en iyi ikiliyi makul sürede bulmaktır.
| Aşama | Manuel yaklaşım | AutoML yaklaşımı |
|---|---|---|
| Model seçimi | Uzman tahminiyle birkaç model denenir | Birden fazla algoritma sistematik biçimde taranır |
| Hiperparametreler | Elle ayarlanır veya sabit bırakılır | Arama stratejileriyle optimize edilir |
| Doğrulama | Kolayca hatalı kurgulanabilir | Çapraz doğrulama iş akışına eklenir |
| Tekrarlanabilirlik | Notlara ve kişiye bağlıdır | Deney kayıtlarıyla daha düzenlidir |
Hiperparametre arama stratejileri
Hiperparametreler, eğitim sırasında modelin öğrenmediği; eğitimi yöneten ayarlardır. max_depth, n_estimators ve learning_rate buna örnektir. Grid Search tüm kombinasyonları dener, ancak parametre sayısı arttıkça maliyeti hızla patlar. Her parametrenin $k$ farklı değeri ve toplam $p$ parametre varsa, yaklaşık $k^p$ deney gerekir. Bu, küçük bir ayar menüsünün bile kısa sürede canavara dönüşmesi demektir.
| Yöntem | Güçlü yönü | Sınırlaması |
|---|---|---|
| Grid Search | Küçük uzaylarda düzenli ve anlaşılır | Hesaplama maliyeti yüksektir |
| Random Search | Etkili parametreleri daha hızlı bulabilir | Rastlantısal sonuçlar değişken olabilir |
| Bayesian Optimization | Önceki denemelerden öğrenerek öneri üretir | Kurulum ve yorumlama daha karmaşıktır |
| Evolutionary Search | Geniş ve karmaşık uzaylarda esnektir | Çok sayıda değerlendirme isteyebilir |
Bayesçi optimizasyon özellikle pahalı eğitimlerde değerlidir. Sistem, geçmiş denemelerden bir vekil model oluşturur ve sonraki denemede hem iyi sonuç olasılığı yüksek hem de hakkında az şey bilinen bölgeleri araştırır. Bu denge, exploration-exploitation olarak bilinir.
Python ile küçük ama gerçekçi bir örnek
Aşağıdaki örnekte RandomizedSearchCV, bir Random Forest sınıflandırıcısı için rastgele seçilmiş parametre kombinasyonlarını çapraz doğrulama ile değerlendirir. Bu, tam kapsamlı bir AutoML platformu değildir; ancak AutoML mantığının çekirdeğini gösterir.
from sklearn.datasets import load_wine
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import RandomizedSearchCV

X, y = load_wine(return_X_y=True)

param_space = {
    "n_estimators": [100, 200, 400],
    "max_depth": [None, 5, 10, 20],
    "min_samples_split": [2, 5, 10],
    "max_features": ["sqrt", "log2"]
}

search = RandomizedSearchCV(
    estimator=RandomForestClassifier(random_state=42),
    param_distributions=param_space,
    n_iter=12,
    cv=5,
    scoring="accuracy",
    n_jobs=-1,
    random_state=42
)

search.fit(X, y)
print(search.best_score_)
print(search.best_params_)
Burada cv=5, her adayın verinin beş farklı bölünmesinde test edilmesini sağlar. Böylece tek bir eğitim-test ayrımına fazla güvenme riski azalır. n_jobs=-1 ise kullanılabilir işlemci çekirdeklerinden yararlanarak taramayı hızlandırır.
Otomasyonun kör noktaları
AutoML sonuçlarını doğrudan üretime almak tehlikeli olabilir. Veri sızıntısı, sınıf dengesizliği, yanlış metrik seçimi ve adaletsizlik sorunları otomatik arama ile sihirli biçimde çözülmez. Örneğin dolandırıcılık verisinde doğruluk yüksek görünürken azınlık sınıfı tamamen kaçırılabilir; bu durumda F1, recall veya PR-AUC daha anlamlı olabilir.
En iyi yaklaşım, AutoML’i deney hızlandırıcısı olarak kullanmaktır: sistem adayları sıralasın, uzman ise veri kalitesini, iş hedefini, açıklanabilirliği ve üretim maliyetini değerlendirsin. Kısacası AutoML direksiyona yardımcı olur; nereye gidileceğine hâlâ siz karar verirsiniz.
Yorumlar