İçindekiler
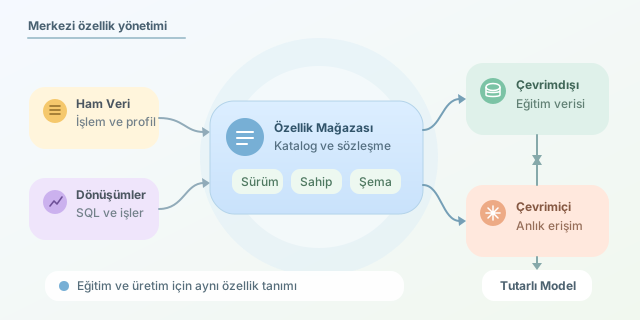
Makine öğrenmesi projelerinde model seçimi çoğu zaman sahnenin yıldızı gibi görünür; ancak gerçek hayatta performansı belirleyen oyuncu genellikle verilerdir. Özellikle özellikler (feature) farklı ekipler, SQL sorguları, notebook’lar ve üretim servisleri arasında dağınıksa aynı müşteri yaşı, satın alma toplamı veya risk puanı birbirinden farklı hesaplanabilir. Feature Store, bu karmaşayı azaltmak için özellikleri merkezi, tekrar kullanılabilir, izlenebilir ve güvenilir biçimde yöneten veri platformu katmanıdır. ``
Bir feature store’u, makine öğrenmesi için tasarlanmış bir “özellik kataloğu + veri teslim sistemi” olarak düşünebiliriz. Veri bilimci bir özelliğin yalnızca adını değil; açıklamasını, sahibini, veri tipini, hesaplama mantığını, güncellenme sıklığını ve hangi modellerde kullanıldığını da bulur. Böylece customer_30d_spend adlı alanın her ekipte başka formülle hesaplanması engellenir.
Neden yalnızca veri ambarı yetmez?
Veri ambarları analitik sorgular için çok değerlidir; feature store ise ML yaşam döngüsünün özel sorunlarına odaklanır. En kritik konu eğitim ve üretim tutarlılığıdır. Eğitimde kullanılan dönüşüm ile canlı tahminde kullanılan dönüşüm farklıysa training-serving skew ortaya çıkar. Model testte başarılı görünürken üretimde şaşırtıcı derecede zayıf sonuç verebilir.
| Yaklaşım | Özellik tanımı | Canlı erişim | Sürüm ve soy ağacı |
|---|---|---|---|
| Dağınık notebook/SQL | Ekip veya kişi bazlı | Genellikle manuel | Takibi zor |
| Veri ambarı | Tablo merkezli | Gecikmesi yüksek olabilir | Kısmen mümkün |
| Feature Store | Özellik merkezli ve standart | Online/offline katmanlar | Güçlü metadata ve izlenebilirlik |
Örneğin bir dolandırıcılık modeli, son bir saatteki işlem sayısına ihtiyaç duyabilir. Bu özellik şöyle ifade edilebilir:
\[x_{1h}(u,t)=\sum_{i \in I(u)} \mathbb{1}[t-1\text{ saat} < t_i \leq t]\]Burada $I(u)$ kullanıcının işlemlerini, $\mathbb{1}$ ise koşul sağlandığında 1 olan gösterge fonksiyonunu temsil eder. Eğitim verisi hazırlanırken bu değer geçmişteki her an için doğru hesaplanmalıdır. Canlıda ise aynı mantık milisaniyeler içinde güncel değeri döndürmelidir. Feature store, bu iki ihtiyacı offline ve online store bileşenleriyle bir araya getirir.
Offline ve online katmanın rolü
Offline store büyük tarihsel veriyi saklar; model eğitimi, doğrulama ve geriye dönük analiz için uygundur. Online store ise düşük gecikmeli tahmin anında güncel feature değerlerini sunar. İdeal hedef şudur:
\[f_{train}(u,t) \approx f_{serve}(u,t)\]Bu eşitlik mutlak matematiksel özdeşlikten çok operasyonel bir sözleşmedir: aynı tanım, aynı dönüşüm, doğru zaman referansı ve denetlenebilir sürümler.
| Bileşen | Temel görev | Tipik beklenti |
|---|---|---|
| Feature registry | Tanım, şema, sahiplik ve sürüm tutmak | Keşfedilebilirlik |
| Offline store | Tarihsel feature set üretmek | Büyük ölçekli sorgu |
| Online store | Anlık feature okumak | Düşük gecikme |
| Materialization | Offline veriyi online katmana aktarmak | Güncellik |
Point-in-time correctness: sessiz kahraman
Tarihsel eğitim seti oluştururken gelecekte bilinen bir bilgiyi geçmişe kaçırmak, veri sızıntısıdır. Diyelim ki 1 Haziran’daki kredi kararını tahmin ediyoruz. 3 Haziran’da gerçekleşen ödeme, 1 Haziran satırında feature olarak görünmemelidir. Feature store sistemleri çoğunlukla olay zamanı (event time) ve oluşturulma zamanı (created time) ayrımıyla bu sorunu yönetir. Bu yaklaşım modelin gerçekçi performansını ölçmeye yardım eder.
Aşağıdaki örnek, kavramsal bir feature tanımını gösterir:
from datetime import timedelta

customer_features = FeatureView(
    name="customer_activity",
    entities=["customer_id"],
    ttl=timedelta(days=2),
    schema=["orders_7d:int", "spend_30d:float"],
    source="warehouse.customer_daily_metrics"
)
Bu tanımda customer_id varlığı özellikleri müşteriye bağlar. ttl, online kaydın ne kadar süre geçerli kabul edileceğini belirler; şema ise model ile veri arasındaki sözleşmeyi görünür kılar. Gerçek sistemde kaynak tablo, dönüşüm işi ve materialization zamanlaması da bu tanıma eşlik eder.
Uygulama stratejisi
Feature store kurmak, ilk günden tüm dönüşümleri taşımak anlamına gelmez. Önce birden fazla modelin kullandığı, hesaplaması pahalı veya üretimde tutarsızlık riski yüksek özellikleri seçin. Her feature için açık isimlendirme, veri sahibi, kalite kontrolleri ve güncellenme beklentisi belirleyin. Sonrasında kullanım metriklerini izleyin: Hangi özellikler hiç kullanılmıyor, hangilerinde null oranı arttı, hangi model hangi sürümü kullanıyor?
Sonuçta feature store bir sihirli model performansı düğmesi değildir. Buna karşın iyi tasarlandığında tekrar eden veri hazırlama işini azaltır, deneyleri hızlandırır ve eğitim-üretim arasındaki güven zincirini güçlendirir. Model ekipleri için en büyük kazanım da budur: özellikler artık kayıp notebook hücrelerinde değil, ortak ve yönetilebilir bir üründe yaşar.
Yorumlar