ReLU yıllarca yapay sinir ağlarının çalışkan kahramanı oldu: basit, hızlı ve çoğu zaman yeterince başarılı. Ancak negatif değerleri tamamen silmesi ve türevinin bazı bölgelerde sıfıra düşmesi, araştırmacıları daha yumuşak alternatiflere yöneltti. Swish ve Mish bu arayışın öne çıkan sonuçlarıdır. Üstel fonksiyon içermelerine rağmen modern işlemcilerde vektörleştirme, çekirdek birleştirme ve yaklaşık hesaplama sayesinde oldukça verimli uygulanabilirler.
Devamı...
Bir müşterinin ekmek ve peynir alırken sepete zeytin de eklemesi tesadüf mü, yoksa tekrar eden bir alışveriş davranışı mı? Apriori algoritması, binlerce işlem kaydının arkasına saklanan bu tür ilişkileri keşfetmek için kullanılan frekans tabanlı bir yöntemdir. Market sepeti analiziyle özdeşleşse de öneri sistemlerinden web kullanım analizine kadar pek çok alanda karşımıza çıkar.
Devamı...
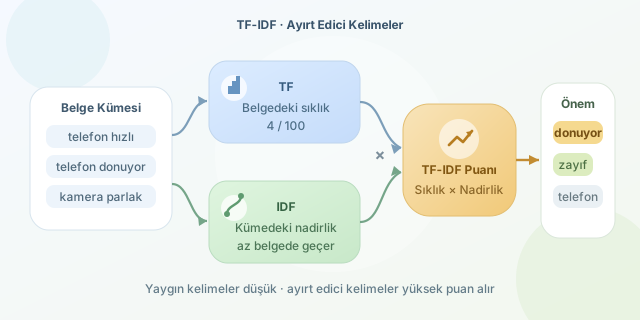
Bir metinde en çok geçen kelime, her zaman en önemli kelime değildir. Örneğin “ve”, “bir” veya “için” yüzlerce belgede sıkça görülebilir; ancak bu kelimeler bize belgenin konusu hakkında pek ipucu vermez. TF-IDF, bir kelimenin belge içindeki sıklığı ile bütün veri kümesindeki nadirliği arasında denge kurarak ayırt edici kelimeleri öne çıkarır.
Devamı...
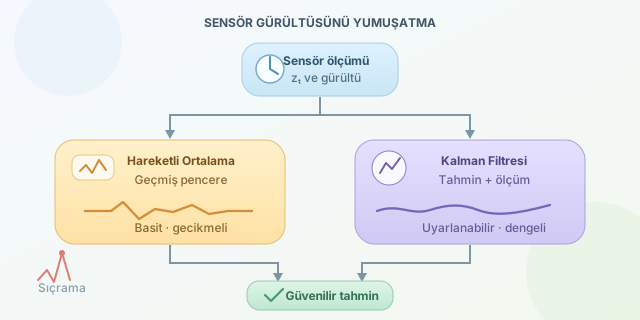
Bir sıcaklık sensörünün 22,1 °C gösterirken aniden 47 °C’ye çıkıp sonraki ölçümde normale döndüğünü düşünün. Ortam bir saniyede tropik adaya dönüşmediğine göre karşımızda büyük olasılıkla elektriksel parazit, haberleşme hatası veya ölçüm gürültüsü vardır. Bu sıçramaları azaltmanın iki popüler yolu hareketli ortalama ve Kalman filtresidir.
Devamı...
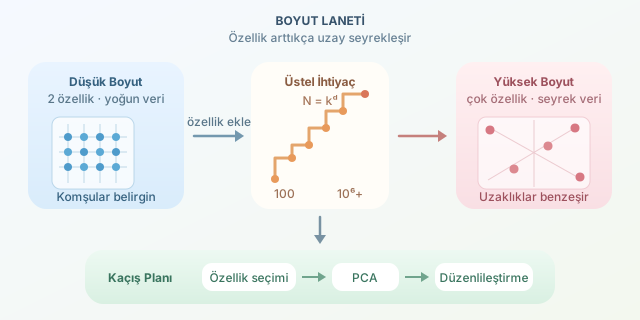
Bir veri setine yeni özellik eklemek ilk bakışta modele daha fazla bilgi vermek demektir. Yaş ve gelir faydalıysa meslek, şehir ve alışveriş geçmişi de faydalı olmaz mı? Ne yazık ki özellik sayısı büyüdükçe veri uzayı akıl almaz bir hızla genişler. Örnekler birbirinden uzaklaşır, benzerlik ölçümleri anlamını kaybeder ve model, kalabalık görünen bir veri setinde adeta tek başına kalır. İşte bu olaya boyut laneti denir.
Devamı...
Bir arkadaş grubundaki insanları önce en çok benzeyen ikililerden başlayarak bir araya getirdiğinizi düşünün. Sonra bu küçük grupları daha büyük topluluklarla birleştirin. İşlem tamamlandığında elinizde kimin kime, hangi benzerlik seviyesinde bağlandığını gösteren bir soy ağacı olur. Hiyerarşik kümeleme tam olarak bunu yapar; dendrogram ise ortaya çıkan ilişkilerin görsel haritasıdır.
Devamı...
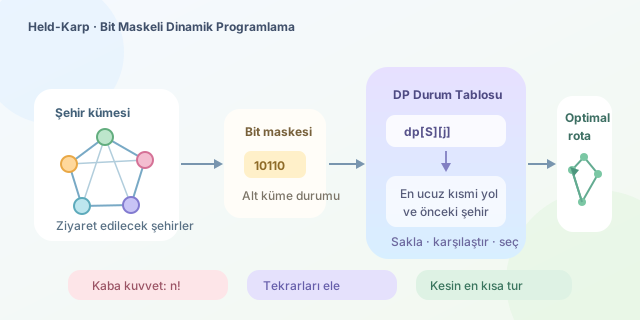
Bir satıcının belirli şehirlerin tümünü tam bir kez ziyaret edip başladığı şehre dönmesi gerekiyor. Üstelik toplam yol mümkün olduğunca kısa olmalı! Gezgin Satıcı Problemi, yani TSP, tanımı basit fakat çözümü hesaplama açısından oldukça zorlu bir optimizasyon problemidir. Held-Karp algoritması ise gereksiz rota tekrarlarını ortadan kaldırarak faktöriyel aramayı dinamik programlama ve bit maskeleri yardımıyla daha yönetilebilir bir üstel çözüme dönüştürür.
Devamı...
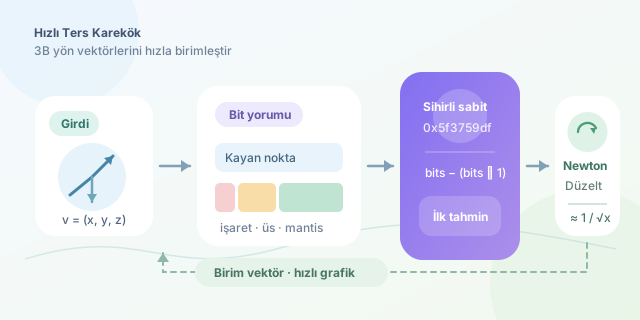
1990’ların oyun motorlarında her işlemci döngüsü değerliydi. Bir vektörü normalize etmek için gereken $1/\sqrt{x}$ hesabı bile performansı ciddi biçimde etkileyebiliyordu. Fast Inverse Square Root algoritması, kayan noktalı sayının bitlerini bir tamsayı gibi yorumlayıp yaklaşık sonucu şaşırtıcı derecede hızlı üretmesiyle ünlendi. Üstelik bunu yalnızca matematikle değil, sayıların bellekteki temsilini yaratıcı biçimde manipüle ederek yapıyordu.
Devamı...
Klasik mantık dünyasında bir önerme ya doğrudur ya da yanlıştır; başka seçenek yoktur. Gerçek hayat ise bu kadar keskin davranmaz. Bir odanın 24 °C olması kimine göre sıcak, kimine göre ılık olabilir. Bulanık mantık, sıcak-soğuk veya hızlı-yavaş gibi dereceli kavramları matematiksel üyelik değerleriyle temsil ederek bilgisayarlara bu belirsizliği yönetme becerisi kazandırır.
Devamı...
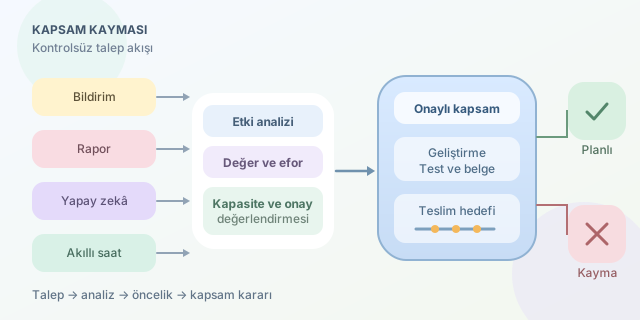
Bir yazılım projesi düşünün: Başlangıçta yalnızca kullanıcıların görev oluşturacağı küçük bir uygulamadır. Sonra bildirimler, raporlar, yapay zekâ, karanlık tema ve hatta akıllı saat desteği istenir. Ekip çalıştığı hâlde bitiş çizgisi sürekli uzaklaşır. İşte bu durum, proje yönetiminin meşhur canavarı kapsam kaymasıdır.
Devamı...
İkili arama ağaçları hızlıdır; ancak elemanlar sıralı geldiğinde zarif bir ağaç yerine tek yönlü bir zincire dönüşebilir. Treap, bu sorunu ikili arama ağacı ile heap yapısını birleştirerek çözer. Her düğüme anahtarın yanında rastgele bir öncelik verir ve böylece ağacın büyük olasılıkla dengeli kalmasını sağlar.
Devamı...
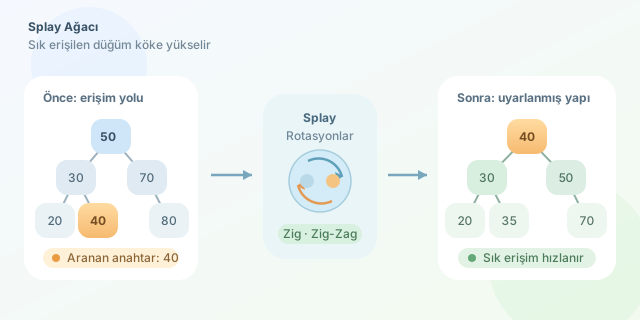
Bazı anahtarlar diğerlerinden daha sık aranıyorsa, neden hepsine aynı mesafeyi sunalım? Splay ağacı, erişilen düğümü rotasyonlarla köke taşıyarak bu soruya oldukça pratik bir cevap verir. Katı denge kurallarıyla uğraşmaz; bunun yerine kullanım alışkanlıklarını öğreniyormuş gibi davranır ve popüler düğümleri el altında tutar.
Devamı...
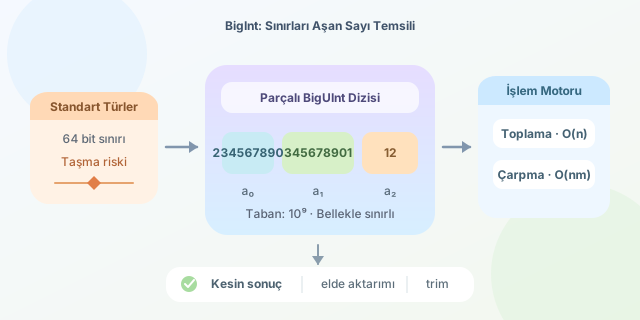
Bir tam sayının milyonlarca basamağı olsaydı onu nasıl toplardınız? Standart veri türleri işlemcinin belirlediği sınırlar içinde yaşarken BigInt yaklaşımı, sayıları küçük parçalara ayırarak bu duvarı aşar. Bu projede veri kaybına uğramadan dev sayıları saklayan, toplayan ve çarpan küçük bir kütüphanenin temelini kuracağız.
Devamı...
Bir şehirdeki tüm veri merkezlerini mümkün olan en düşük kablo maliyetiyle bağlamak istediğinizi düşünün. Her merkez diğer merkezlerle bağlantı kurabilir, ancak bütçe sınırlıdır. İşte Minimum Kapsayan Ağaç (Minimum Spanning Tree, MST) problemi tam olarak bu tür senaryoları çözer. Borůvka algoritması ise MST ailesinin özellikle paralel çalışmaya hevesli, aynı anda birçok işe el atan üyesidir.
Devamı...
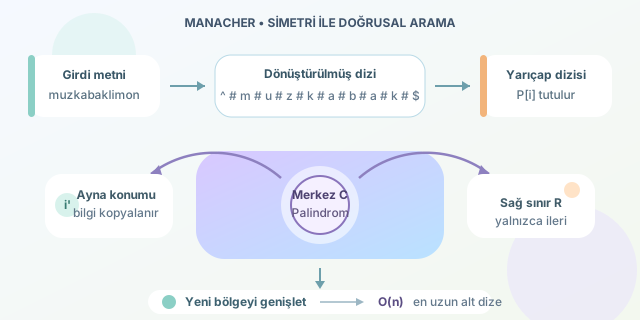
Bir metindeki en uzun palindromu bulmak, ilk bakışta her merkezden sağa ve sola yürümeyi gerektiren yorucu bir iş gibi görünür. Manacher algoritması ise daha önce incelenmiş palindromların simetrisinden yararlanarak aynı karakterleri tekrar tekrar karşılaştırmaz ve problemi doğrusal zamanda çözer. Küçük bir terminoloji notu: Algoritma, karakterlerin bitişik olduğu en uzun palindromik alt dizeyi bulur; palindromik alt dizi problemi farklıdır.
Devamı...
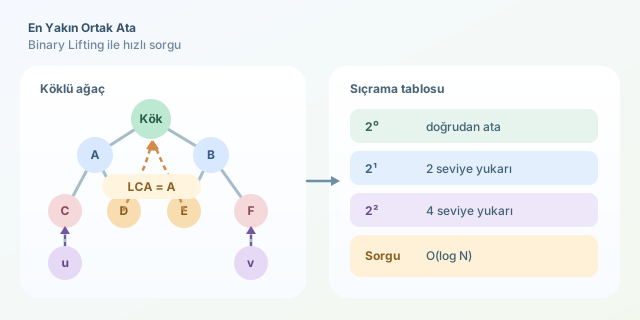
Bir soy ağacında iki kişinin ortak atasını aramak kolay görünebilir; ancak yüz binlerce düğümlü bir ağaçta binlerce sorgu sorulduğunda işler hızla karışır. Lowest Common Ancestor (LCA), iki düğümün ikisine de ata olan en derin düğümü bulur. Binary Lifting ise ön işleme yaparak bu sorguyu oldukça hızlı cevaplamamızı sağlar.
Devamı...
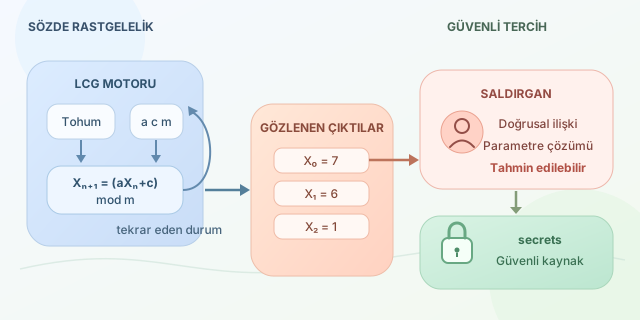
Bilgisayarların zar atması sandığımız kadar gizemli değildir. Çoğu zaman makine, önceki bir sayıyı belirli sabitlerle işleyerek yeni bir sayı üretir. Lineer Kongrüansiyel Üreteç, yani LCG, bu yaklaşımın en eski ve anlaşılır örneklerinden biridir. Hızlı ve öğretici olmasına rağmen güvenlik söz konusu olduğunda bıraktığı matematiksel izler, onu dijital dünyanın fazlasıyla tahmin edilebilir falcısına dönüştürür.
Devamı...
Özyineleme, bir fonksiyonun problemi küçülterek kendisini çağırmasıdır. Zarif görünür; fakat her çağrı bellekte yeni bir yığın çerçevesi oluşturduğunda binlerce adım sonra programımız dramatik biçimde “Stack Overflow!” diye bağırabilir. Kuyruk özyinelemesi (tail recursion), özyinelemeli çağrıyı fonksiyonun son işlemi hâline getirerek çalışma zamanına bu çerçeveleri yeniden kullanma fırsatı verir.
Devamı...
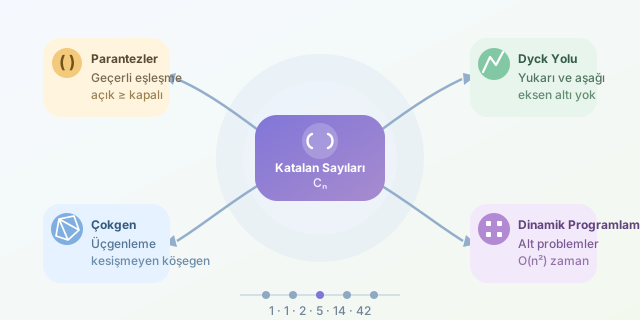
Bir sayı dizisinin hem düzgün parantez ifadelerini hem de çokgenlerin üçgenlere ayrılma biçimlerini sayması ilk bakışta matematiksel bir tesadüf gibi görünebilir. Oysa Katalan sayıları, farklı görünen bu problemlerin altında aynı dallanma ve özyineleme yapısının bulunduğunu gösterir. Dizi $1, 1, 2, 5, 14, 42, 132, \ldots$ biçiminde ilerler ve kombinatoriğin adeta İsviçre çakısıdır.
Devamı...
Bir dizide yüz binlerce kez “şu aralığın toplamı nedir?” diye sormak, her seferinde elemanları tek tek dolaşıyorsak bilgisayarı gereksiz yere maratona çıkarır. Karekök Ayrıştırması, yani Square Root Decomposition, diziyi yaklaşık eşit büyüklükte bloklara bölerek bu sorguları hızlandırır. Segment ağacına göre daha az kod, daha kolay hata ayıklama ve şaşırtıcı derecede iyi performans sunması da cabasıdır.
Devamı...