İçindekiler
Bir müşterinin ekmek ve peynir alırken sepete zeytin de eklemesi tesadüf mü, yoksa tekrar eden bir alışveriş davranışı mı? Apriori algoritması, binlerce işlem kaydının arkasına saklanan bu tür ilişkileri keşfetmek için kullanılan frekans tabanlı bir yöntemdir. Market sepeti analiziyle özdeşleşse de öneri sistemlerinden web kullanım analizine kadar pek çok alanda karşımıza çıkar.
``
Apriori algoritmasının temel fikri
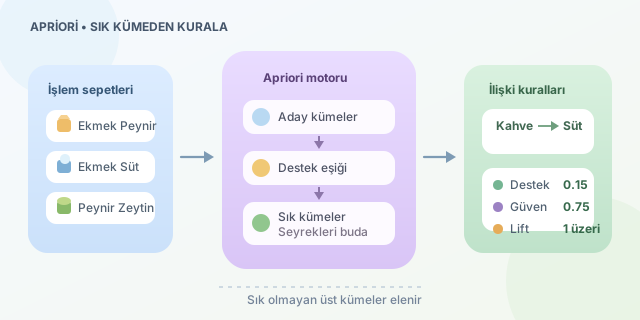
Apriori, sık öğe kümelerini bularak bunlardan ilişki kuralları üretir. Algoritmanın dayandığı Apriori ilkesi oldukça sezgiseldir: Bir öğe kümesi sık görülüyorsa onun bütün alt kümeleri de sık görülmelidir. Tersinden bakarsak sık olmayan bir kümenin daha büyük üst kümelerini incelemek gereksizdir.
Örneğin {ekmek, peynir} yeterince sık görülmüyorsa {ekmek, peynir, zeytin} kümesinin sık çıkması mümkün değildir. Bu özellik, olası kombinasyonların önemli bölümünü erkenden budayarak arama maliyetini azaltır.
Apriori iki aşamada çalışır:
- Minimum destek değerini aşan sık öğe kümelerini bulur.
- Bu kümelerden minimum güven eşiğini aşan ilişki kuralları üretir.
Üç önemli ölçüt
Bir $X \rightarrow Y$ kuralını değerlendirmek için destek, güven ve lift ölçüleri kullanılır.
\[support(X)=\frac{X'i\ içeren\ işlem\ sayısı}{toplam\ işlem\ sayısı}\] \[confidence(X \rightarrow Y)=\frac{support(X \cup Y)}{support(X)}\] \[lift(X \rightarrow Y)=\frac{confidence(X \rightarrow Y)}{support(Y)}\]| Ölçüt | Cevapladığı soru | Yorum |
|---|---|---|
| Destek | Birliktelik ne kadar yaygın? | Yüksek değer, kümenin sık görüldüğünü belirtir. |
| Güven | X alınmışsa Y ne sıklıkla alınır? | Kuralın koşullu doğruluğunu gösterir. |
| Lift | İlişki tesadüften daha güçlü mü? | 1’den büyük değer pozitif ilişkiye işaret eder. |
Diyelim ki 100 alışverişin 20’sinde kahve, 15’inde kahve ve süt bulunuyor. Bu durumda {kahve, süt} desteği $15/100=0.15$, kahve → süt güveni ise $15/20=0.75$ olur. Ancak sütün genel olarak çok popüler olması güven değerini yanıltabilir. Lift, bu nedenle ilişkiyi sütün taban görülme oranıyla karşılaştırır.
Python ile küçük bir uygulama
Aşağıdaki örnek, işlem listesini ikili bir tabloya dönüştürür; ardından sık kümeleri ve kuralları çıkarır:
from mlxtend.preprocessing import TransactionEncoder
from mlxtend.frequent_patterns import apriori, association_rules
import pandas as pd

transactions = [
    ['ekmek', 'peynir', 'zeytin'],
    ['ekmek', 'süt'],
    ['peynir', 'zeytin'],
    ['ekmek', 'peynir'],
    ['ekmek', 'peynir', 'zeytin']
]

encoder = TransactionEncoder()
matrix = encoder.fit(transactions).transform(transactions)
data = pd.DataFrame(matrix, columns=encoder.columns_)

frequent_sets = apriori(
    data,
    min_support=0.4,
    use_colnames=True
)

rules = association_rules(
    frequent_sets,
    metric='confidence',
    min_threshold=0.7
)

print(rules[['antecedents', 'consequents',
             'support', 'confidence', 'lift']])
min_support=0.4, bir kümenin işlemlerin en az yüzde 40’ında bulunmasını şart koşar. min_threshold=0.7 ise güveni yüzde 70’in altında kalan kuralları eler. Eşikler çok yüksek seçilirse değerli ama seyrek ilişkiler kaybolabilir; çok düşük seçilirse de sonuçlar kural çöplüğüne dönüşebilir.
Avantajlar ve sınırlamalar
| Avantaj | Sınırlama |
|---|---|
| Mantığı kolay anlaşılır. | Büyük veri kümelerinde yavaşlayabilir. |
| Kurallar açıklanabilir niteliktedir. | Çok sayıda aday küme üretebilir. |
| Etiketli veriye ihtiyaç duymaz. | Nadir fakat değerli ilişkileri kaçırabilir. |
Apriori sonuçları doğrudan “A ürününü alan herkese B ürününü sat” emri değildir. Kampanya maliyeti, kâr marjı, mevsimsellik ve stok durumu da hesaba katılmalıdır. Yine de algoritma, alışveriş fişlerini sessiz bir veri yığınından çıkarıp anlaşılır davranış ipuçlarına dönüştürür. Kısacası Apriori, müşterinin sepetine bakıp yalnızca ne aldığını değil, ürünlerin neden yan yana gelmiş olabileceğini sorgulayan meraklı bir veri dedektifidir.
Yorumlar