İçindekiler
Bir dizide yüz binlerce kez “şu aralığın toplamı nedir?” diye sormak, her seferinde elemanları tek tek dolaşıyorsak bilgisayarı gereksiz yere maratona çıkarır. Karekök Ayrıştırması, yani Square Root Decomposition, diziyi yaklaşık eşit büyüklükte bloklara bölerek bu sorguları hızlandırır. Segment ağacına göre daha az kod, daha kolay hata ayıklama ve şaşırtıcı derecede iyi performans sunması da cabasıdır. ``
Temel fikir: Diziyi mahallelere ayırmak
Elimizde $n$ elemanlı bir dizi olduğunu düşünelim. Diziyi, her biri yaklaşık
\[B = \lceil\sqrt{n}\rceil\]boyutunda bloklara ayırırız. Böylece blok sayısı da yaklaşık $\sqrt{n}$ olur. Her blok için elemanların toplamı gibi özet bir bilgi saklarız.
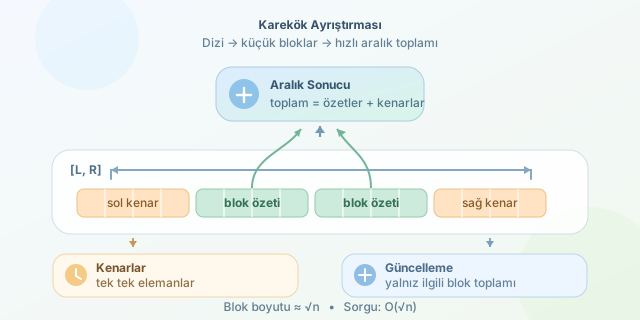
Bir $[L,R]$ aralığını sorgularken üç parçayla karşılaşırız:
- Başlangıçtaki eksik blok elemanları,
- Arada tamamen kapsanan bloklar,
- Sondaki eksik blok elemanları.
Eksik kısımlar tek tek dolaşılırken tam blokların önceden hesaplanmış toplamı kullanılır. En fazla yaklaşık $2\sqrt{n}$ eleman ve $\sqrt{n}$ blok incelendiğinden sorgu karmaşıklığı $O(\sqrt{n})$ olur.
| Yaklaşım | Sorgu | Güncelleme | Uygulama zorluğu |
|---|---|---|---|
| Doğrudan dolaşma | $O(n)$ | $O(1)$ | Çok kolay |
| Prefix sum | $O(1)$ | $O(n)$ | Kolay |
| Karekök ayrıştırması | $O(\sqrt{n})$ | $O(1)$ | Orta-kolay |
| Segment ağacı | $O(\log n)$ | $O(\log n)$ | Orta-zor |
Buradaki $O(1)$ güncelleme, bir elemanın değeri değiştirildiğinde ilgili blok toplamının fark kadar düzeltilmesini ifade eder.
C++ ile uygulanması
Aşağıdaki sınıf, kapsayıcı $[L,R]$ aralığının toplamını hesaplar ve noktasal güncelleme yapar:
#include <iostream>
#include <vector>
#include <cmath>
using namespace std;

class SqrtDecomposition {
    vector<long long> data, blockSum;
    int n, blockSize;

public:
    SqrtDecomposition(const vector<long long>& input) {
        data = input;
        n = data.size();
        blockSize = max(1, (int)ceil(sqrt(n)));
        blockSum.assign((n + blockSize - 1) / blockSize, 0);

        for (int i = 0; i < n; ++i)
            blockSum[i / blockSize] += data[i];
    }

    void update(int index, long long newValue) {
        int block = index / blockSize;
        blockSum[block] += newValue - data[index];
        data[index] = newValue;
    }

    long long query(int left, int right) {
        long long result = 0;

        while (left <= right && left % blockSize != 0)
            result += data[left++];

        while (left + blockSize - 1 <= right) {
            result += blockSum[left / blockSize];
            left += blockSize;
        }

        while (left <= right)
            result += data[left++];

        return result;
    }
};
İlk döngü sorgunun sol kenarını bir blok başlangıcına taşır. İkinci döngü tam blokların hazır toplamlarını kullanır. Son döngü ise sağ tarafta kalan elemanları toplar. Güncellemede eski ve yeni değer arasındaki farkın blok toplamına eklenmesi, bloğu baştan hesaplama ihtiyacını ortadan kaldırır.
Yalnızca toplam için mi kullanılır?
Hayır. Her blokta probleme uygun farklı bilgiler tutulabilir:
| Sorgu türü | Blokta saklanan bilgi |
|---|---|
| Aralık toplamı | Elemanların toplamı |
| Minimum veya maksimum | Blok minimumu/maksimumu |
| Belirli değerden küçük eleman sayısı | Sıralanmış eleman listesi |
| Frekans sorgusu | Değer-sayaç tablosu |
Örneğin her bloğun elemanlarını sıralı tutarsak, bir blokta $x$ değerinden küçük elemanların sayısını lower_bound ile bulabiliriz. Tam bloklarda ikili arama yapılır; kenarlardaki elemanlar yine tek tek kontrol edilir. Böylece daha karmaşık sorgular yaklaşık $O(\sqrt{n}\log n)$ sürede cevaplanabilir. Ancak bir eleman değiştiğinde ilgili sıralı bloğun da güncellenmesi gerekir.
Ne zaman tercih edilmeli?
Karekök ayrıştırması; veri boyutu orta veya büyükse, hem sorgu hem güncelleme varsa ve segment ağacının ek karmaşıklığı istenmiyorsa güçlü bir seçenektir. Segment ağacı asimptotik olarak daha hızlıdır, fakat sabit maliyetleri ve kod uzunluğu daha fazladır. Özellikle yarışma programlamasında hızlı geliştirilen çözümler, prototipler ve blok bazında özel bilgi tutulması gereken problemler için karekök ayrıştırması adeta algoritmik bir çakı gibidir: küçük, pratik ve çoğu zaman fazlasıyla yeterli.
Yorumlar