İçindekiler
Bir arkadaş grubundaki insanları önce en çok benzeyen ikililerden başlayarak bir araya getirdiğinizi düşünün. Sonra bu küçük grupları daha büyük topluluklarla birleştirin. İşlem tamamlandığında elinizde kimin kime, hangi benzerlik seviyesinde bağlandığını gösteren bir soy ağacı olur. Hiyerarşik kümeleme tam olarak bunu yapar; dendrogram ise ortaya çıkan ilişkilerin görsel haritasıdır.
``
Hiyerarşik kümeleme nedir?
Hiyerarşik kümeleme, etiketlenmemiş veri noktalarını benzerliklerine göre iç içe geçmiş gruplara ayıran gözetimsiz öğrenme yöntemidir. K-means algoritmasının aksine, başlangıçta küme sayısını kesin olarak belirtmek zorunda değildir. Bunun yerine veriler arasında aşamalı bir hiyerarşi oluşturur.
İki temel yaklaşım bulunur:
| Yaklaşım | Başlangıç | İşleyiş | Benzetme |
|---|---|---|---|
| Birleştirici (Agglomerative) | Her nokta ayrı kümedir | En yakın kümeler birleşir | Küçük derelerin nehre dönüşmesi |
| Bölücü (Divisive) | Tüm noktalar tek kümedir | Büyük küme parçalara ayrılır | Bir şirketin departmanlara bölünmesi |
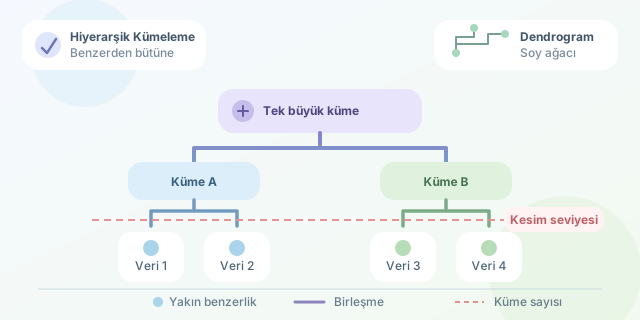
En yaygın seçenek birleştirici yaklaşımdır. $n$ veri noktasıyla başlanır; başlangıçta $n$ ayrı küme vardır. Her adımda en benzer iki küme birleşir ve küme sayısı bir azalır. Sonunda bütün noktalar tek bir dev kümede buluşur.
Uzaklık: Benzerliğin sayısal karşılığı
Algoritmanın çalışması için iki noktanın ne kadar yakın olduğunun hesaplanması gerekir. Sayısal özelliklerde sık kullanılan Öklid uzaklığı şöyledir:
\[d(x,y) = sqrt((x_1-y_1)^2 + (x_2-y_2)^2 + ... + (x_p-y_p)^2)\]Uzaklık küçüldükçe noktalar daha benzerdir. Ancak farklı ölçeklerdeki özellikler sonucu bozabilir. Örneğin yaş 18–70 aralığındayken yıllık gelir 20.000–500.000 aralığındaysa gelir değişkeni mesafeyi ele geçirir. Bu nedenle standartlaştırma son derece önemlidir:
\[z = (x - ortalama) / standartSapma\]Kümeler arası bağlantı nasıl seçilir?
Tek tek noktaların uzaklığını bilmek yetmez; iki kümenin birbirine uzaklığını da tanımlamak gerekir. Bu kurala bağlantı yöntemi denir.
| Yöntem | Temel fikir | Davranış |
|---|---|---|
| Single | En yakın iki noktayı kullanır | Uzun, zincir biçimli kümeler üretebilir |
| Complete | En uzak iki noktayı kullanır | Daha sıkı kümeler oluşturur |
| Average | Tüm çiftlerin ortalamasını alır | Dengeli bir uzlaşma sağlar |
| Ward | Küme içi varyans artışını azaltır | Kompakt ve düzenli gruplar üretir |
Ward yönteminde amaç, birleşme sonrasında oluşan hata artışını mümkün olduğunca küçük tutmaktır. Küme içi hata kabaca $SSE = sum((x_i - merkez)^2)$ ile ifade edilir.
Python ile dendrogram oluşturma
Aşağıdaki örnek, müşteri verilerini standartlaştırır ve Ward bağlantısıyla bir dendrogram çizer:
import matplotlib.pyplot as plt
from sklearn.preprocessing import StandardScaler
from scipy.cluster.hierarchy import linkage, dendrogram

# Satırlar müşterileri, sütunlar yaş ve harcama puanını temsil eder.
veriler = [
    [22, 18], [25, 22], [27, 20],
    [45, 70], [48, 75], [52, 68],
    [33, 42], [35, 45]
]

# Ölçek farklarının uzaklık hesabını bozmasını engeller.
olcekli_veriler = StandardScaler().fit_transform(veriler)

# Birleşme sırasını ve birleşme uzaklıklarını hesaplar.
baglantilar = linkage(olcekli_veriler, method="ward")

plt.figure(figsize=(9, 5))
dendrogram(baglantilar)
plt.xlabel("Veri noktaları")
plt.ylabel("Birleşme uzaklığı")
plt.title("Müşteri Dendrogramı")
plt.show()
Grafikteki yapraklar veri noktalarını, yatay birleşme çizgileri ise kümelerin birleştiği seviyeleri gösterir. Dikey eksendeki büyük sıçramalar, birbirinden belirgin biçimde farklı grupların zorla birleştirildiğine işaret eder.
Dendrogram nasıl kesilir?
Küme sayısını belirlemek için dendrogram üzerinde yatay bir kesim çizgisi hayal edilir. Çizginin kestiği dikey dal sayısı yaklaşık küme sayısını verir. Genellikle birleşme uzaklığındaki en büyük sıçramanın altından kesmek mantıklıdır. Örneğin çizgi üç dalı kesiyorsa veriler üç küme olarak yorumlanabilir.
Yine de dendrogram sihirli bir fal makinesi değildir. Aykırı değerler, yanlış ölçeklendirme ve bağlantı yöntemi sonucu ciddi biçimde değiştirebilir. Ayrıca klasik uygulamalar büyük veri kümelerinde yüksek bellek ve işlem maliyeti oluşturur. Buna karşılık küçük ve orta ölçekli verilerde yalnızca kümeleri değil, kümelerin nasıl meydana geldiğini de göstermesi büyük avantajdır. Kısacası dendrogram, veriye “Kaç grup var?” sorusunun yanında “Bu gruplar birbirine nasıl akraba?” sorusunu da sordurur.
Yorumlar