İçindekiler
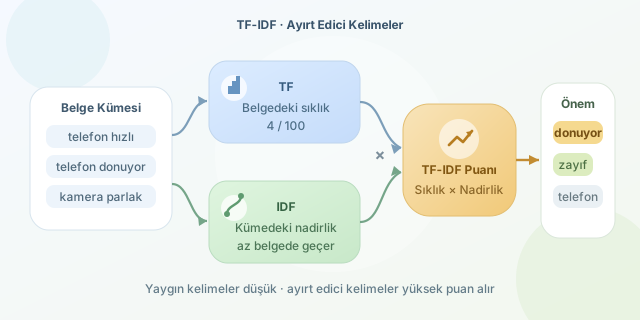
Bir metinde en çok geçen kelime, her zaman en önemli kelime değildir. Örneğin “ve”, “bir” veya “için” yüzlerce belgede sıkça görülebilir; ancak bu kelimeler bize belgenin konusu hakkında pek ipucu vermez. TF-IDF, bir kelimenin belge içindeki sıklığı ile bütün veri kümesindeki nadirliği arasında denge kurarak ayırt edici kelimeleri öne çıkarır.
``
Temel fikir: Sıklık tek başına yeterli değil
Bir e-ticaret yorumunda “telefon” kelimesinin beş kez geçtiğini düşünelim. Bu sıklık, kelimenin yorum açısından önemli olduğunu gösterebilir. Fakat veri kümemizdeki bütün yorumlar telefonlarla ilgiliyse “telefon” kelimesi sınıfları ayırmakta pek işe yaramaz. Buna karşılık yalnızca bazı olumsuz yorumlarda görülen “donuyor” kelimesi, sınıflandırma modeli için çok daha değerli olabilir.
TF-IDF iki bileşeni bir araya getirir:
| Bileşen | Ölçtüğü özellik | Yüksek olması ne anlatır? |
|---|---|---|
| TF | Kelimenin belirli bir belgedeki sıklığı | Kelime, bu belgede sık kullanılmıştır |
| IDF | Kelimenin veri kümesindeki nadirliği | Kelime, belgeleri birbirinden ayırabilir |
| TF-IDF | Sıklık ve nadirliğin birleşimi | Kelime, belge için ayırt edicidir |
TF: Terim sıklığı
Bir $t$ kelimesinin $d$ belgesindeki terim sıklığı şöyle hesaplanabilir:
\[TF(t,d) = \frac{f_{t,d}}{\sum_k f_{k,d}}\]Burada $f_{t,d}$, kelimenin belgede kaç kez geçtiğini; paydadaki toplam ise belgedeki bütün kelimelerin sayısını gösterir. Uzun belgelerin doğal olarak daha fazla kelime içermesi nedeniyle normalizasyon yapılır.
Örneğin 100 kelimelik bir belgede “python” dört kez geçiyorsa:
\[TF(\text{python},d) = \frac{4}{100} = 0.04\]IDF: Ters belge sıklığı
IDF, her yerde görülen kelimelerin puanını azaltır:
\[IDF(t) = \log\left(\frac{N}{df(t)}\right)\]$N$ toplam belge sayısı, $df(t)$ ise kelimenin bulunduğu belge sayısıdır. Kelime az sayıda belgede geçiyorsa kesir ve dolayısıyla IDF değeri büyür. Uygulamalarda sıfıra bölünme gibi sorunları engellemek için formüle yumuşatma eklenebilir:
\[IDF(t) = \log\left(\frac{1+N}{1+df(t)}\right)+1\]Son puan iki değerin çarpımıdır:
\[TFIDF(t,d) = TF(t,d) \times IDF(t)\]| Kelime türü | TF | IDF | Beklenen sonuç |
|---|---|---|---|
| Belgede sık, veri kümesinde nadir | Yüksek | Yüksek | Çok önemli |
| Belgede sık, her belgede yaygın | Yüksek | Düşük | Sınırlı öneme sahip |
| Belgede seyrek, veri kümesinde nadir | Düşük | Yüksek | Orta düzeyde önemli |
| Belgede yok | 0 | Fark etmez | Puan 0 |
Python ile TF-IDF hesaplama
Scikit-learn, metinleri doğrudan TF-IDF özellik matrisine dönüştürür:
from sklearn.feature_extraction.text import TfidfVectorizer

belgeler = [
    "telefon hızlı çalışıyor batarya güçlü",
    "telefon sürekli donuyor batarya zayıf",
    "kamera kaliteli ve ekran parlak"
]

vektorlestirici = TfidfVectorizer()
matris = vektorlestirici.fit_transform(belgeler)

kelimeler = vektorlestirici.get_feature_names_out()
puanlar = matris.toarray()

for kelime, puan in sorted(
    zip(kelimeler, puanlar[1]),
    key=lambda oge: oge[1],
    reverse=True
):
    if puan > 0:
        print(kelime, round(puan, 3))
Kod, önce kelime sözlüğünü oluşturur; ardından her belgeyi sayısal bir vektöre çevirir. İkinci yorumdaki puanlar sıralandığında “donuyor” ve “zayıf” gibi daha ayırt edici ifadelerin üst sıralara çıkması beklenir. Ortaya çıkan matris; lojistik regresyon, destek vektör makineleri veya Naive Bayes gibi sınıflandırıcılara verilebilir.
Dikkat edilmesi gerekenler
TF-IDF kelimelerin anlamını veya sırasını öğrenmez. “Ürün iyi değil” ifadesindeki olumsuzluğu tek kelimelik özelliklerle kaçırabilir. Bu durumda ngram_range=(1, 2) kullanılarak “iyi değil” gibi ikili kalıplar yakalanabilir. Stop-word temizliği, kök bulma ve küçük harfe dönüştürme de sonuçları etkiler.
Kısacası TF-IDF, “Bu kelime burada sık mı?” ve “Başka yerlerde ne kadar nadir?” sorularını aynı anda sorar. Basit, hızlı ve yorumlanabilir olması sayesinde metin sınıflandırma projeleri için hâlâ güçlü bir başlangıç noktasıdır.
Yorumlar