İçindekiler
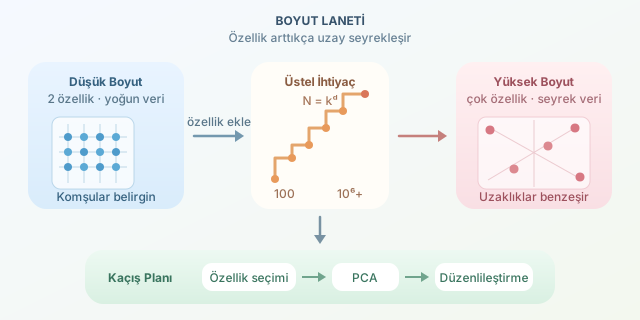
Bir veri setine yeni özellik eklemek ilk bakışta modele daha fazla bilgi vermek demektir. Yaş ve gelir faydalıysa meslek, şehir ve alışveriş geçmişi de faydalı olmaz mı? Ne yazık ki özellik sayısı büyüdükçe veri uzayı akıl almaz bir hızla genişler. Örnekler birbirinden uzaklaşır, benzerlik ölçümleri anlamını kaybeder ve model, kalabalık görünen bir veri setinde adeta tek başına kalır. İşte bu olaya boyut laneti denir.
``
Boyut arttığında gerçekte ne olur?
Her özellik, veri uzayına yeni bir eksen ekler. İki özellikli bir veri noktası düzlemde, üç özellikli bir nokta küpte bulunur. Ancak 100 özellikli bir örnek, zihnimizde canlandırmakta zorlandığımız 100 boyutlu bir uzayın içindedir.
Her ekseni $k$ parçaya bölerek uzayı aynı yoğunlukta örneklemek istediğimizi düşünelim. Gerekli örnek sayısı:
\[N = k^d\]Burada $d$ özellik sayısıdır. Her eksende yalnızca 10 farklı bölge bulunması durumunda 2 boyut için $10^2=100$, 6 boyut içinse $10^6=1.000.000$ örnek gerekir. Yani özellik sayısı doğrusal artarken uzayı doldurma ihtiyacı üstel büyür.
| Boyut sayısı | Eksen başına 10 bölge için örnek | Genel durum |
|---|---|---|
| 2 | 100 | Yönetilebilir |
| 3 | 1.000 | Hâlâ makul |
| 6 | 1.000.000 | Oldukça pahalı |
| 10 | 10.000.000.000 | Pratikte zor |
Uzaklıkların anlamını kaybetmesi
KNN, K-Means ve çekirdek tabanlı yöntemler gibi algoritmalar uzaklık kavramına dayanır. Yüksek boyutta noktalar seyrekleştiği için en yakın ve en uzak komşular arasındaki göreli fark küçülmeye başlar. Sezgisel olarak:
\[R = \frac{d_{max}-d_{min}}{d_{min}}\]Boyut arttıkça $R$ çoğu veri dağılımında sıfıra yaklaşabilir. Böylece algoritma, “Bu iki müşteri birbirine benziyor” demekte zorlanır. Herkes herkese neredeyse aynı uzaklıktadır; veri uzayı biraz tatsız bir sosyal etkinliğe dönüşür.
| Düşük boyut | Yüksek boyut |
|---|---|
| Veriler daha yoğundur | Veriler seyrektir |
| Komşuluklar belirgindir | Uzaklıklar benzeşir |
| Daha az örnek yeterlidir | Çok daha fazla örnek gerekir |
| Genelleme daha kolaydır | Aşırı öğrenme riski yükselir |
Eğitim ve doğruluk neden etkilenir?
Daha fazla özellik; daha fazla hesaplama, bellek kullanımı ve öğrenilecek ilişki anlamına gelir. Özellikle gereksiz özellikler modele sinyal değil, gürültü taşır. Model eğitim verisini ezberleyebilir; eğitim doğruluğu yükselirken test doğruluğu düşebilir.
Bununla birlikte her algoritmanın eğitim süresi doğrudan üstel artmaz. Örneğin bazı yöntemlerin maliyeti yaklaşık $O(nd)$ olabilir. Üstel olan temel sorun, uzayı aynı yoğunlukta temsil etmek için gereken veri miktarıdır. Eğitim maliyeti ise seçilen algoritmaya göre doğrusal, karesel veya daha kötü büyüyebilir.
Aşağıdaki Python örneği, boyut arttıkça rastgele noktaların uzaklıklarının nasıl birbirine benzediğini gösterir:
import numpy as np

for dimension in [2, 10, 100, 500]:
    points = np.random.rand(1000, dimension)
    distances = np.linalg.norm(points[1:] - points[0], axis=1)
    relative_spread = (distances.max() - distances.min()) / distances.min()
    print(dimension, round(relative_spread, 3))
Kod, bir referans noktasının diğer noktalara Öklid uzaklıklarını hesaplar. Boyut yükseldikçe relative_spread değerinin genel olarak küçülmesi, yakın ve uzak kavramlarının ayırt ediciliğini kaybettiğini gösterir.
Lanetten kaçış planı
İlk çözüm, her özelliği sorgulamaktır: Gerçekten tahmine katkı sağlıyor mu? Özellik seçimi için korelasyon analizi, karşılıklı bilgi, L1 düzenlileştirme veya ağaç tabanlı önem skorları kullanılabilir. PCA, yüksek boyutlu veriyi daha az sayıda bileşene yansıtarak bilgiyi sıkıştırır. Autoencoder gibi sinir ağları da doğrusal olmayan temsiller öğrenebilir.
Özellikleri ölçeklendirmek, düzenlileştirme uygulamak ve çapraz doğrulama kullanmak da önemlidir. Kısacası daha fazla özellik her zaman daha fazla zekâ değildir. Bazen iyi bir modelin ihtiyacı yeni sütunlar değil, gereksiz sütunlardan kurtulacağı sakin ve anlamlı bir uzaydır.
Yorumlar