İçindekiler
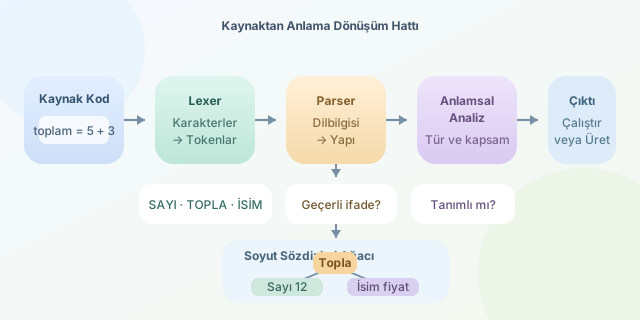
Bilgisayar için toplam = 5 + 3 ifadesi başlangıçta yalnızca karakterlerden oluşan bir dizidir. İnsan gözü bunun bir değişkene toplama sonucunu atadığını hemen anlar; işlemciyse büyücü değildir. Karakterlerin önce sözcüklere, ardından yapısal bir modele dönüştürülmesi gerekir. İşte lexer ve parser, kaynak kod ile anlam arasındaki bu köprünün iki ana mimarıdır.
``
Büyük resim: Karakterden anlama
Tipik bir dil işleme hattı şu şekilde ilerler:
Kaynak kod → Lexer → Token dizisi → Parser → AST → Anlamsal analiz → Çalıştırma/Kod üretimi
Lexer ve parser bazen tek bir araç gibi düşünülür. Oysa farklı sorulara cevap verirler:
| Bileşen | Temel sorusu | Girdi | Çıktı |
|---|---|---|---|
| Lexer | “Buradaki sözcükler neler?” | Karakterler | Token dizisi |
| Parser | “Bu sözcükler geçerli bir yapı oluşturuyor mu?” | Token dizisi | Parse tree veya AST |
| Anlamsal analiz | “Bu yapı gerçekten anlamlı mı?” | AST | Doğrulanmış/açıklanmış AST |
Örneğin 12 + fiyat metni lexer tarafından NUMBER(12), PLUS, IDENTIFIER(fiyat) biçiminde parçalanır. Boşluklar çoğunlukla atılır; fakat Python gibi girintinin anlam taşıdığı dillerde boşluk bile token üretebilir.
Lexer: Karakter avcısı
Lexer, soldan sağa ilerleyerek belirli karakter örüntülerini tanır. Sayılar için [0-9]+, değişken adları için [a-zA-Z_][a-zA-Z0-9_]* benzeri düzenli ifadeler kullanılabilir. Kuramsal olarak lexer kuralları çoğunlukla düzenli dillerle ve sonlu durum makineleriyle modellenir.
$n$ karakterlik bir kaynak metin tek geçişte taranıyorsa ideal zaman karmaşıklığı yaklaşık $O(n)$ olur. Her karakter yalnızca birkaç kez incelendiği için lexer oldukça hızlıdır.
Aşağıdaki küçük Python fonksiyonu sayı, toplama işareti ve isimleri token hâline getirir:
import re

TOKEN_RULES = [
    ("NUMBER", r"\d+"),
    ("PLUS", r"\+"),
    ("IDENTIFIER", r"[A-Za-z_]\w*"),
    ("SPACE", r"\s+"),
]

def tokenize(source):
    pattern = "|".join(
        f"(?P<{name}>{rule})" for name, rule in TOKEN_RULES
    )

    for match in re.finditer(pattern, source):
        token_type = match.lastgroup
        value = match.group()
        if token_type != "SPACE":
            yield token_type, value

print(list(tokenize("12 + fiyat")))
Kod, kuralları isimlendirilmiş gruplar hâlinde birleştirir. Eşleşen grubun adı token türünü, eşleşen metin ise token değerini verir.
Parser: Dilbilgisi hakemi
Tokenların bulunması tek başına yeterli değildir. 12 + + fiyat dizisindeki her parça tanınabilir; ancak bütün ifade dilbilgisel olarak hatalıdır. Parser, tokenların grammar adı verilen kurallara uyup uymadığını denetler.
Basit bir toplama dili şöyle tanımlanabilir:
expression → term (PLUS term)*
term       → NUMBER | IDENTIFIER
Bu kurala göre ifade bir term ile başlamalı, ardından sıfır veya daha fazla PLUS term çifti gelmelidir. Parser başarılı olduğunda genellikle gereksiz noktalama ayrıntılarını dışarıda bırakan bir Soyut Sözdizimi Ağacı, yani AST üretir:
Add
├── Number(12)
└── Identifier(fiyat)
Ağaç yapısı işlem önceliğini de görünür kılar. 2 + 3 * 4 ifadesinin doğru yorumu $2 + (3 \times 4) = 14$ olmalıdır; $(2 + 3) \times 4 = 20$ değil. Grammar, çarpma düğümünün toplama düğümünden daha derinde yer almasını sağlayarak bu farkı kodlar.
Sözdizimi anlam demek değildir
yas + 1 sözdizimsel olarak geçerli olabilir. Ancak yas tanımlanmamışsa veya metin türündeyse anlamsal analiz itiraz eder. Bu aşamada sembol tabloları, kapsam kuralları ve tür denetimi devreye girer.
| Örnek | Lexer | Parser | Anlamsal analiz |
|---|---|---|---|
3 + 4 |
Başarılı | Başarılı | Başarılı |
3 + + 4 |
Başarılı | Hata | Çalışmaz |
olmayan + 4 |
Başarılı | Başarılı | Tanımsız isim hatası |
"merhaba" - 2 |
Başarılı | Başarılı | Tür hatası olabilir |
Kısacası lexer kodun kelimelerini bulur, parser bu kelimelerle cümle kurar, anlamsal analiz ise cümlenin mantıklı olup olmadığını sorgular. Derleyiciler, yorumlayıcılar, IDE renklendirmeleri ve kod analiz araçları bu katmanlardan yararlanır. Kaynak kodun “anlam kazanması” tek bir sihirli adım değil, düzenli ve denetlenebilir bir dönüşüm zinciridir.
Yorumlar