İçindekiler
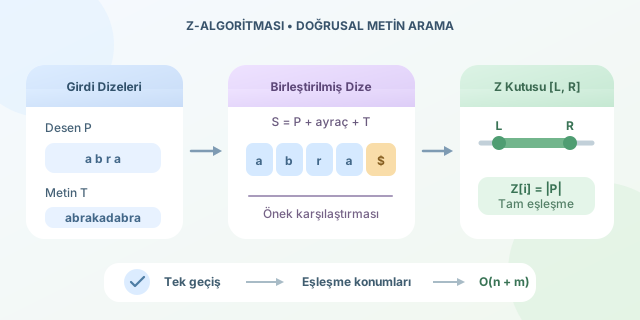
Bir metnin içinde belirli bir deseni aramak, arama motorlarından DNA analizine kadar pek çok alanda karşımıza çıkar. Her konumda karakterleri baştan karşılaştıran basit yöntem kolay anlaşılır olsa da büyük verilerde yavaş kalabilir. Z-Algoritması ise daha önce yapılan karşılaştırmaları akıllıca kullanarak eşleştirme işlemini doğrusal zamanda tamamlar ve KMP’ye güçlü bir alternatif sunar.
``
Problemin Temeli
Elimizde uzunluğu $n$ olan bir metin $T$ ve uzunluğu $m$ olan bir desen $P$ bulunsun. Amacımız, $P$ dizisinin $T$ içinde başladığı bütün konumları tespit etmektir.
Naif yaklaşım, metindeki yaklaşık $n$ konumun her biri için en fazla $m$ karakter karşılaştırır. Dolayısıyla en kötü durumdaki karmaşıklığı:
\[O(n \cdot m)\]olur. Z-Algoritması ise desen ile metni tek bir dizede birleştirerek toplam uzunluk üzerinden çalışır:
\[S = P + \$ + T\]Buradaki \$, desen veya metinde bulunmayan özel bir ayraçtır. Böylece desenin sonuyla metnin başlangıcının yanlışlıkla birleşmesi engellenir.
Z Dizisi Neyi Anlatır?
Bir $S$ dizesi için $Z[i]$, $S[i]$ konumundan başlayan alt dizenin, bütün dizenin başlangıcıyla eşleşen en uzun önek uzunluğudur. Başka bir ifadeyle:
\[Z[i] = \max\{k : S[0\ldots k-1] = S[i\ldots i+k-1]\}\]Örneğin aaaaa için Z dizisi genellikle [0, 4, 3, 2, 1] biçimindedir. Birinci indisten başlayan bölüm, dizenin başlangıcıyla dört karakter boyunca eşleşir.
Metin eşleştirme sırasında herhangi bir konumda $Z[i] = m$ bulunursa, desenin tamamı burada eşleşmiş demektir. Gerçek metin konumu, birleştirilmiş dizideki desen ve ayraç uzunlukları çıkarılarak hesaplanır.
Z Kutusu Mantığı
Algoritmanın hızını sağlayan temel yapı, [L, R] aralığıdır. Bu aralık, başlangıç önekiyle eşleştiği bilinen en sağdaki bölgeyi temsil eder.
- Eğer $i > R$ ise eşleşme doğrudan karakter karşılaştırmalarıyla bulunur.
- Eğer $i \leq R$ ise daha önce hesaplanan bir Z değeri başlangıç tahmini olarak kullanılır.
- Eşleşme kutunun dışına taşarsa karşılaştırmaya devam edilir ve
[L, R]güncellenir.
Her karakter, sağ sınırı yalnızca sınırlı sayıda ilerletebildiği için toplam çalışma süresi $O(n+m)$ olur.
Python ile Uygulama
def z_dizisi(s):
    z = [0] * len(s)
    sol = sag = 0

    for i in range(1, len(s)):
        if i <= sag:
            z[i] = min(sag - i + 1, z[i - sol])

        while i + z[i] < len(s) and s[z[i]] == s[i + z[i]]:
            z[i] += 1

        if i + z[i] - 1 > sag:
            sol, sag = i, i + z[i] - 1

    return z


def z_ile_ara(metin, desen):
    ayirac = '$'
    birlesik = desen + ayirac + metin
    z = z_dizisi(birlesik)
    sonuc = []

    for i, uzunluk in enumerate(z):
        if uzunluk == len(desen):
            sonuc.append(i - len(desen) - 1)

    return sonuc

print(z_ile_ara('abrakadabra', 'abra'))  # [0, 7]
z_dizisi fonksiyonu tekrar kullanılabilir Z değerlerini üretir. z_ile_ara ise desen uzunluğuna eşit değerleri bulup bunları metindeki gerçek indekslere dönüştürür. Üretim kodunda ayıracın girdilerde bulunmadığından emin olunmalıdır.
Z-Algoritması ve KMP Karşılaştırması
| Özellik | Z-Algoritması | KMP |
|---|---|---|
| Ön işleme yapısı | Z dizisi | LPS dizisi |
| Temel fikir | Önekle eşleşme uzunluğu | Önek-sonek ilişkisi |
| Zaman karmaşıklığı | $O(n+m)$ | $O(n+m)$ |
| Ek bellek | $O(n+m)$ | $O(m)$ |
| Kavramsal kullanım | Birleştirilmiş dize | Desen ve metin ayrı |
KMP yalnızca desen için ön işleme yaptığından bellek açısından avantajlı olabilir. Z-Algoritması ise önek eşleşmelerini doğrudan göstermesi sayesinde periyot bulma, tekrar analizi ve dize sıkıştırma gibi problemlerde oldukça sezgiseldir. Kısacası ikisi de aynı asimptotik hıza sahiptir; doğru seçim, problemin yapısına ve hangi yardımcı bilginin daha kullanışlı olduğuna bağlıdır.
Yorumlar