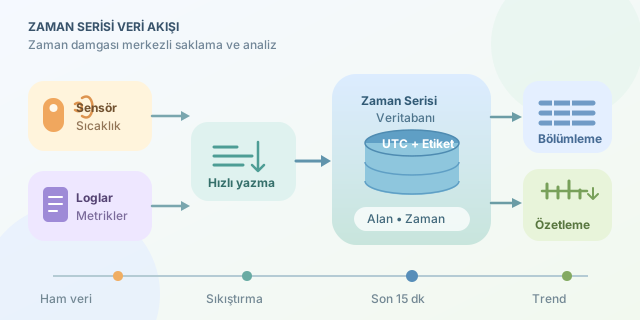
Bir fabrikanın saniyede yüzlerce sıcaklık ölçümü ürettiğini, bir web uygulamasının da her istekte log bıraktığını düşünün. Bu veriler klasik tablolara elbette yazılabilir; fakat sorgular büyüdükçe, disk maliyeti arttıkça ve “son bir saatteki ortalama nedir?” sorusu sıklaştıkça özel bir yaklaşıma ihtiyaç duyulur. Time series (zaman serisi) veritabanları, zaman damgasını verinin merkezine koyarak sensör, metrik, olay ve log akışlarını verimli biçimde saklamak için tasarlanmıştır. ``
Zaman serisi verisinin temel özelliği, her kaydın bir timestamp ile anlam kazanmasıdır. Bir ölçüm çoğunlukla ölçüm adı, etiketler, alanlar ve zamandan oluşur. Örneğin temperature ölçümü; device_id, room gibi etiketlere, value alanına ve ölçüm zamanına sahip olabilir. Etiketler filtreleme ve gruplama için, alanlar ise sayısal veya metinsel asıl değer için kullanılır.
Bir sensörün her $\Delta t$ aralığında veri ürettiğini varsayalım. $N$ sensör ve $T$ süre boyunca yaklaşık kayıt sayısı şöyledir:
\[R = N \times \frac{T}{\Delta t}\]Örneğin 1.000 sensörün saniyede bir ölçüm yaptığı bir sistem, yalnızca bir günde $1000 \times 86400 = 86.400.000$ kayıt üretir. İşte bu hacimde indeksleme stratejisi, sıkıştırma ve veri yaşam döngüsü sıradan bir detay değil, mimarinin kalbidir.
| Özellik | İlişkisel Veritabanı | Time Series Veritabanı |
|---|---|---|
| Ana odak | Genel amaçlı işlemler | Zaman sıralı ölçümler |
| Yazma modeli | Satır bazlı, çeşitli işlemler | Yüksek hızlı ekleme (append) |
| Sorgu tarzı | JOIN ve işlem odaklı | Zaman aralığı, agregasyon, trend |
| Saklama politikası | Genellikle manuel | Retention policy ile otomatik |
| Örnek araçlar | PostgreSQL, MySQL | InfluxDB, TimescaleDB, Prometheus |
Bu sistemlerin performans sırrı, verinin zamana göre bölümlenmesidir. Veriler gün, saat veya belirli zaman pencereleri hâlinde parçalara ayrılabilir; buna partitioning ya da bazı ürünlerde sharding denir. “Son 15 dakika” sorgusu çalıştığında veritabanı yıllar önceki parçalara bakmak zorunda kalmaz. Ayrıca ardışık zaman değerleri arasındaki farklar küçük olduğundan delta encoding, run-length encoding ve sütun bazlı sıkıştırma ciddi alan kazancı sağlar.
Önemli bir kavram da downsampling işlemidir. Ham veriyi kısa süre tutup eski veriyi daha düşük çözünürlükte saklayabilirsiniz. Örneğin saniyelik ölçümler 7 gün, dakikalık ortalamalar 90 gün, saatlik özetler ise 2 yıl korunabilir. Ortalama için kullanılan basit ifade şöyledir:
\[\bar{x} = \frac{1}{n}\sum_{i=1}^{n} x_i\]Bu yaklaşım hem maliyeti azaltır hem de dashboard sorgularını hızlandırır. Ancak minimum ve maksimum değerleri de tutmak gerekir; yalnızca ortalama, kısa süreli ama kritik sıcaklık sıçramalarını gizleyebilir.
Aşağıdaki örnek, InfluxDB satır protokolüyle sıcaklık verisi yazma fikrini gösterir:
from influxdb_client import InfluxDBClient, Point
from datetime import datetime, timezone

client = InfluxDBClient(url="http://localhost:8086", token="TOKEN", org="acme")
write_api = client.write_api()

point = (
    Point("temperature")
    .tag("device_id", "sensor-42")
    .tag("room", "depo")
    .field("value", 23.7)
    .time(datetime.now(timezone.utc))
)

write_api.write(bucket="telemetry", record=point)
Kod, temperature isimli ölçüme iki etiket, bir sayısal alan ve UTC zaman damgası ekler. UTC kullanımı kritiktir: farklı zaman dilimlerindeki cihazlar aynı zaman çizelgesinde güvenilir şekilde karşılaştırılır.
| Tasarım kararı | İyi tercih | Riskli tercih |
|---|---|---|
| Etiket seçimi | Bölge, cihaz tipi gibi sınırlı değerler | Her olay için benzersiz istek ID’si |
| Zaman | UTC ve tutarlı hassasiyet | Yerel saat, karışık formatlar |
| Veri saklama | Ham + özet katmanları | Sonsuza dek ham veri tutmak |
| Yazma | Batch hâlinde gönderim | Her ölçümde tek ağ isteği |
Son olarak cardinality, yani benzersiz etiket kombinasyonu sayısı, dikkatle yönetilmelidir. device_id çoğu zaman mantıklıdır; fakat milyonlarca benzersiz oturum kimliğini etiket yapmak indeksleri şişirebilir. Time series veritabanı seçerken yazma hızı, sorgu dili, retention özellikleri, yüksek erişilebilirlik ve ekosistem entegrasyonlarını birlikte değerlendirin. Doğru modelle kurulduğunda bu veritabanları, gürültülü ölçüm akışlarını okunabilir ve hızlı kararlar üreten zaman hikâyelerine dönüştürür.
Yorumlar