İçindekiler
Birçok algoritmada kümeleri, listeleri veya sözlükleri tekrar tekrar birleştirmemiz gerekir. Bunu dikkatsizce yaptığımızda aynı elemanlar defalarca taşınır ve masum görünen kodumuz kağnı hızına düşer. Küçükten büyüğe birleştirme ya da İngilizce adıyla small-to-large merging, her adımda küçük koleksiyonu büyük koleksiyona ekleyerek toplam maliyeti kontrol altında tutan zarif bir tekniktir.
``
Temel fikir
Elimizde $A$ ve $B$ adında iki küme bulunsun. Bunları birleştirirken hangi kümenin hedef olacağı sonucu değiştirmez; fakat çalışma süresini ciddi biçimde etkiler.
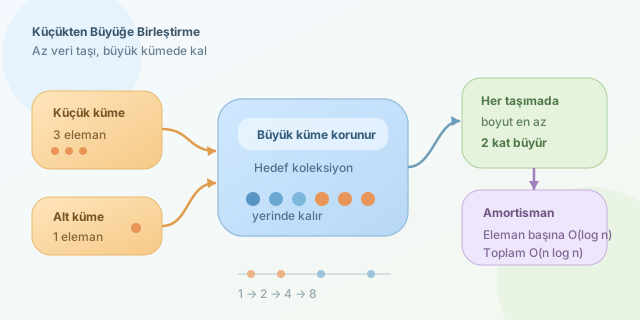
- $\vert A\vert < \vert B\vert $ ise $A$ içindeki elemanları $B$’ye taşı.
- $\vert B\vert < \vert A\vert $ ise $B$ içindeki elemanları $A$’ya taşı.
- Büyük koleksiyon yerinde kalırken yalnızca küçük koleksiyon dolaşılır.
Tekniğin sırrı, taşınan bir elemanın bulunduğu koleksiyonun büyüklüğünün her taşımadan sonra en az iki katına çıkmasıdır. Bir eleman sırasıyla büyüklüğü $1, 2, 4, 8, \ldots$ olan koleksiyonlara geçebilir. Toplam eleman sayısı $n$ olduğuna göre:
\[2^k \leq n \Rightarrow k \leq \log_2 n\]Dolayısıyla her eleman en fazla $O(\log n)$ kez taşınır. Ekleme işlemi sabit maliyetliyse toplam maliyet $O(n\log n)$ olur.
| Yaklaşım | Birleştirme tercihi | Bir elemanın taşınma sayısı | Tipik toplam maliyet |
|---|---|---|---|
| Saf birleştirme | Rastgele veya büyükten küçüğe | $O(n)$ | $O(n^2)$ |
| Small-to-large | Küçük koleksiyon büyüğe | $O(\log n)$ | $O(n\log n)$ |
| Dengeli ağaç kümesi | Küçükten büyüğe, ekleme $O(\log n)$ | $O(\log n)$ | $O(n\log^2 n)$ |
Ağaçlarda kullanım
Yaygın bir problem, köklü bir ağaçta her düğümün alt ağacında kaç farklı renk bulunduğunu hesaplamaktır. Her düğüm için sıfırdan tarama yapmak pahalıdır. Bunun yerine çocuklardan gelen renk kümeleri küçükten büyüğe birleştirilebilir.
#include <iostream>
#include <vector>
#include <set>
using namespace std;

vector<vector<int>> graph;
vector<int> color, answer;

set<int>* dfs(int node, int parent) {
    // Başlangıçta küme yalnızca düğümün kendi rengini içerir.
    set<int>* bag = new set<int>();
    bag->insert(color[node]);

    for (int child : graph[node]) {
        if (child == parent) continue;

        set<int>* childBag = dfs(child, node);

        // Her zaman küçük kümeyi büyük kümeye ekleyeceğiz.
        if (bag->size() < childBag->size()) {
            swap(bag, childBag);
        }

        for (int value : *childBag) {
            bag->insert(value);
        }

        delete childBag;
    }

    answer[node] = static_cast<int>(bag->size());
    return bag;
}
Burada dfs, her alt ağaç için bir renk kümesi döndürür. swap işlemi koleksiyonları kopyalamaz; yalnızca işaretçileri değiştirir. Böylece büyük küme hedef olarak korunur. std::set eklemesi $O(\log n)$ sürdüğü için genel üst sınır $O(n\log^2 n)$ olur. Uygun bir unordered_set kullanılırsa beklenen süre $O(n\log n)$ seviyesine yaklaşabilir; ancak hash çakışmaları ve yeniden boyutlandırma maliyetleri unutulmamalıdır.
Nerelerde işe yarar?
Teknik yalnızca renk kümeleriyle sınırlı değildir. Alt ağaç frekanslarını birleştirme, bağlı bileşenlere veri ekleme, sorguları çevrim dışı işleme ve harita tabanlı sayaçları toplama gibi durumlarda kullanılabilir. DSU birleştirmesinde kullanılan union by size yaklaşımı da aynı düşünce ailesindendir: küçük bileşen büyük bileşene bağlanır.
Dikkat edilmesi gereken nokta, birleştirme yönünün gerçekten boyuta göre seçilmesidir. Ayrıca koleksiyon kopyalamak yerine referans, işaretçi veya taşıma semantiği kullanılmalıdır. Aksi hâlde kazandığımız karmaşıklığı gizli kopyalama maliyetleriyle geri verebiliriz.
Özetle small-to-large, “daha az veriyi hareket ettir” ilkesinin algoritmik hâlidir. Uygulaması birkaç satırlık bir karşılaştırma ve takastan ibaret olsa da karesel çalışan çözümleri çoğu zaman logaritmik amortismanla çok daha ölçeklenebilir hâle getirir.
Yorumlar