İçindekiler
Bir dil modeline hiç var olmayan bir kitap, kişi veya bilimsel makale sorduğunuzda bazen şaşırtıcı derecede ayrıntılı bir cevap alırsınız. Yazar adı, yayın tarihi ve hatta uydurma alıntılar hazırdır! Bu davranış bilinçli bir yalan değil; modelin doğruluğu değil, dilsel devamlılığı optimize etmesinin doğal sonucudur. ``
Dil modeli aslında ne yapıyor?
Büyük dil modelleri metni birer token dizisi olarak işler. Temel görev, önceki tokenlar verilmişken sıradaki tokenın olasılığını tahmin etmektir:
\[P(w_1, w_2, ..., w_n)=P(w_1)P(w_2\vert w_1)...P(w_n\vert w_{<n})\]Model eğitim sırasında doğru sonraki tokena yüksek olasılık vermeye çalışır. Yaygın kayıp fonksiyonu çapraz entropidir:
\[L=-\sum_{t=1}^{n}\log P_\theta(w_t\vert w_{<t})\]Buradaki kritik ayrıntı şudur: Denklemde “Bu ifade gerçek mi?” diye soran bir terim yoktur. Model, gerçek dünyayı doğrudan gözlemlemek yerine eğitim metinlerindeki örüntüleri öğrenir. “Profesör Ayşe Yılmaz’ın 2018 tarihli makalesi” biçimsel olarak çok makul bir diziyse, gerçekte böyle bir makale bulunmasa bile model bu ifadeyi üretebilir.
| Modelin optimize ettiği | Kullanıcının beklediği |
|---|---|
| Olası sonraki token | Doğru bilgi |
| Akıcı ve tutarlı cümle | Doğrulanabilir iddia |
| Eğitim verisine benzer örüntü | Güncel gerçeklik |
| Kullanıcı talebini sürdürmek | Gerektiğinde “bilmiyorum” demek |
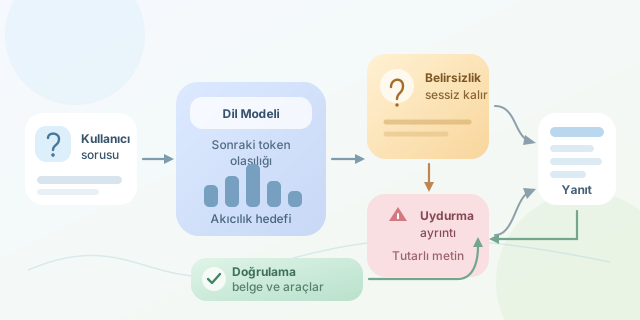
Belirsizlik neden sessiz kalmıyor?
Model, her adımda olası tokenlar için bir dağılım üretir. Örneğin hayalî bir kitabın yazarı sorulduğunda isimler arasında kararsız kalabilir. Bu belirsizlik entropiyle ölçülebilir:
\[H(P)=-\sum_i P(i)\log P(i)\]Yüksek entropi, seçeneklerin birbirine yakın olduğunu gösterir; ancak standart üretim süreci bu durumu kullanıcıya açıklamak zorunda değildir. Sistem yine bir token seçer ve yoluna devam eder. İlk uydurma seçim, sonraki tokenların bağlamına dönüşür. Böylece küçük bir tahmin hatası, tutarlı bir biyografi veya kaynakça hâline gelebilir.
Aşağıdaki basitleştirilmiş kod, seçimin sıcaklığa göre nasıl değiştiğini gösterir:
import numpy as np

logits = np.array([2.0, 1.8, 1.2])
labels = ["Ayşe Yılmaz", "Mehmet Kaya", "Bilmiyorum"]

def probabilities(logits, temperature=1.0):
    scaled = logits / temperature
    exp_values = np.exp(scaled - scaled.max())
    return exp_values / exp_values.sum()

for temperature in [0.3, 1.0, 2.0]:
    probs = probabilities(logits, temperature)
    print(temperature, dict(zip(labels, probs.round(3))))
Düşük sıcaklık en güçlü tahmini baskınlaştırır; yüksek sıcaklık çeşitliliği artırır. Fakat sıcaklığı düşürmek gerçeği garanti etmez. En yüksek olasılıklı seçenek yanlışsa model yalnızca daha kararlı biçimde yanlış cevap verir.
Akıcılık neden doğruluk gibi görünüyor?
İnsanlar düzgün dil, ayrıntı ve özgüvenli anlatımı uzmanlık işareti saymaya eğilimlidir. Dil modelleri ise tam olarak bu yüzey özelliklerinde çok başarılıdır. Eğitim verilerinde akademik makalelerin, haberlerin ve teknik belgelerin biçimini gördükleri için kaynağı olmayan bir iddiayı bile uygun terminolojiyle süsleyebilirler.
| Durum | Halüsinasyon riski |
|---|---|
| Yaygın ve sabit bilgi | Düşük |
| Nadir kişi veya olay | Yüksek |
| Eğitim sonrasındaki gelişme | Çok yüksek |
| Kesin kaynak ve bağlantı isteme | Yüksek |
| Sağlanan belgede cevap arama | Daha düşük |
Problem nasıl azaltılır?
RAG yaklaşımı, modele yanıt öncesinde güvenilir belgeler getirir. Araç kullanımı hesaplama, veritabanı sorgulama ve kaynak doğrulamayı mümkün kılar. İnce ayar ve insan geri bildirimi de modelin belirsizken “Bilmiyorum” demesini teşvik edebilir. Ayrıca cevapların alıntılarla desteklenmesi ve bağımsız sistemlerle kontrol edilmesi önemlidir.
Yine de sıfır halüsinasyon garantisi zordur. Çünkü akıcı metin üretmek ile dünyaya ilişkin doğrulanmış bir inanç taşımak aynı şey değildir. Dil modeli gerçeğin ansiklopedisi değil, olası cümlelerin son derece güçlü bir simülatörüdür. Bu nedenle en güvenli yaklaşım şudur: Yapay zekâyı yaratıcı bir yardımcı olarak kullanın, kritik konularda ise ne kadar özgüvenli görünürse görünsün cevabı doğrulayın.
Yorumlar