İçindekiler
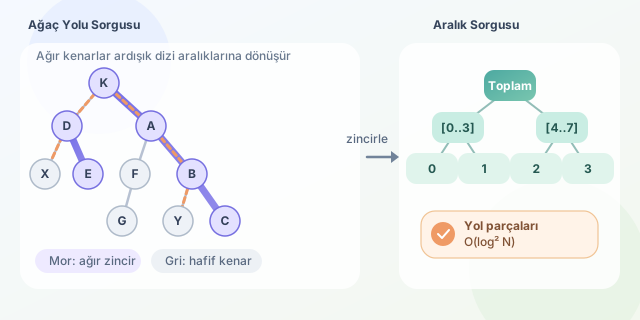
Ağaçlar; organizasyon şemalarından dosya sistemlerine, oyun haritalarından ağ topolojilerine kadar pek çok yerde karşımıza çıkar. Ancak iki düğüm arasındaki yol üzerindeki toplamı, maksimumu veya güncellemeleri hızlı biçimde hesaplamak istediğimizde klasik DFS yaklaşımı yetersiz kalır. Heavy-Light Decomposition (HLD), ağacı parçalara ayırarak bu karmaşık yol sorgularını etkileyici biçimde hızlandıran güçlü bir tekniktir. ``
Temel fikir: Ağacı zincirlere ayırmak
HLD’nin amacı, bir ağaçtaki düğümleri ağır (heavy) ve hafif (light) kenarlar üzerinden zincirlere bölmektür. Önce ağacı seçtiğimiz bir kökten köklendiririz. Her düğüm için alt ağacının boyutunu hesaplarız:
\[size(v) = 1 + \sum_{u \in children(v)} size(u)\]Bir düğümün çocukları arasında alt ağacı en büyük olan çocuk, genellikle ağır çocuk seçilir. Bu çocuğa giden kenar heavy edge olur; diğer tüm çocuk bağlantıları ise light edge kabul edilir. Ağır kenarların ardışık olduğu düğümler bir zincir oluşturur.
Bu seçimin sihri şurada saklıdır: Hafif bir kenardan aşağı indiğinizde alt ağacın boyutu en az yarıya düşer. Dolayısıyla kökten herhangi bir düğüme giderken en fazla $O(\log N)$ hafif kenar geçebilirsiniz. Bir yol sorgusu da en fazla $O(\log N)$ zincir parçasına ayrılır.
| Yaklaşım | Yol Toplamı Sorgusu | Noktasal Güncelleme | Not |
|---|---|---|---|
| Her sorguda DFS | $O(N)$ | $O(1)$ | Küçük veri için yeterli |
| LCA tekniği | Bazı sabit sorgularda $O(\log N)$ | Zor | Toplam/maksimum için doğrudan uygun değil |
| HLD + Segment Tree | $O(\log^2 N)$ | $O(\log N)$ | Esnek ve yaygın çözüm |
Neden segment tree ile kullanılır?
Zincirler oluşturulduktan sonra düğümlere bir dizi üzerindeki konumlarını temsil eden pos değerleri verilir. Aynı ağır zincirdeki düğümler dizide ardışık konumlara yerleşir. Böylece bir zincirin belirli parçasındaki değerleri, sıradan bir aralık sorgusuna dönüştürebiliriz.
Segment tree; toplam, minimum, maksimum, XOR veya GCD gibi birleşebilir işlemleri hızlı hesapladığı için HLD’nin ideal ortağıdır. Fenwick Tree de yalnızca toplama gibi terslenebilir işlemlerde daha hafif bir alternatif olabilir.
C++ ile temel iskelet
Aşağıdaki kod, alt ağaç boyutlarını hesaplar ve ağır çocukları belirler. heavy[v], v düğümünden devam eden ağır zincirin sonraki düğümünü tutar.
const int N = 200005;
vector<int> graph[N];
int parent[N], depth[N], subtree[N], heavy[N];

int dfs(int v, int p) {
    parent[v] = p;
    subtree[v] = 1;
    heavy[v] = -1;
    int bestSize = 0;

    for (int u : graph[v]) {
        if (u == p) continue;
        depth[u] = depth[v] + 1;
        int childSize = dfs(u, v);
        subtree[v] += childSize;

        if (childSize > bestSize) {
            bestSize = childSize;
            heavy[v] = u;
        }
    }
    return subtree[v];
}
İkinci DFS aşamasında zincir başları (head) ve dizi konumları (pos) atanır. Yol sorgusunda iki düğüm farklı zincirlerdeyse, daha derindeki zincirin başı ile düğüm arasındaki segment tree sonucu alınır; ardından düğümün ebeveyn zincirine çıkılır. Zincir başları eşitlendiğinde geriye kalan aralık tek bir segment sorgusudur.
while (head[a] != head[b]) {
    if (depth[head[a]] < depth[head[b]]) swap(a, b);
    answer += segmentQuery(pos[head[a]], pos[a]);
    a = parent[head[a]];
}
if (depth[a] > depth[b]) swap(a, b);
answer += segmentQuery(pos[a], pos[b]);
Burada answer += toplama sorgusunu temsil eder. Maksimum arıyorsanız max, XOR arıyorsanız ^ kullanmalısınız. İşlemin birleşme kuralı, segment tree mantığıyla uyumlu olmalıdır.
Pratikte dikkat edilmesi gerekenler
HLD özellikle $N, Q \approx 10^5$ veya daha büyük olduğunda parlar. Kenar değerleriyle çalışıyorsanız, her kenarın değerini genellikle daha derin olan uç düğümün konumunda saklamak işleri sadeleştirir. Ayrıca yol üzerindeki işlem yön bağımlıysa — örneğin karakter birleştirme — sorgu sonuçlarını ters sırada birleştirme ihtiyacını unutmayın.
Özetle HLD, karmaşık görünen ağaç yollarını birkaç dizi aralığına dönüştürür. İlk bakışta iki DFS, zincir başları ve segment tree biraz kalabalık görünse de; mantık oturduğunda rekabetçi programlamanın ve büyük ölçekli ağaç sorgularının en güvenilir araçlarından birine dönüşür.
Yorumlar