İçindekiler
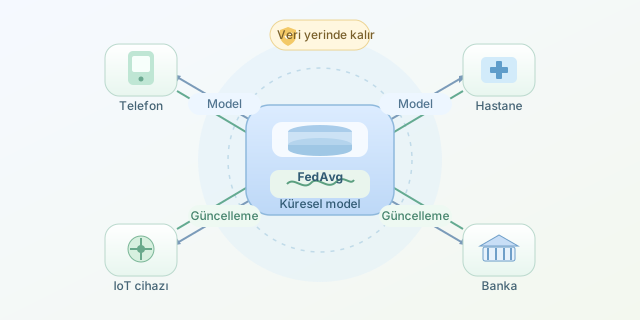
Telefonunuzun klavyesi bir sonraki kelimeyi tahmin ederken yazdığınız özel mesajların merkezi bir sunucuya gönderilmesi pek hoş olmazdı. Federatif öğrenme, diğer adıyla federal öğrenme, tam bu noktada devreye girer: Veriyi modele götürmek yerine modeli verinin bulunduğu cihazlara götürür. Kullanıcı cihazları modeli kendi verileriyle geliştirir ve sunucuya ham verileri değil, yalnızca hesaplanan ağırlık güncellemelerini yollar. ``
Federatif öğrenmenin temel fikri
Geleneksel makine öğrenmesinde eğitim verileri merkezi bir veri havuzunda toplanır. Federatif yaklaşımda ise telefonlar, hastaneler, bankalar veya IoT cihazları birer yerel eğitim düğümüne dönüşür. Süreç genellikle şu döngüyle ilerler:
- Merkezi sunucu, başlangıç modelini uygun istemcilere gönderir.
- Her istemci modeli kendi yerel verisi üzerinde birkaç tur eğitir.
- İstemciler yeni ağırlıkları veya ağırlık farklarını sunucuya yollar.
- Sunucu gelen güncellemeleri birleştirerek küresel modeli yeniler.
- İstenen başarıya ulaşılana kadar süreç tekrarlanır.
Bir istemcinin güncellemesi kabaca şu şekilde gösterilebilir:
\[w_k^{yeni} = w^{eski} - η ∇L_k(w)\]Burada $w$ model ağırlıklarını, $η$ öğrenme oranını, $L_k$ ise $k$ numaralı istemcinin yerel kayıp fonksiyonunu ifade eder. Başka bir deyişle her cihaz, modelin hangi yöne ilerlemesi gerektiğine dair matematiksel bir öneri üretir.
FedAvg: Güncellemeler nasıl birleşir?
En yaygın yöntemlerden biri Federated Averaging, yani FedAvg algoritmasıdır. Sunucu, istemcilerden gelen modelleri yerel veri miktarlarına göre ağırlıklı biçimde ortalar:
\[w = \sum_{k=1}^{K} (n_k / N) w_k\]Burada $n_k$, ilgili istemcideki örnek sayısı; $N$, tüm katılımcıların toplam örnek sayısıdır. Böylece yüz örnekle çalışan bir cihaz ile on bin örnekle çalışan bir cihazın katkısı aynı kabul edilmez.
| Özellik | Merkezi öğrenme | Federatif öğrenme |
|---|---|---|
| Ham verinin konumu | Merkezi sunucu | Kullanıcı cihazı |
| Ağ trafiği | Veri aktarımı ağırlıklı | Model güncellemesi ağırlıklı |
| Gizlilik riski | Veri sızıntısı daha kritik | Güncellemeler yine korunmalı |
| Donanım yapısı | Genellikle güçlü sunucular | Dağıtık ve farklı cihazlar |
| Veri dağılımı | Daha düzenli olabilir | Çoğunlukla dengesizdir |
Basitleştirilmiş bir sunucu örneği
Aşağıdaki Python kodu, istemcilerden gelen tek boyutlu ağırlıkları veri sayılarına göre birleştirir:
def federated_average(client_models):
    total_samples = sum(samples for _, samples in client_models)
    global_weight = 0.0

    for weight, samples in client_models:
        contribution = samples / total_samples
        global_weight += contribution * weight

    return global_weight

updates = [(0.8, 100), (1.2, 300), (0.9, 100)]
print(federated_average(updates))  # 1.06
Kodda her demet, istemcinin eğittiği ağırlığı ve kullandığı örnek sayısını temsil eder. Gerçek sinir ağlarında tek sayı yerine milyonlarca parametre içeren tensörler işlenir; ancak ağırlıklı ortalama mantığı aynıdır.
Gizlilik otomatik olarak garanti edilmez
Ham verinin paylaşılmaması büyük avantajdır, fakat model güncellemeleri bazen kullanıcı verileri hakkında ipuçları taşıyabilir. Bu nedenle güvenli toplama, diferansiyel gizlilik ve şifreleme gibi ek teknikler kullanılır. Diferansiyel gizlilikte güncellemelere kontrollü gürültü eklenebilir:
\[g' = g + N(0, σ^2)\]Bu işlem bireysel katkıların ayırt edilmesini zorlaştırırken model doğruluğunu bir miktar azaltabilir. Güvenli toplama ise sunucunun tek bir kullanıcının güncellemesini görmeden yalnızca toplam sonucu hesaplamasını sağlar.
Federatif öğrenmenin başka zorlukları da vardır: Cihazlar çevrimdışı olabilir, internet bağlantıları yavaşlayabilir ve kullanıcıların verileri birbirinden çok farklı dağılımlar gösterebilir. Örneğin herkes klavyede aynı kelimeleri kullanmaz. Bu durum non-IID veri problemi olarak bilinir.
Sonuç olarak federatif öğrenme, gizlilik ile ortak model geliştirme arasında güçlü bir köprü kurar. Veriler evinden çıkmaz; fakat onlardan öğrenilen matematiksel deneyim küresel modele katkı sağlar. Yine de başarılı bir sistem için algoritma kadar güvenlik, iletişim maliyeti, cihaz seçimi ve adalet konularının da dikkatle tasarlanması gerekir.
Yorumlar