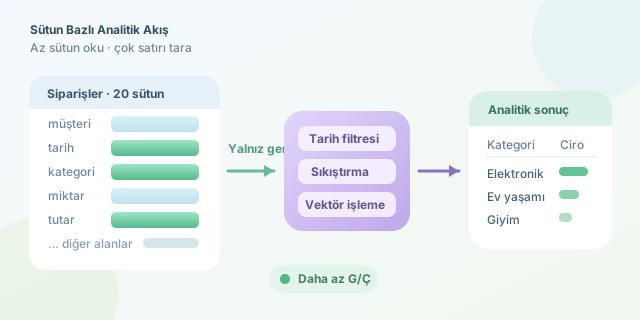
Analitik sistemlerde asıl soru genellikle “hangi müşteriler?” değil, “milyonlarca kayıttan hangi eğilim ortaya çıkıyor?” olur. İşte columnar database, yani sütun bazlı veritabanı mimarisi, bu soruya hızla yanıt vermek için tasarlanmıştır. Satır bazlı sistemlerin tüm kaydı birlikte taşıyan yaklaşımına karşılık, veriyi sütun sütun organize eder. ``
Geleneksel satır bazlı bir tabloda siparisler kaydının müşteri, tarih, ürün, miktar ve tutar alanları fiziksel olarak yan yana saklanır. Bir kullanıcının tek siparişini okumak veya güncellemek için idealdir. Ancak analitik bir sorgu yalnızca tutar sütununu kullanarak milyonlarca siparişin toplamını hesaplamak istiyorsa, satır bazlı yapı gereksiz alanları da diskten belleğe taşır.
Sütun bazlı mimaride ise tüm tutar değerleri birlikte, tüm tarih değerleri başka bir blokta tutulur. Böylece sorgu yalnızca ihtiyacı olan sütunları okur. Okunan veri miktarı kabaca şu şekilde düşünülebilir:
Örneğin 20 sütunlu bir tablodan sadece iki sütunla rapor üretiyorsanız, ideal koşullarda I/O maliyetinin önemli bölümünü atlamış olursunuz. Bu yalnızca disk erişimini değil, CPU önbelleği kullanımını ve ağ üzerinden taşınan veri miktarını da iyileştirir.
| Özellik | Satır Bazlı Depolama | Sütun Bazlı Depolama |
|---|---|---|
| En uygun iş yükü | OLTP, tekil kayıt işlemleri | OLAP, raporlama ve agregasyon |
| Kayıt ekleme/güncelleme | Genellikle daha hızlı | Küçük güncellemelerde daha maliyetli olabilir |
SUM, AVG, COUNT |
Çok veri okur | İlgili sütunu tarar |
| Sıkıştırma verimi | Orta | Genellikle yüksektir |
| Tipik örnekler | PostgreSQL, MySQL | ClickHouse, BigQuery, Redshift |
Sıkıştırma, columnar yaklaşımın gizli turbo düğmesidir. Aynı sütunda benzer türden değerler bulunduğundan, tekrar eden ülke kodları için sözlük kodlama, artan tarihler için delta encoding veya düşük kardinaliteli alanlar için run-length encoding etkili olur. Örneğin durum sütununda milyonlarca kez tamamlandi değeri geçiyorsa, her satırda metni yeniden saklamak yerine kısa bir sözlük kimliği kullanılabilir.
Bir analitik sorguyu ele alalım:
SELECT
  kategori,
  SUM(tutar) AS ciro,
  COUNT(*) AS siparis_sayisi
FROM siparisler
WHERE siparis_tarihi >= DATE '2026-01-01'
GROUP BY kategori
ORDER BY ciro DESC;
Bu sorgu yalnızca kategori, tutar ve siparis_tarihi sütunlarına ihtiyaç duyar. Columnar motor; diğer 17 sütunu okumadan, tarih bloklarını filtreleyip uygun segmentlerde toplama yapabilir. Modern motorlar bunu vektörize yürütme ile daha da hızlandırır: değerleri tek tek işlemek yerine CPU’nun SIMD yeteneklerinden yararlanarak bloklar hâlinde işler.
Elbette her problem çivi değildir; her veritabanı da çekiç olmamalı. Kullanıcı profilini sürekli güncelleyen bir ödeme uygulamasında satır bazlı model daha mantıklıdır. Çünkü tek bir kaydı değiştirmek, columnar yapılarda birden fazla sütun parçasını ve sıkıştırılmış bloğu etkileyebilir. Buna karşılık günlük satış raporları, olay kayıtları, telemetri ve log analizi columnar sistemlerin doğal oyun alanıdır.
| Senaryo | Tercih Edilen Yaklaşım | Neden |
|---|---|---|
| Sepete ürün ekleme | Satır bazlı | Tek kaydın hızlı yazılması |
| Aylık gelir raporu | Sütun bazlı | Az sütun, çok satır taraması |
| Uygulama log analizi | Sütun bazlı | Büyük hacim ve filtreleme |
| Hesap bakiyesi güncelleme | Satır bazlı | Tutarlı, küçük işlem ihtiyacı |
Özetle columnar database’ler veriyi farklı saklayarak sorgunun veriyle buluşma biçimini değiştirir. Analitik dünyada performansın büyük kısmı “ne kadar az veri okuduğunuzla” ilgilidir. Sütun bazlı depolama da tam olarak bu prensibi mimarinin merkezine koyar.
Yorumlar