İçindekiler
Makine öğrenmesi projelerinde herkes model seçimini konuşur: Sinir ağı mı kullanalım, karar ağacı mı, yoksa son moda bir dönüştürücü mü? Oysa gerçek hayatta zamanın büyük bölümü model eğitiminden önce harcanır. Eksik hücreler, yanlış tarihler, uçuk değerler ve birbirini tutmayan kategoriler düzeltilmeden dünyanın en gelişmiş algoritması bile pahalı bir tahmin makinesine dönüşebilir.
``
Veri temizliği neden bu kadar maliyetlidir?
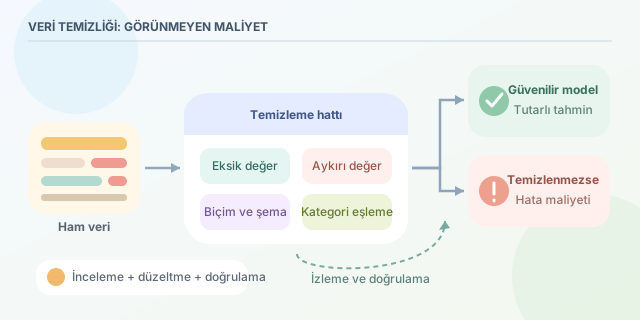
Veri temizliği yalnızca birkaç boş satırı silmek değildir. Sorunun kaynağını anlamayı, alan uzmanlarıyla görüşmeyi, düzeltme kuralları oluşturmayı ve bu kuralların sonuçlarını doğrulamayı kapsar. Maliyeti basitçe şöyle düşünebiliriz:
\[C_{toplam} = C_{inceleme} + C_{düzeltme} + C_{doğrulama} + C_{hata}\]Buradaki son terim özellikle önemlidir. Temizlenmeyen veya yanlış temizlenen verinin oluşturduğu iş kaybı, çoğu zaman temizlik için harcanacak emek maliyetinden daha büyüktür. Yanlış müşteri segmentleri, hatalı kredi kararları veya bozuk talep tahminleri bunun sonuçları olabilir.
| Sorun | Hızlı yaklaşım | Daha güvenilir yaklaşım | Olası risk |
|---|---|---|---|
| Eksik veri | Satırı silmek | Dağılıma uygun değer atamak | Örneklem yanlılığı |
| Aykırı değer | Eşik dışını silmek | Kaynağı ve bağlamı incelemek | Gerçek olayları kaybetmek |
| Format farkı | Metni doğrudan dönüştürmek | Şema ve yerel ayar kullanmak | Tarih veya sayı hatası |
| Tutarsız kategori | Elle değiştirmek | Eşleme sözlüğü oluşturmak | Tekrarlanamayan süreç |
Eksik veriler: Boşluk her zaman hiçlik değildir
Eksik bir değeri ortalamayla doldurmak kolaydır; fakat her boşluk aynı anlama gelmez. Bir müşterinin gelir bilgisini paylaşmaması rastgele olmayabilir. İstatistikte eksiklik mekanizmaları MCAR, MAR ve MNAR olarak sınıflandırılır. Özellikle MNAR durumunda eksiklik, gözlenmeyen değerin kendisiyle ilişkilidir.
Sayısal bir sütunda ortalama atama şu şekilde gösterilebilir:
\[x_i' = \begin{cases} x_i, & x_i\ \text{mevcutsa} \\ \bar{x}, & x_i\ \text{eksikse} \end{cases}\]Bu yöntem veri sayısını korur, ancak varyansı yapay olarak azaltabilir. Medyan, KNN tabanlı atama veya tahmin modeli kullanmak dağılıma göre daha iyi seçenekler olabilir.
Aykırı değer: Hata mı, değerli sinyal mi?
Aykırı değerleri hemen silmek, yangın alarmını fazla ses çıkarıyor diye sökmeye benzer. Bir işlem tutarının yüksek olması veri giriş hatası olabileceği gibi dolandırıcılık göstergesi de olabilir. Yaygın IQR yönteminde kabul aralığı şöyledir:
\[[Q_1 - 1.5\times IQR,\ Q_3 + 1.5\times IQR]\]Ancak bu sınır bir doğa kanunu değildir. Mevsimsellik, kullanıcı davranışı ve iş kuralları hesaba katılmalıdır. Silmek yerine kırpma, logaritmik dönüşüm veya aykırı değer etiketi ekleme seçenekleri de değerlendirilmelidir.
Format standardizasyonu
01/02/2026 tarihi 1 Şubat mı, 2 Ocak mı? İstanbul, istanbul ve ISTANBUL aynı kategori midir? İnsan için anlaşılır görünen bu değerler bilgisayar için farklı olabilir. Standart bir şema; veri tiplerini, tarih biçimlerini, ölçü birimlerini ve izin verilen kategorileri açıkça tanımlar.
Aşağıdaki Python örneği temel bir temizleme hattı kurar:
import pandas as pd

df = pd.read_csv("musteriler.csv")

# Metin kategorilerini ortak biçime getirir.
df["sehir"] = df["sehir"].str.strip().str.lower()

# Geçersiz tarihleri NaT yaparak görünür hâle getirir.
df["kayit_tarihi"] = pd.to_datetime(
    df["kayit_tarihi"], errors="coerce", dayfirst=True
)

# Eksik yaşları, uç değerlerden daha az etkilenen medyanla doldurur.
df["yas"] = df["yas"].fillna(df["yas"].median())

# Mantıksız yaşları otomatik silmek yerine inceleme için işaretler.
df["yas_supheli"] = ~df["yas"].between(0, 110)
Kodun önemli tarafı yalnızca veriyi değiştirmesi değil, şüpheli kayıtları görünür kılmasıdır. İyi bir temizleme hattı tekrar çalıştırılabilir, test edilebilir ve hangi kararın neden verildiğini kaydeder.
Temizlik bir defalık operasyon değildir
Veri kaynakları değiştikçe eski kurallar bozulabilir. Bu nedenle eksiklik oranı, kategori sayısı ve aykırı değer yüzdesi düzenli izlenmelidir. Veri temizliğine harcanan zaman model geliştirmeden çalınan süre değil, modelin güvenilirliğine yapılan yatırımdır. Kısacası kaliteli modelin gizli malzemesi daha karmaşık algoritmalar değil; ne anlama geldiği bilinen, izlenebilir ve tutarlı veridir.
Yorumlar