İçindekiler
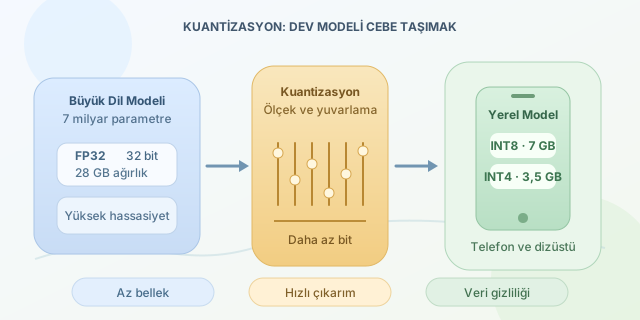
Milyarlarca parametreye sahip bir dil modelini cep telefonunda çalıştırmak, ilk bakışta buzdolabında veri merkezi barındırmaya benzer. Ancak kuantizasyon, modelin öğrendiği kayan noktalı ağırlıkları daha az bit kullanan sayılara dönüştürerek bu fikri uygulanabilir hâle getirir. Model biraz hassasiyet kaybedebilir; karşılığında daha az bellek tüketir, daha hızlı çalışır ve özel donanımlardan daha iyi yararlanır.
``
Kuantizasyon neden gerekli?
Sinir ağlarında öğrenilen ağırlıklar çoğunlukla FP32, yani 32 bit kayan noktalı sayılar olarak saklanır. Bir modelde 7 milyar parametre varsa yalnızca ağırlıkların yaklaşık bellek gereksinimi şöyledir:
\[7 \times 10^9 \times 4\ \text{bayt} \approx 28\ \text{GB}\]Aynı parametreler INT8 biçiminde saklanırsa her biri bir bayt kaplar ve teorik boyut yaklaşık 7 GB olur. INT4 kullanıldığında bu değer 3,5 GB seviyesine iner. Böylece model, güçlü bir ekran kartı yerine dizüstü bilgisayarda veya yeterli belleğe sahip telefonda çalıştırılabilir.
| Sayı biçimi | Parametre başına bit | 7B modelin yaklaşık ağırlık boyutu | Genel özellik |
|---|---|---|---|
| FP32 | 32 | 28 GB | Yüksek hassasiyet, yüksek maliyet |
| FP16 | 16 | 14 GB | Eğitim ve GPU çıkarımı için dengeli |
| INT8 | 8 | 7 GB | Düşük kayıpla hızlı çıkarım |
| INT4 | 4 | 3,5 GB | Mobil ve yerel kullanım için güçlü sıkıştırma |
Bu değerler yalnızca ağırlıkları temsil eder. Çalışma sırasında KV önbelleği, aktivasyonlar ve uygulama belleği de hesaba katılmalıdır.
Dönüşümün matematiksel mantığı
Temel amaç, gerçek sayı aralığını sınırlı sayıdaki tam sayı seviyesine eşlemektir. Yaygın doğrusal kuantizasyon formülü şöyledir:
\[q = \operatorname{round}\left(\frac{x}{s}\right) + z\]Burada $x$ gerçek ağırlık, $q$ kuantize edilmiş tam sayı, $s$ ölçek katsayısı ve $z$ sıfır noktasıdır. Yaklaşık gerçek değere geri dönmek için:
\[\hat{x} = s(q-z)\]kullanılır. Bu işlem kayıplıdır; çünkü farklı gerçek sayılar aynı tam sayı seviyesine yuvarlanabilir. Hassasiyet düştükçe model boyutu küçülürken kuantizasyon hatası büyür. İşin sanatı, bu iki uç arasında doğru dengeyi bulmaktır.
Örneğin küçük bir ağırlık dizisini INT8 benzeri bir aralığa dönüştürelim:
import numpy as np

weights = np.array([-1.2, -0.3, 0.2, 0.9], dtype=np.float32)
qmax = 127
scale = np.max(np.abs(weights)) / qmax

quantized = np.round(weights / scale).astype(np.int8)
restored = quantized.astype(np.float32) * scale

print("Kuantize:", quantized)
print("Yaklaşık geri dönüş:", restored)
Kod, en büyük mutlak ağırlığı INT8 sınırına eşleyerek bir ölçek üretir. restored değerleri orijinallerine yakındır fakat tamamen aynı değildir. Gerçek kütüphaneler işlemi tensör, kanal veya küçük ağırlık grupları düzeyinde uygulayarak hatayı azaltır.
Başlıca kuantizasyon yaklaşımları
| Yaklaşım | Ne zaman uygulanır? | Avantajı | Dezavantajı |
|---|---|---|---|
| PTQ | Eğitim tamamlandıktan sonra | Hızlı ve ekonomik | Hassasiyet kaybı artabilir |
| QAT | Eğitim sırasında | Daha iyi doğruluk | Ek eğitim maliyeti |
| Dinamik | Çalışma anında bazı değerlerde | Kolay dağıtım | Ek dönüşüm yükü |
| Grup bazlı | Küçük ağırlık gruplarında | INT4 için iyi denge | Biçim ve donanım bağımlılığı |
Post-Training Quantization (PTQ), hazır modeli yeniden eğitmeden sıkıştırdığı için LLM dünyasında oldukça popülerdir. GPTQ, AWQ ve GGUF tabanlı araçlar bu alanda sık görülür. Quantization-Aware Training (QAT) ise eğitim sırasında kuantizasyon hatasını taklit eder; model böylece düşük hassasiyete uyum sağlamayı öğrenir.
Her model gerçekten telefonda çalışır mı?
Kuantizasyon sihirli bir küçültme düğmesi değildir. İşlemci desteği, bellek bant genişliği, model mimarisi, bağlam uzunluğu ve kullanılan çalışma zamanı performansı doğrudan etkiler. Ayrıca INT4 modelin küçük olması, her cihazın INT4 hesaplamalarını doğal olarak hızlandıracağı anlamına gelmez. Bazen ağırlıklar hesaplama öncesinde daha yüksek hassasiyete açılır.
Yine de doğru model, uygun kuantizasyon ve mobil odaklı bir çalışma zamanı bir araya geldiğinde çevrimdışı sohbet, metin özetleme ve kişisel asistan gibi özellikler mümkün olur. Sonuç olarak kuantizasyon, yapay zekâyı yalnızca küçültmez; onu buluttan çıkarıp kullanıcının cebine taşıyarak daha düşük gecikme, maliyet ve daha güçlü veri gizliliği sağlar.
Yorumlar