İçindekiler
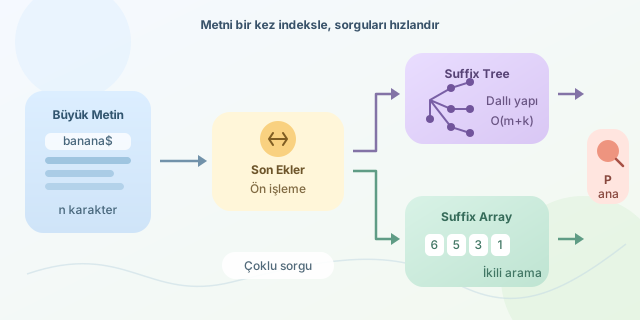
Bir kitap arşivinde, DNA dizisinde ya da milyonlarca log satırında belirli bir ifadeyi aradığınızı düşünün. Klasik yöntemle metni baştan sona taramak çoğu zaman yeterlidir; fakat aynı dev metinde binlerce farklı sorgu çalıştırılacaksa maliyet hızla büyür. Suffix Tree ve Suffix Array, metni bir kez ön işleyip sonraki örüntü aramalarını çok daha hızlı hale getiren iki güçlü veri yapısıdır. ``
Temel fikir, metnin her konumundan başlayan son ekleri (suffix) ele almaktır. Örneğin banana$ metninin son ekleri banana$, anana$, nana$, ana$, na$, a$ ve $ biçimindedir. Buradaki $, metnin bittiğini belirten ve başka karakterlerle çakışmayan özel bir işarettir. Uzunluğu $n$ olan bir metnin tam olarak $n$ adet son eki vardır. Bir örüntü $P$ metin içinde geçiyorsa, $P$ ile başlayan en az bir son ek de vardır. Bütün sihir bu gözlemden doğar.
Suffix Tree: Son Eklerin Dallanan Haritası
Suffix Tree, tüm son ekleri kökten başlayan yollar olarak saklayan sıkıştırılmış bir trie yapısıdır. Aynı başlangıca sahip karakter dizileri ortak dalları kullanır; yani tekrar eden parçalar gereksiz yere kopyalanmaz. Her kenar genellikle karakterleri tek tek tutmak yerine metindeki bir aralığı, örneğin [başlangıç, bitiş], temsil eder. Bu ayrıntı belleği korumak için kritiktir.
Bir örüntüyü ararken kökten başlayıp karakterleri kenarlar üzerinde takip ederiz. Yol tamamlanıyorsa örüntü vardır; ulaşılan düğümün altındaki yapraklar da tüm başlangıç konumlarını verir. Uygun algoritmalarla yapı $O(n)$ zamanda kurulabilir ve arama maliyeti yaklaşık $O(m)$ olur. Burada $m$, örüntünün uzunluğudur:
\[T_{search}=O(m+k)\]Buradaki $k$, raporlanan eşleşme sayısıdır. Ancak teorik güzelliğin bir bedeli vardır: düğümler, kenarlar ve işaretçiler nedeniyle gerçek dünyadaki bellek tüketimi yüksek olabilir.
Suffix Array: Daha Az Gösterişli, Daha Pratik
Suffix Array, tüm son eklerin kendisini değil, sıralanmış son eklerin başlangıç indekslerini tutan bir dizidir. banana$ için leksikografik sıralama sonrası indeksler kabaca [6, 5, 3, 1, 0, 4, 2] olur. Böylece a$, ana$, anana$ gibi birbirine yakın son ekler dizide yan yana yerleşir.
Arama, örüntüyü son eklerle karşılaştıran ikili arama ile yapılır. Örüntünün başlayabileceği ilk ve son aralığı bulduktan sonra ilgili indeksler eşleşme konumlarıdır. Basit modelde maliyet $O(m\log n)$ kabul edilir. LCP (Longest Common Prefix) dizisi ve gelişmiş arama teknikleriyle karakter karşılaştırmaları azaltılabilir.
\vert Özellik \vert Suffix Tree \vert Suffix Array \vert \vert —\vert —\vert —\vert \vert Arama süresi \vert $O(m+k)$ \vert Genellikle $O(m\log n+k)$ \vert \vert Bellek kullanımı \vert Yüksek \vert Daha düşük, dizi dostu \vert \vert Uygulama zorluğu \vert Daha karmaşık \vert Görece daha kolay \vert \vert Önbellek davranışı \vert İşaretçiler nedeniyle zayıf olabilir \vert Ardışık bellek sayesinde güçlü \vert
Aşağıdaki Python örneği, eğitim amaçlı basit bir Suffix Array üretir. Büyük veride daha gelişmiş $O(n\log n)$ veya $O(n)$ kurulum algoritmaları tercih edilmelidir.
def build_suffix_array(text):
    # Her başlangıç indeksini, ilgili son eke göre sıralar.
    return sorted(range(len(text)), key=lambda i: text[i:])

def find_matches(text, pattern):
    sa = build_suffix_array(text)
    # Anlaşılır olması için doğrusal filtre kullanılıyor.
    # Üretimde bu bölüm ikili arama olmalıdır.
    return [i for i in sa if text.startswith(pattern, i)]

text = "banana$"
print(build_suffix_array(text))
print(find_matches(text, "ana"))  # [3, 1] sıralı son ek düzeninde dönebilir
Bu kodun sorted çağrısı son ek kopyaları üretebildiği için dev metinlerde ideal değildir; yine de fikri görünür kılar. Üretim sistemlerinde indeks tabanlı karşılaştırma, radix sort, LCP dizisi ve ikili arama kullanmak daha doğrudur.
Özetle, çok sayıda sorgu ve en düşük arama gecikmesi hedefleniyorsa Suffix Tree etkileyici bir seçenektir. Bellek bütçesi, uygulama sadeliği ve pratik performans öndeyse Suffix Array çoğu zaman daha mantıklı tercihtir. İkisi de “metni tekrar tekrar tarama” alışkanlığını bırakıp, metni akıllı bir indekse dönüştürmenin zarif yollarıdır.
Yorumlar