İçindekiler
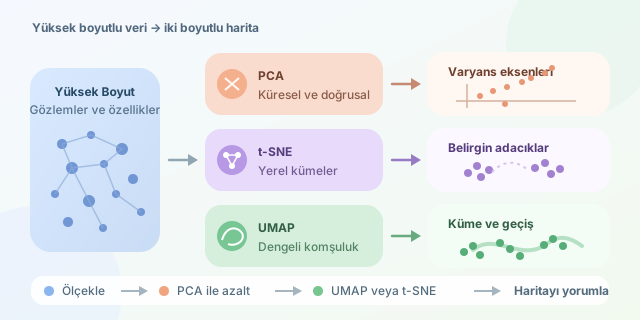
Yüksek boyutlu veriler, makine öğrenmesinin kalabalık şehirleri gibidir: Her gözlem onlarca, yüzlerce hatta binlerce özelliğe sahiptir; fakat insan gözü en rahat iki veya üç boyutta gezinebilir. PCA, t-SNE ve UMAP bu karmaşık uzayı görselleştirilebilir bir haritaya dönüştürür. Ancak aynı veriye bakıp farklı hikâyeler anlatabilirler. Bu yüzden amaç yalnızca güzel kümeler üretmek değil, hangi yöntemin hangi geometrik bilgiyi koruduğunu anlamaktır.
``
Temel fikir: Yakınlık mı, küresel yapı mı?
Boyut indirgeme, $X \in \mathbb{R}^{n \times d}$ biçimindeki yüksek boyutlu veriyi, genellikle $Y \in \mathbb{R}^{n \times 2}$ uzayına taşımayı hedefler. Kritik soru şudur: Dönüşüm sırasında neyi korumak istiyoruz? Uzak noktaların genel ilişkisini mi, yoksa birbirine yakın komşuların bağını mı?
| Yöntem | Ana hedef | En iyi koruduğu yapı | Tipik çıktı |
|---|---|---|---|
| PCA | Varyansı en fazla açıklamak | Küresel, doğrusal yapı | Eksenleri anlamlı saçılım grafiği |
| t-SNE | Yerel komşuluk olasılıkları | Yerel kümeler | Belirgin “adacıklar” |
| UMAP | Komşuluk grafiği ve manifold yapısı | Yerel yapı, kısmen küresel ilişki | Dengeli küme ve geçiş görünümü |
PCA: Hızlı, açıklanabilir, ama doğrusal
Principal Component Analysis (PCA), veriyi en fazla varyansın bulunduğu yönlere projekte eder. İlk ana bileşen şu optimizasyonla düşünülebilir:
\[\max_{\\vert w\\vert =1} \operatorname{Var}(Xw)\]Ardından ikinci bileşen, ilkine dik kalacak şekilde kalan varyansı yakalar. PCA’nın en önemli avantajı, sonuçlarının yorumlanabilir olmasıdır: Bileşen yükleri sayesinde hangi değişkenlerin ayrışmayı etkilediği görülebilir. Ayrıca hızlıdır; büyük veri setleri için çoğu zaman ilk keşif aracı olmalıdır.
Buna karşılık PCA, eğri veya kıvrımlı manifoldları düz bir düzleme açmakta zorlanır. Örneğin iç içe halkalar ya da Swiss roll verisi, PCA altında üst üste binebilir. Görselleştirmede görülen yakınlıkların doğrusal projeksiyondan kaynaklandığını unutmamak gerekir.
t-SNE: Kümeleri parlatan, mesafeleri tartıştıran araç
t-SNE, yüksek boyutta noktalar arasındaki komşulukları olasılıksal olarak tanımlar; düşük boyutta ise benzer komşuluk olasılıklarını korumaya çalışır. Amaç kabaca yüksek boyutlu $P$ ve düşük boyutlu $Q$ dağılımları arasındaki KL sapmasını azaltmaktır:
\[KL(P\\vert Q)=\sum_{i,j} p_{ij}\log\frac{p_{ij}}{q_{ij}}\]Bu yaklaşım, yerel kümeleri olağanüstü görünür kılar. Gen ifade verileri, görüntü gömlemeleri ve belge vektörleri için t-SNE grafikleri çoğu zaman etkileyicidir. Fakat bu görsel çekiciliğin bir bedeli vardır: İki küme arasındaki boşluğun büyüklüğü, kümelerin gerçek uzaklığını temsil etmek zorunda değildir. Küme boyutları ve yoğunlukları da yanıltıcı olabilir.
perplexity parametresi etkin komşu sayısını etkiler. Küçük değerler mikro-kümeleri, büyük değerler daha geniş komşulukları vurgular. Ayrıca farklı rastgele başlangıçlar farklı haritalar üretebilir; bu nedenle tek bir grafikten kesin bilimsel hüküm çıkarmak risklidir.
UMAP: Hız, ölçeklenebilirlik ve daha dengeli geometri
UMAP, veriyi bir komşuluk grafiği olarak ele alır ve bu grafiğin düşük boyuttaki bulanık topolojik benzerini kurmaya çalışır. t-SNE gibi yerel yapıya önem verir; ancak pratikte daha hızlıdır, büyük veri setlerine daha iyi ölçeklenir ve küresel ilişkilerin bir kısmını daha tutarlı gösterebilir.
| Kriter | PCA | t-SNE | UMAP |
|---|---|---|---|
| Hesaplama maliyeti | Düşük | Yüksek | Orta-düşük |
| Tekrarlanabilirlik | Yüksek | Parametre/tohuma duyarlı | Tohuma duyarlı |
| Küresel mesafeler | Görece iyi | Güvenilmez | Kısmen anlamlı |
| Yerel kümeler | Orta | Çok güçlü | Çok güçlü |
| Yeni veri dönüştürme | Kolay | Sınırlı | Desteklenir |
UMAP’te n_neighbors, yerel ve daha geniş yapı arasındaki dengeyi belirler; min_dist ise noktaların küme içinde ne kadar sıkışacağını kontrol eder. Küçük min_dist, yoğun ve estetik kümeler üretirken gerçek yoğunluk farklarını abartabilir.
Pratik bir başlangıç tarifi
Özellikleri önce ölçeklemek, ardından PCA ile gürültüyü azaltıp UMAP veya t-SNE uygulamak sık kullanılan sağlam bir akıştır:
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA
import umap

X_scaled = StandardScaler().fit_transform(X)
X_50 = PCA(n_components=50, random_state=42).fit_transform(X_scaled)
embedding = umap.UMAP(n_neighbors=20, min_dist=0.15,
                      random_state=42).fit_transform(X_50)
Bu kod, değişkenlerin ölçek farklarını giderir, PCA ile ilk 50 bileşene inerek gürültüyü ve maliyeti azaltır, sonra UMAP ile iki boyutlu gömleme üretir. En iyi yaklaşım tek bir yöntem seçmek değildir: PCA ile genel yönleri, t-SNE ile yerel kümeleri, UMAP ile ölçeklenebilir ve dengeli görünümü karşılaştırın. Harita, arazinin kendisi değil; dikkatle okunması gereken bir yorumdur.
Yorumlar