Büyük veri sistemlerinde dosya formatı seçimi, yalnızca depolama maliyetini değil; Spark, Hive, Trino veya Presto gibi araçlardaki sorgu süresini de doğrudan belirler. Parquet ve ORC, satır bazlı CSV ya da JSON yerine sütun bazlı veri saklayarak analitik iş yüklerini hızlandıran iki güçlü formattır. Ancak benzer hedeflere sahip olsalar da metadata organizasyonları, sıkıştırma stratejileri ve ekosistem uyumları farklıdır.
``
Sütun bazlı yaklaşımın temel fikri basittir: Analitik sorgular çoğunlukla tablodaki tüm alanları değil, birkaç sütunu okur. Örneğin milyonlarca sipariş kaydında yalnızca tarih, kategori ve tutar alanlarını topluyorsanız, müşteri adresi veya açıklama gibi sütunları diskte okumak gereksiz I/O üretir. Satır bazlı formatta her kaydın tamamı taranırken, Parquet ve ORC yalnızca gerekli sütun parçalarını getirir.
Teorik olarak okuma maliyetini şöyle düşünebiliriz:
\[T_{okuma} \approx T_{metadata} + \frac{B_{okunan}}{R_{disk}} + T_{decode}\]Burada $B_{okunan}$, gerçekten ihtiyaç duyulan bayt miktarıdır. Sütun seçimi arttıkça bu değer küçülür; dolayısıyla diskten okuma ve ağ üzerinden veri taşıma maliyeti azalır. Buna column pruning denir. Ayrıca her iki format da satır grupları için istatistik tutarak filtrelerin işe yaramayan blokları atlamasına izin verir. Bu mekanizma predicate pushdown olarak bilinir.
| Özellik | Parquet | ORC |
|---|---|---|
| Köken ekosistem | Hadoop, Spark, çoklu sorgu motorları | Hive odaklı Hadoop ekosistemi |
| Veri birimi | Row group ve page | Stripe ve stream |
| Filtre optimizasyonu | Column statistics, page index | Min/max istatistikleri, bloom filter |
| Yaygın kullanım | Data lake, lakehouse, Arrow tabanlı araçlar | Hive ağırlıklı ambarlar |
| Şema desteği | İç içe yapılar için güçlü | İç içe yapılar ve ACID/Hive senaryolarında güçlü |
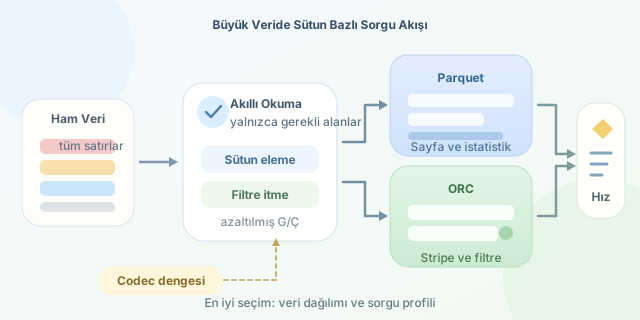
Parquet, sütun verisini sayfalara böler ve özellikle farklı motorlar arasında taşınabilirlik konusunda öne çıkar. Spark, DuckDB, Pandas, Polars ve bulut veri gölleriyle doğal bir ilişki kurar. ORC ise veriyi stripe adı verilen daha büyük bölümlerde düzenler. Stripe içindeki indeksler ve varsayılan bloom filter kullanımı, belirli değerleri arayan Hive sorgularında etkileyici sonuçlar verebilir.
Sıkıştırma tarafında kazanç, verinin tekrar eden yapısından gelir. Aynı sütundaki değerlerin türü ve dağılımı benzerdir: ülke sütununda sınırlı sayıda ülke kodu, durum sütununda birkaç sabit değer bulunabilir. Dictionary encoding, run-length encoding ve bit packing gibi teknikler bu düzenliliği değerlendirir. Sıkıştırma oranı kabaca şu şekilde ölçülür:
| Senaryo | Parquet davranışı | ORC davranışı |
|---|---|---|
| Az sayıda kategorik değer | Dictionary encoding ile çok verimli | Dictionary ve RLE ile çok verimli |
| Yüksek kardinaliteli metin | Sözlük maliyeti artabilir | Stream yapısı avantaj sağlayabilir |
| Sayısal zaman serisi | Delta/bit packing ile başarılı | RLE ve istatistiklerle başarılı |
| Seçici filtreli Hive sorgusu | İyi | Stripe indeksleriyle sıklıkla çok iyi |
Pratikte “ORC her zaman daha çok sıkıştırır” veya “Parquet her zaman daha hızlıdır” demek doğru değildir. Sıkıştırma codec’i belirleyicidir: Snappy hızlı sıkıştırıp açar; ZSTD daha iyi oran sunarken CPU tüketimini artırabilir; Gzip ise genellikle arşiv odaklıdır. Sorgu hızında yalnızca dosya boyutu değil, açma maliyeti de önemlidir. Çok agresif sıkıştırılmış küçük bir dosya, CPU darboğazı yaratabilir.
Aşağıdaki Spark örneği aynı veri kümesini iki biçimde yazmak için kullanılabilir:
from pyspark.sql import functions as F

source = spark.read.json("s3://veri-golu/events/")
clean = source.select("event_date", "country", "event_type", "amount")

clean.write.mode("overwrite") \
    .option("compression", "zstd") \
    .parquet("s3://veri-golu/output/events_parquet")

clean.write.mode("overwrite") \
    .option("compression", "zstd") \
    .orc("s3://veri-golu/output/events_orc")

clean.groupBy("country").agg(F.sum("amount")).explain(True)
Gerçek karar için aynı şema, partition düzeni ve codec ile benchmark yapın. Spark merkezli, çok araçlı bir lakehouse dünyasında Parquet genellikle güvenli varsayılandır. Hive tabanlı yoğun sorgularda, özellikle filtreleme ve sıkıştırma kritikse ORC güçlü bir adaydır. En iyi format, teorik kazanan değil; kendi veri dağılımınız ve sorgu profilinizde en az kaynak tüketen formattır.
Yorumlar