İçindekiler
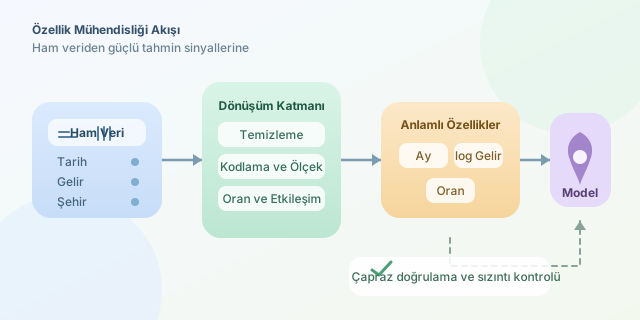
Makine öğrenmesinde model seçmek çoğu zaman sahnenin en parlak yıldızıdır; ancak performansı belirleyen görünmez kahraman genellikle özellik mühendisliğidir. Feature engineering, ham verideki bilgiyi modelin daha kolay anlayacağı sayısal, anlamlı ve tahmin gücü yüksek değişkenlere dönüştürme sanatıdır. İyi hazırlanmış özellikler, basit bir modeli bile güçlü hale getirebilir; kötü özellikler ise en iddialı algoritmayı bile şaşırtabilir.
``
Neden özellik mühendisliği gerekir?
Bir model, insanın doğal olarak kurduğu bağlantıları kendiliğinden her zaman keşfedemez. Örneğin bir e-ticaret veri setindeki siparis_tarihi alanı tek başına tarih gibi görünür. Fakat bu alandan hafta sonu olup olmadığı, ay, mevsim, kampanya dönemi veya teslimata kalan gün gibi davranışsal sinyaller üretilebilir. Böylece model sadece bir tarihi değil, müşterinin satın alma bağlamını görür.
Temel amaç, hedef değişken $y$ ile özellikler $X$ arasındaki ilişkiyi daha görünür hale getirmektir. Doğrusal bir model için basit yaklaşım şöyle yazılabilir:
\[y = \beta_0 + \beta_1x_1 + \beta_2x_2 + \epsilon\]Ancak gerçek hayatta ilişki çoğu zaman doğrusal değildir. Örneğin ev fiyatında metrekare etkisi semte göre değişebilir. Bu etkileşimi yakalamak için $x_{metrekare} \times x_{semt}$ gibi yeni bir özellik oluşturmak gerekir.
| Ham veri durumu | Dönüştürülmüş özellik | Sağladığı fayda |
|---|---|---|
2026-08-11 tarihi |
gün, ay, hafta sonu | Zaman davranışını yakalar |
| Gelir: 125.000 | log(gelir) |
Aşırı büyük değerlerin etkisini azaltır |
| Şehir adı | one-hot veya hedef kodlama | Kategorik veriyi sayısallaştırır |
| Boy ve kilo | Vücut kitle indeksi | Daha anlamlı bir ilişki sunar |
Eksik, sayısal ve kategorik veriler
İlk durak veri kalitesidir. Eksik değerleri silmek bazen hızlıdır ama değerli gözlemleri kaybettirebilir. Sayısal alanlarda medyanla doldurma, aykırı değerlere karşı ortalamadan daha dayanıklıdır. Kategorik alanlarda ise Bilinmiyor adlı ayrı bir sınıf, eksikliğin kendisinin bilgi taşıdığı durumlarda etkili olabilir.
Ölçekleme de modele göre kritik bir tercihtir. K-en yakın komşu, SVM ve lojistik regresyon gibi mesafe veya katsayı temelli yöntemler değişken ölçeklerinden etkilenir. Karar ağaçları ise çoğunlukla ölçekleme olmadan da rahat çalışır.
| Teknik | En uygun olduğu modeller | Dikkat edilmesi gereken |
|---|---|---|
| Standardizasyon | SVM, KNN, lojistik regresyon | Eğitim verisinin istatistikleri kullanılmalı |
| Min-max ölçekleme | Sinir ağları, KNN | Aykırı değerlerden etkilenir |
| One-hot encoding | Düşük kategorili alanlar | Çok fazla sütun üretebilir |
| Target encoding | Yüksek kardinaliteli alanlar | Veri sızıntısı riski vardır |
Aşağıdaki Python örneği, tarih alanından yararlı özellikler üretir ve sayısal bir kolonu logaritmik olarak dönüştürür:
import numpy as np
import pandas as pd

veri = pd.DataFrame({
    "siparis_tarihi": ["2026-01-03", "2026-01-05"],
    "ciro": [1500, 25000]
})

veri["siparis_tarihi"] = pd.to_datetime(veri["siparis_tarihi"])
veri["ay"] = veri["siparis_tarihi"].dt.month
veri["hafta_sonu"] = (veri["siparis_tarihi"].dt.dayofweek >= 5).astype(int)
veri["log_ciro"] = np.log1p(veri["ciro"])

print(veri)
Buradaki log1p, $\log(1+x)$ hesaplayarak sıfır değerlerinde hata oluşmasını önler. Özellikle ciro, takipçi sayısı veya işlem hacmi gibi sağa çarpık dağılımlarda modelin daha dengeli öğrenmesine yardım eder.
Etkileşimler, oranlar ve veri sızıntısı
En değerli özellikler çoğu zaman alan bilgisinden doğar. Finans verisinde borç / gelir, pazarlamada tıklama / gösterim oranı veya üretimde çalışma_saati / üretilen_adet gibi türetilmiş alanlar güçlü sinyaller taşır. Buna karşılık hedefe doğrudan veya dolaylı biçimde gelecektan bilgi taşıyan özellikler veri sızıntısı yaratır. Örneğin kredi onayını tahmin ederken onay sonrası oluşan bir alanı kullanmak, test başarısını yapay biçimde uçurur.
Son olarak her yeni özelliği körü körüne eklemeyin. Çapraz doğrulama ile katkısını ölçün, eğitim ve test dönüşümlerini aynı pipeline içinde uygulayın. İyi feature engineering; daha çok sütun üretmek değil, problemi daha doğru temsil eden sütunları üretmektir.
Yorumlar