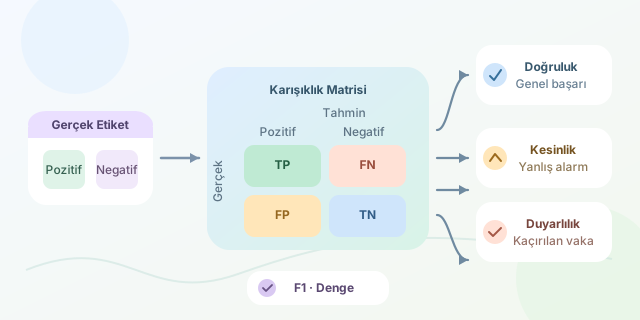
Bir sınıflandırma modelinin “%95 başarılı” olduğunu duymak etkileyicidir; fakat bu cümle tek başına çoğu zaman eksiktir. Örneğin kredi kartı sahtekârlığını yakalayan bir model, işlemlerin %99’u normal olduğu için her şeye “normal” diyerek de yüksek doğruluğa ulaşabilir. Bu nedenle doğruluk, kesinlik, duyarlılık ve F1 skoru; modelin farklı davranışlarını ayrı ayrı görünür kılan temel metriklerdir.
``
Bu metriklerin çıkış noktası karışıklık matrisidir (confusion matrix). İkili sınıflandırmada “pozitif” sınıf, ilgilendiğimiz olayı temsil eder: hastalık, spam, dolandırıcılık veya hata gibi. Modelin tahmini ile gerçek etiketin birleşimi dört olasılık üretir.
| Gerçek durum / Tahmin | Pozitif tahmin | Negatif tahmin |
|---|---|---|
| Gerçek pozitif | Doğru Pozitif (TP) | Yanlış Negatif (FN) |
| Gerçek negatif | Yanlış Pozitif (FP) | Doğru Negatif (TN) |
Doğruluk (accuracy), tüm tahminlerin ne kadarının doğru olduğunu ölçer:
\[Accuracy = \frac{TP + TN}{TP + TN + FP + FN}\]Genel başarının hızlı bir özetidir. Ancak sınıflar dengesizse yanıltıcı olabilir. Bin işlemden yalnızca 10’u dolandırıcılıksa, tüm işlemlere “normal” diyen modelin doğruluğu $990/1000 = 0.99$ olur; buna rağmen tek bir dolandırıcılığı bile yakalayamaz.
Kesinlik (precision), modelin pozitif dediği örneklerin ne kadarında haklı olduğunu sorar:
\[Precision = \frac{TP}{TP + FP}\]Yanlış alarmın maliyetli olduğu durumlarda kesinlik öne çıkar. Bir e-posta sisteminin önemli mesajları spam diye işaretlemesini istemeyiz. Buna karşılık duyarlılık (recall), gerçek pozitiflerin ne kadarını bulduğumuzu ölçer:
\[Recall = \frac{TP}{TP + FN}\]Kanser taraması gibi bir vakayı kaçırmanın ağır sonuçları olan alanlarda duyarlılık kritik olabilir. Yüksek duyarlılık için eşik düşürüldüğünde model daha fazla pozitif bulur, fakat yanlış pozitifler de artabilir.
| Metrik | Temel soru | Öncelikli maliyet | Uygun örnek |
|---|---|---|---|
| Doğruluk | Toplamda ne kadar doğru? | Genel hata | Dengeli sınıflar |
| Kesinlik | Pozitif dediklerim doğru mu? | Yanlış pozitif | Spam filtresi |
| Duyarlılık | Gerçek pozitifleri buldum mu? | Yanlış negatif | Hastalık taraması |
| F1 | Kesinlik ve duyarlılık dengeli mi? | Her iki hata türü | Dengesiz veri |
F1 skoru, kesinlik ile duyarlılığın harmonik ortalamasıdır:
\[F1 = 2 \cdot \frac{Precision \cdot Recall}{Precision + Recall}\]Harmonik ortalama seçilmesi tesadüf değildir: Değerlerden biri çok düşükse F1 de belirgin biçimde düşer. Örneğin kesinliği yüksek, duyarlılığı zayıf bir model; seçici davranıyor ama birçok gerçek vakayı kaçırıyor olabilir. F1, bu dengesiz başarıyı “ortalama iyi” diye saklamaz.
Python ve scikit-learn ile metrikleri hesaplamak oldukça pratiktir. Aşağıdaki örnek, gerçek etiketleri ve model tahminlerini karşılaştırarak temel raporu üretir:
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score, confusion_matrix

y_true = [1, 0, 1, 1, 0, 0, 1, 0]
y_pred = [1, 0, 0, 1, 0, 1, 1, 0]

print("Karışıklık matrisi:\n", confusion_matrix(y_true, y_pred))
print("Doğruluk:", round(accuracy_score(y_true, y_pred), 3))
print("Kesinlik:", round(precision_score(y_true, y_pred), 3))
print("Duyarlılık:", round(recall_score(y_true, y_pred), 3))
print("F1:", round(f1_score(y_true, y_pred), 3))
Bu kodda 1 pozitif sınıftır. Gerçek projelerde yalnızca tek bir skora bakmak yerine karışıklık matrisini, sınıf dağılımını ve hata maliyetlerini birlikte değerlendirin. Model seçimi matematiksel bir yarıştan çok, problemin risklerini doğru anlamlandırma işidir.
Yorumlar