İçindekiler
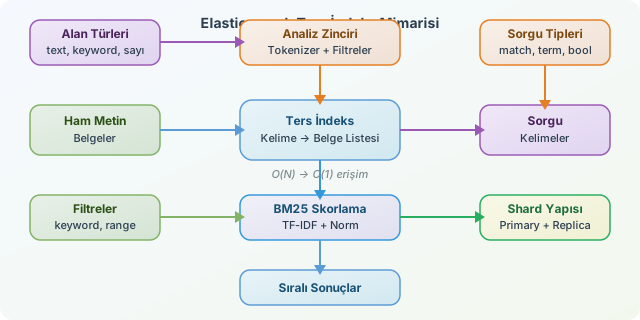
Milyonlarca ürün, makale ya da log kaydı arasında kullanıcıların yazdığı birkaç kelimeyi milisaniyeler içinde bulmak, ilk bakışta samanlıkta iğne aramaya benzer. Elasticsearch bu işi belgeleri tek tek okumak yerine ters indeks (inverted index) kurarak çözer. Bu yapı, klasik veritabanı sorgularındaki satır taramasını arama motoruna uygun, hızlı bir erişim modeline dönüştürür. ``
Neden normal tarama yavaşlar?
Geleneksel yaklaşımda title alanında “kablosuz kulaklık” arandığını düşünelim. Sistem, her belgenin başlığını okuyup iki kelimenin varlığını kontrol ederse yaklaşık $O(N)$ maliyetle çalışır. Belge sayısı $N$ büyüdükçe sorgu süresi de büyür. Özellikle metin uzunsa, yalnızca belge sayısı değil; her belgedeki kelime sayısı da maliyeti artırır.
Ters indeks bu ilişkiyi tersine çevirir: belgeden kelimeye gitmek yerine kelimeden belgelere gider. Örneğin indeks aşağıdaki gibi düşünülebilir:
| Terim | Belge kimlikleri | Ek bilgi |
|---|---|---|
| kablosuz | 7, 18, 42 | Terim konumları ve frekansları |
| kulaklık | 18, 42, 91 | Terim konumları ve frekansları |
| bluetooth | 7, 42 | Filtreleme ve skorlamada kullanılabilir |
“kablosuz kulaklık” sorgusunda Elasticsearch yalnızca ilgili terim listelerini bulur, sonra bunların kesişimini hesaplar. Sıralı posting list’ler sayesinde bu işlem tüm koleksiyonu dolaşmaktan çok daha ucuzdur. Arama motorunun küçük numarası şudur: Aramadan önce çok çalışır, arama anında ise az çalışır.
Analiz zinciri: Metni indekslenebilir hale getirmek
Ters indeks ham metni doğrudan saklamaz. Önce bir analyzer devreye girer: karakter filtresi, tokenizer ve token filtreleri metni aranabilir terimlere dönüştürür. Örneğin “İstanbul’daki Kitaplar!” ifadesi küçük harfe indirgenebilir, noktalama işaretlerinden ayrıştırılabilir ve uygun dil kurallarıyla köklerine yaklaştırılabilir.
| Alan türü | Davranış | İdeal kullanım |
|---|---|---|
text |
Analiz edilir, tam metin sorgularına uygundur | Başlık, açıklama, içerik |
keyword |
Tek parça değer olarak tutulur | Marka, durum, etiket, filtre |
integer / date |
Sayısal veya zamansal indeksleme yapar | Fiyat, stok, yayın tarihi |
Türkçe içeriklerde analyzer seçimi özellikle önemlidir. lowercase tek başına çoğu senaryoda yeterli olmayabilir; ekler, karakter dönüşümleri ve eş anlamlılar arama kalitesini doğrudan etkiler. İndeks tasarımı aslında “kullanıcı bu metni hangi kelimelerle arar?” sorusuna verilen teknik cevaptır.
PUT urunler
{
  "settings": {
    "analysis": {
      "analyzer": {
        "arama_analyzer": {
          "type": "custom",
          "tokenizer": "standard",
          "filter": ["lowercase", "asciifolding"]
        }
      }
    }
  },
  "mappings": {
    "properties": {
      "ad": { "type": "text", "analyzer": "arama_analyzer" },
      "marka": { "type": "keyword" },
      "fiyat": { "type": "float" }
    }
  }
}
Bu mapping, ürün adını tam metin araması için analiz ederken marka bilgisini kesin eşleşme ve aggregation işlemleri için korur. Yani “Sony” ile filtrelemek ve “kablosuz kulaklık” ile aramak aynı indeks içinde farklı ihtiyaçlara göre optimize edilir.
Skorlama: Bulmak yetmez, doğru sıraya koymak gerekir
Elasticsearch sonuçları çoğunlukla BM25 algoritmasıyla puanlar. Basitleştirilmiş sezgiyle skor; terimin belgede ne kadar anlamlı sıklıkta geçtiğine, terimin koleksiyondaki nadirliğine ve belge uzunluğuna bağlıdır:
\[score(q,d) \approx \sum_{t \in q} IDF(t) \cdot TF(t,d) \cdot norm(d)\]Nadir bir kelime, yaygın bir kelimeden daha ayırt edicidir. Ancak aynı kelimeyi yüz kez yazmak belgeyi otomatik şampiyon yapmaz; BM25 frekans katkısını dengeler. match sorgusu bu analizi ve skoru kullanırken, term sorgusu analiz edilmemiş kesin değeri hedefler.
GET urunler/_search
{
  "query": {
    "bool": {
      "must": [
        { "match": { "ad": "kablosuz kulaklık" } }
      ],
      "filter": [
        { "term": { "marka": "Sony" } },
        { "range": { "fiyat": { "lte": 5000 } } }
      ]
    }
  }
}
Burada must bölümü sonuçları skorlar; filter ise skora katkı vermeden aday kümesini daraltır ve önbellekleme açısından avantaj sağlar.
Ölçeklenebilirlik: Tek indeks, çok shard
Veri büyüdüğünde Elasticsearch indeksi primary shard adı verilen parçalara böler. Her shard bağımsız bir Lucene indeksi gibi çalışır; sorgular ilgili shard’lara dağıtılır, sonuçlar koordinatör düğümde birleştirilir. Replica shard’lar hem yüksek erişilebilirlik hem de daha fazla arama kapasitesi sunar.
Yine de shard sayısını gereksiz artırmak sihirli hız düğmesi değildir: Her shard ek bellek, dosya tanıtıcısı ve sorgu koordinasyonu demektir. Sağlıklı yaklaşım; gerçek veri hacmi, günlük sorgu yükü ve büyüme tahminine göre benchmark yapmaktır. Doğru analyzer, dengeli mapping, ölçülü shard tasarımı ve filter kullanımı bir araya geldiğinde Elasticsearch, devasa metin koleksiyonlarını gerçekten aranabilir hale getirir.
Yorumlar