İçindekiler
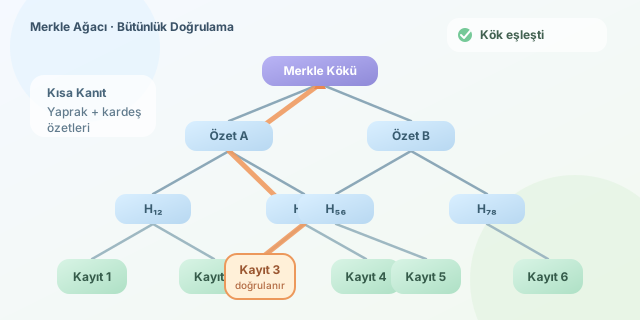
Bir dosyanın, veritabanı yedeğinin ya da milyonlarca işlemden oluşan bir blok zinciri bloğunun değiştirilmediğini nasıl kanıtlarsınız? Tüm veriyi her seferinde baştan sona karşılaştırmak güvenlidir, fakat pahalıdır. Merkle ağacı, kriptografik özetleri hiyerarşik biçimde birleştirerek bu sorunu çözer: Küçük bir kanıt paketiyle devasa bir veri kümesindeki belirli bir kaydın bütünlüğü doğrulanabilir.
``
Temel fikir: Özetlerden oluşan bir soy ağacı
Merkle ağacının yaprakları, veri parçalarının hash değerleridir. Her iç düğüm ise iki çocuk düğümün hash’inin birleştirilip tekrar hash’lenmesiyle elde edilir. En üstteki tek değere Merkle kökü denir. Kök hash güvenilir bir kanaldan biliniyorsa, ağacın tamamı için kısa bir bütünlük taahhüdü sağlar.
Bir yaprak için $h_i = H(d_i)$ tanımını kullanalım. İki komşu yaprağın ebeveyni şu şekilde hesaplanır:
\[h_{i,j} = H(h_i \Vert h_j)\]Buradaki $H$, SHA-256 gibi çarpışmaya dayanıklı bir hash fonksiyonu; $\Vert$ ise bayt dizilerini yan yana ekleme işlemidir. Verideki tek bitlik değişim bile, çığ etkisi nedeniyle yaprak hash’ini ve sonuç olarak Merkle kökünü tamamen değiştirir.
| Yaklaşım | Bir kaydı doğrulama maliyeti | Aktarılan kanıt | Kullanım alanı |
|---|---|---|---|
| Tüm veriyi karşılaştırma | $O(n)$ | $O(n)$ | Küçük dosyalar |
| Tekil hash listesi | $O(n)$ | $O(n)$ | Basit denetimler |
| Merkle ağacı | $O(\log n)$ | $O(\log n)$ | Blok zinciri, dağıtık depolama |
Merkle kanıtı neden küçüktür?
Diyelim ki 1.024 yapraklı bir ağaçta siparis-42 kaydını doğrulamak istiyoruz. Kaydın kendisini, yaprak hash’ini ve köke giden yoldaki yalnızca kardeş düğüm hash’lerini alırız. Ağacın yüksekliği $\log_2(1024)=10$ olduğundan, 1.024 kaydın tamamı yerine yaklaşık 10 hash yeterlidir. Doğrulayıcı, her seviyede hash’lerin sağda mı solda mı olduğunu da bilerek kökü yeniden üretir ve beklenen kökle karşılaştırır.
Aşağıdaki Python örneği, çift sayıda yapraktan basit bir Merkle kökü üretir. Gerçek sistemlerde veri serileştirme biçimi, alan ayırıcılar ve hash algoritması kesin olarak tanımlanmalıdır; aksi halde aynı mantıksal veri farklı hash’ler doğurabilir.
import hashlib

def sha256(veri: bytes) -> bytes:
    return hashlib.sha256(veri).digest()

def merkle_root(kayitlar: list[str]) -> str:
    # Önce her kaydı yaprak hash'ine dönüştürüyoruz.
    seviye = [sha256(k.encode("utf-8")) for k in kayitlar]

    # Tek yaprak kalana dek ebeveyn düğümleri üretiyoruz.
    while len(seviye) > 1:
        if len(seviye) % 2 == 1:
            seviye.append(seviye[-1])  # Tek yaprağı kopyalama politikası
        seviye = [sha256(seviye[i] + seviye[i + 1])
                   for i in range(0, len(seviye), 2)]
    return seviye[0].hex()

print(merkle_root(["Ali:100", "Ayşe:250", "Deniz:75", "Ece:90"]))
Tasarım kararları ve sınırlar
Tek sayıda yaprak olduğunda son hash’i kopyalamak yaygın bir tercihtir; ancak boş düğüm eklemek veya ağacı dengesiz bırakmak da mümkündür. Kritik nokta, üretici ve doğrulayıcının aynı kuralı kullanmasıdır. Ayrıca Merkle ağacı gizlilik sağlamaz: Kanıt içeriği veya yaprak verisi hassassa hash’ler sözlük saldırılarına açık olabilir. Bu durumda tuzlama, erişim kontrolü ya da taahhüt şemaları değerlendirilmelidir.
Merkle ağacı verinin doğru olduğunu değil, belirli bir köke bağlı verinin sonradan değişmediğini kanıtlar. Kökün güvenilir biçimde imzalanması, bir blok başlığında saklanması veya güvenilir bir kaynaktan alınması gerekir. Bu ayrımı kavradığınızda, Git’in nesne depolamasından blok zinciri hafif istemcilerine kadar pek çok sistemde aynı zarif fikri fark etmeye başlarsınız.
Yorumlar