Büyük dil modellerini her yeni görev için baştan ince ayar yapmak, devasa bir gemiyi limanda döndürmeye benzer: mümkündür ama yakıtı, zamanı ve donanımı bolca tüketir. Parametre-verimli ince ayar (PEFT) yöntemleri ise modelin ana gövdesini büyük ölçüde dondurur; yalnızca küçük, öğrenilebilir bileşenleri eğitir. LoRA ve adaptörler bu yaklaşımın en popüler iki temsilcisidir. İkisi de depolama maliyetini düşürür, görev başına ayrı model saklama sorununu hafifletir ve sınırlı GPU belleğiyle özelleştirme yapmayı mümkün kılar. ``
Klasik tam ince ayarda, önceden eğitilmiş ağırlık matrisi $W_0 \in \mathbb{R}^{d \times k}$ doğrudan güncellenir. Her katmandaki milyonlarca parametrenin gradyanı hesaplandığı için yalnızca ağırlıklar değil, optimizer durumları ve aktivasyonlar da belleği zorlar. Örneğin Adam optimizer, pratikte her eğitilebilir parametre için ek moment değerleri tuttuğundan maliyet hızla katlanır. PEFT’in temel fikri şudur: genel dil bilgisini taşıyan $W_0$ korunur, yeni görev için gereken küçük davranış değişikliği ayrı parametrelerde yakalanır.
LoRA’nın düşük rütbeli numarası
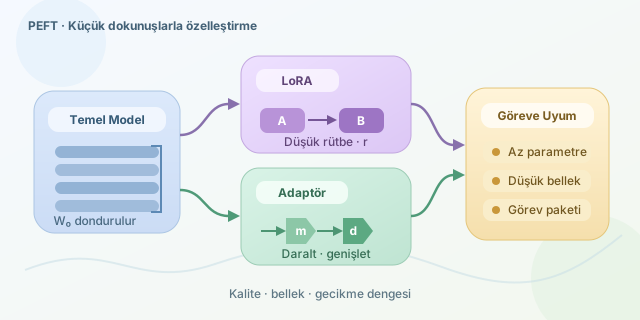
LoRA (Low-Rank Adaptation), ağırlığı doğrudan değiştirmek yerine güncellemeyi düşük rütbeli iki matrisle ifade eder:
\[W = W_0 + \Delta W = W_0 + BA\]Burada $A \in \mathbb{R}^{r \times k}$, $B \in \mathbb{R}^{d \times r}$ ve genellikle $r \ll \min(d,k)$ seçilir. Eğitilen parametre sayısı $d \times k$ yerine yaklaşık $r(d+k)$ olur. Ayrıca güncelleme çoğu uygulamada $\frac{\alpha}{r}BA$ ile ölçeklenir; $\alpha$, LoRA katkısının başlangıçtaki etkisini kontrol eder. Eğitimde temel ağırlıklar dondurulur, yalnızca $A$ ve $B$ öğrenir. Çıkarım aşamasında bu güncelleme ana ağırlığa birleştirilebildiği için ek gecikme oluşmadan kullanılabilir.
Adaptörler nerede farklılaşır?
Adaptör yöntemi, Transformer katmanlarının arasına küçük bir sinir ağı modülü ekler. Tipik bir adaptör önce boyutu daraltır, doğrusal olmayan bir dönüşüm uygular, sonra yeniden genişletir ve artık bağlantı üzerinden çıktıya eklenir:
\[h' = h + W_{up}\,\sigma(W_{down}h)\]Dar boğaz boyutu $m$, gizli boyuttan $d$ çok küçükse parametre maliyeti yaklaşık katman başına $2dm$ olur. LoRA mevcut doğrusal katmanların ağırlık güncellemesini temsil ederken, adaptör modele fiziksel olarak yeni işlem adımları ekler. Bu ayrım, iki yöntemin gecikme ve mimari esneklik davranışını belirler.
| Ölçüt | LoRA | Adaptör |
|---|---|---|
| Öğrenilen yapı | Düşük rütbeli ağırlık güncellemesi | Katman içine ek küçük ağ |
| Çıkarım gecikmesi | Ağırlıklar birleştirilirse çok düşük | Ek modüller nedeniyle artabilir |
| Görev değiştirme | Farklı LoRA ağırlıklarını yüklemek kolay | Adaptör paketlerini takıp çıkarmak kolay |
| Mimari etkisi | Genellikle attention/MLP doğrusal katmanları | Transformer blok akışına yeni modül ekler |
| Başarı eğilimi | Yeterli rank ile tam ince ayara yaklaşabilir | Küçük veri ve çoklu görev senaryolarında güçlüdür |
Başarıyı sadece doğrulukla değerlendirmek yanıltıcıdır. Aynı veri bölümü üzerinde F1, exact match veya perplexity gibi görev metrikleri; eğitilebilir parametre oranı, GPU belleği, eğitim süresi ve istek başına gecikmeyle birlikte raporlanmalıdır. Örneğin $r=8,16,32$ LoRA rank değerlerini ve adaptör dar boğazı için $m=16,64,128$ seçeneklerini taramak, kalite-maliyet eğrisini görünür kılar. Küçük rank aşırı kısıtlayıcı olabilir; gereğinden büyük rank ise PEFT tasarrufunu azaltır.
Aşağıdaki Hugging Face PEFT örneği, bir nedensel dil modelinin attention projeksiyonlarına LoRA ekler:
from peft import LoraConfig, TaskType, get_peft_model

config = LoraConfig(
    task_type=TaskType.CAUSAL_LM,
    r=16,
    lora_alpha=32,
    lora_dropout=0.05,
    target_modules=["q_proj", "v_proj"]
)

lora_model = get_peft_model(base_model, config)
lora_model.print_trainable_parameters()
Bu yapı, özellikle sorgu ve değer projeksiyonlarını hedefleyerek modelin dikkat davranışını göreve uyarlar. Adil bir deney için aynı öğrenme oranı aralığı, token bütçesi, veri temizleme süreci ve erken durdurma kuralı kullanılmalıdır. Sonuçta LoRA, gecikme ve depolama kritik olduğunda güçlü bir varsayılan seçimdir; adaptörler ise modüler deneyler, görev paketleme ve mimari düzeyde açık müdahale gerektiğinde öne çıkar. En iyi yöntem teorik olarak değil, hedef metriklerinizin oluşturduğu kalite-maliyet tablosunda kazanandır.
Yorumlar