Bir yapay zeka modelini eğitmek, maratonu bitirmek gibidir; inference ise her kullanıcı isteğinde yeniden başlayan sprinttir. Üretimde kullanıcılar modelinizin kaç gün eğitildiğiyle değil, yanıtın ne kadar hızlı geldiği, ne kadar maliyet oluşturduğu ve yoğun trafikte ne kadar kararlı kaldığıyla ilgilenir. Inference optimizasyonu; gecikmeyi düşürmek, saniyedeki istek sayısını artırmak ve donanım kaynaklarını daha verimli kullanmak için model, çalışma zamanı ve altyapı katmanlarını birlikte iyileştirme disiplinidir. ``
Temel metrikleri ayırmak kritik önemdedir. Gecikme (latency), tek isteğin tamamlanma süresidir; throughput ise birim zamanda işlenen istek miktarıdır. Büyük dil modellerinde ayrıca ilk tokenın gelme süresi olan TTFT ve token üretim hızı olan tokens/s takip edilir. Kabaca toplam gecikme şöyle modellenebilir:
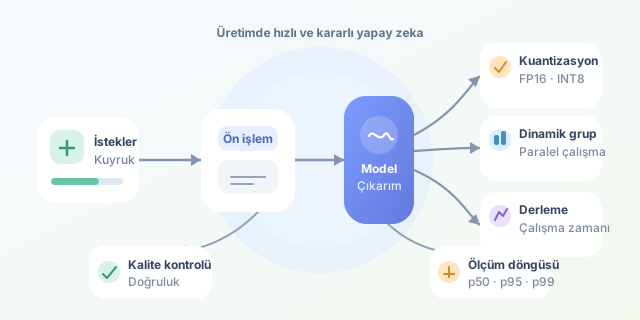
\[T_{toplam}=T_{kuyruk}+T_{ön\ işleme}+T_{hesaplama}+T_{son\ işleme}\]Modeli hızlandırmak yalnızca $T_{hesaplama}$ bölümünü düşürür. Sunucu kuyruğu uzunsa, tokenizasyon CPU’da tıkanıyorsa veya ağ gecikmesi yüksekse GPU’nun canavar gibi hızlı olması tek başına yeterli olmaz.
| Kavram | Amaç | Kullanıcıya Etkisi | Tipik Ölçüm |
|---|---|---|---|
| Latency | Tek isteği hızlandırmak | Daha hızlı yanıt | ms/istek |
| Throughput | Daha çok isteği işlemek | Yoğun saatte kararlılık | istek/saniye |
| TTFT | İlk çıktıyı erkene almak | Arayüz daha akıcı görünür | ms |
| Maliyet | Kaynak tüketimini azaltmak | Daha sürdürülebilir servis | TL veya $/istek \vert |
İlk güçlü teknik quantization, yani ağırlıkların daha düşük hassasiyetle temsil edilmesidir. Örneğin FP32 yerine FP16, BF16 veya INT8 kullanmak bellek ihtiyacını ve veri taşıma yükünü azaltır. 7 milyar parametreli bir model için yalnızca ağırlık belleği teorik olarak $7\times10^9\times4\approx28$ GB iken, INT8 ile yaklaşık 7 GB seviyesine iner. Ancak düşük bit sayısı her zaman bedava değildir: kalite kaybı, donanım uyumluluğu ve kalibrasyon gereksinimi değerlendirilmelidir.
| Yöntem | Hız/Bellek Kazancı | Kalite Riski | Uygun Senaryo |
|---|---|---|---|
| FP16/BF16 | Orta | Çok düşük | Modern GPU üretimi |
| INT8 | Yüksek | Düşük-orta | Görüntü ve dil modelleri |
| INT4 | Çok yüksek | Orta | Bellek kısıtlı LLM sunumu |
| Pruning | Modele bağlı | Orta | Özel donanım veya araştırma |
Batching ikinci büyük kaldıraçtır. Tek tek istekler GPU’yu yeterince doldurmayabilir; benzer istekleri küçük gruplar hâlinde çalıştırmak paralelliği yükseltir. Fakat statik batch bekleme süresi ekleyebilir. Bu nedenle gerçek zamanlı sistemlerde istekleri kısa bir pencere içinde toplayan dynamic batching kullanılır. LLM sunucularında continuous batching, yeni istekleri token üretimi devam eden gruplara katabildiği için özellikle etkilidir.
Aşağıdaki örnek, PyTorch tarafında inference için zorunlu iki optimizasyonu gösterir: gradyan hesaplamasını kapatmak ve modeli yarım hassasiyete almak. Kod, CUDA destekli bir ortam varsayar.
import torch

model = load_model().eval().half().cuda()
inputs = tokenize(["Merhaba", "Inference hızlı olsun!"])
inputs = {k: v.cuda() for k, v in inputs.items()}

with torch.inference_mode():
    outputs = model(**inputs)

print(outputs.logits.shape)
eval() dropout gibi eğitim davranışlarını kapatır. torch.inference_mode() ise autograd için gereksiz bellek ve işlem maliyetini kaldırır. Ancak half() dönüşümünü uygulamadan önce model katmanlarının FP16 ile uyumunu ve doğruluk sonuçlarını test etmek gerekir.
Model grafiğini derlemek de önemli bir adımdır. TensorRT, ONNX Runtime veya torch.compile, işlemleri birleştirebilir, kernel seçimlerini iyileştirebilir ve gereksiz bellek kopyalarını azaltabilir. Buna karşılık derleme süresi, dinamik giriş şekilleri ve hata ayıklama karmaşıklığı operasyonel maliyettir. Her model için aynı araç kazanmaz; profil verisi karar vermelidir.
Son olarak, optimizasyon bir yarış değil ölçüm döngüsüdür: gerçekçi trafik örnekleriyle benchmark alın, p50/p95/p99 gecikmelerini izleyin, kalite metriklerini koruyun ve değişiklikleri kademeli yayınlayın. En hızlı model, yalnızca laboratuvarda değil; yoğun trafikte, kabul edilebilir maliyetle ve güvenilir biçimde yanıt veren modeldir.
Yorumlar