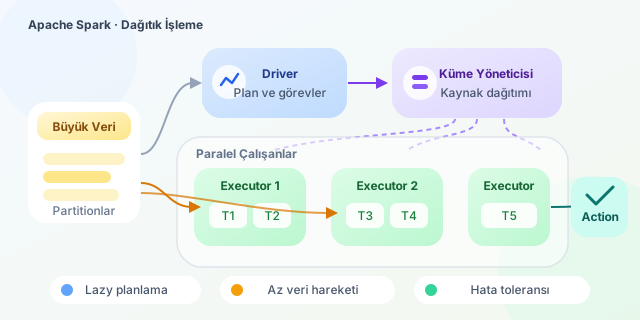
Bir sunucunun belleğine sığmayan, klasik araçlarla işlenmesi saatler hatta günler süren verilerle karşılaşıldığında sahneye Apache Spark çıkar. Spark; veriyi birden fazla makineye bölerek aynı işi paralel gerçekleştiren, hızlı ve genel amaçlı bir dağıtık hesaplama motorudur. Log analizi, öneri sistemleri, ETL hatları ve makine öğrenmesi gibi alanlarda devasa veri kümelerini yönetilebilir parçalara dönüştürür.
``
Spark’ın temel fikri oldukça sezgiseldir: Büyük bir veri kümesini partition adı verilen bölümlere ayır, bu bölümleri kümedeki çalışan düğümlere dağıt ve her düğümün kendi payına düşen işi eş zamanlı yapmasını sağla. Teoride toplam çalışma süresi, ideal koşullarda çalışan sayısıyla ters orantılı azalır:
\[T_{paralel} \approx \frac{T_{seri}}{N} + T_{iletisim} + T_{koordinasyon}\]Buradaki $N$ çalışan sayısını, diğer terimler ise ağ aktarımı ve görev planlama maliyetlerini ifade eder. Gerçek dünyada hızlanma hiçbir zaman kusursuz değildir; çünkü veri taşımak ve makineleri koordine etmek de zaman alır. Bu nedenle Spark projelerinde yalnızca “daha fazla makine” değil, daha az veri hareketi hedeflenir.
Spark uygulamasında dört önemli rol bulunur: Driver, uygulamanın beyni olarak işi planlar; Cluster Manager, kaynakları dağıtır; Executors, işlemleri yürütür; Tasks ise partition’lar üzerinde çalışan en küçük iş birimleridir. Driver, kodunuzu mantıksal bir işlem grafiğine dönüştürür ve uygun görevlere ayırır.
| Kavram | Görevi | Günlük Hayattan Benzetme |
|---|---|---|
| Driver | Planı oluşturur ve işleri yönetir | Şef aşçı |
| Executor | Veriyi işler, ara sonuçları tutar | Mutfak çalışanı |
| Partition | Verinin bağımsız işlenebilir bölümü | Sipariş fişi |
| Task | Bir partition için yapılan işlem | Tek bir yemeğin hazırlanması |
Spark’ın performans sırrı büyük ölçüde lazy evaluation yaklaşımıdır. map, filter veya select gibi dönüşümler çağrıldığında Spark çoğu zaman hemen hesaplama yapmaz. Bunun yerine yapılacak işleri kaydeder. count, collect, write gibi bir action geldiğinde planı optimize eder ve çalıştırır. Böylece gereksiz ara sonuçlar ve disk işlemleri azaltılır.
Aşağıdaki PySpark örneği, hata içeren log satırlarını seçer ve hata kodlarına göre sayım yapar:
from pyspark.sql import SparkSession
from pyspark.sql.functions import regexp_extract, col

spark = SparkSession.builder.appName("LogAnalizi").getOrCreate()

loglar = spark.read.text("s3a://veri-kovasi/uygulama.log")
hatalar = loglar.filter(col("value").contains("ERROR"))

sonuc = (
    hatalar
    .withColumn("kod", regexp_extract("value", r"ERROR\s+(E\d+)", 1))
    .groupBy("kod")
    .count()
    .orderBy(col("count").desc())
)

sonuc.show()
Bu kodda filter ve withColumn dönüşümdür; asıl hesaplama show() ile tetiklenir. Spark, mümkün olduğunca filtreyi erken uygulayarak sonraki aşamalara daha az satır taşımaya çalışır. Bu optimizasyon yaklaşımına predicate pushdown denir.
| İşlem Türü | Örnek | Veri Hareketi Etkisi |
|---|---|---|
| Narrow transformation | map, filter |
Genellikle düşük; partition kendi içinde çalışır |
| Wide transformation | groupBy, join |
Yüksek; shuffle gerektirebilir |
| Action | count, show, write |
İş planını gerçekten başlatır |
En pahalı işlem çoğunlukla shuffledır. groupBy veya iki büyük tabloyu join etmek, kayıtların yeni anahtarlara göre makineler arasında taşınmasına neden olur. Shuffle maliyetini azaltmak için erken filtreleme yapılmalı, gereksiz sütunlar seçilmemeli ve küçük boyutlu boyut tablolarında broadcast join tercih edilmelidir. Ayrıca tekrar kullanılan bir DataFrame için cache() veya persist() kullanmak, aynı hesabın yeniden yapılmasını engeller; ancak bellek kapasitesi dikkatle izlenmelidir.
Spark, yalnızca hız peşinde koşan bir araç değildir; hata toleransı da sunar. Bir executor çökerse Spark, işlemlerin soy ağacını yani lineage bilgisini kullanarak kayıp partition’ı yeniden üretir. Bu sayede devasa veri işleme hatları, tek bir makinenin arızasıyla tamamen durmaz. Doğru partition stratejisi, dikkatli shuffle yönetimi ve ölçümlere dayalı optimizasyonla Spark, büyük veriyi korkutucu bir yığın olmaktan çıkarıp paralel çalışan düzenli bir üretim hattına dönüştürür.
Yorumlar