İçindekiler
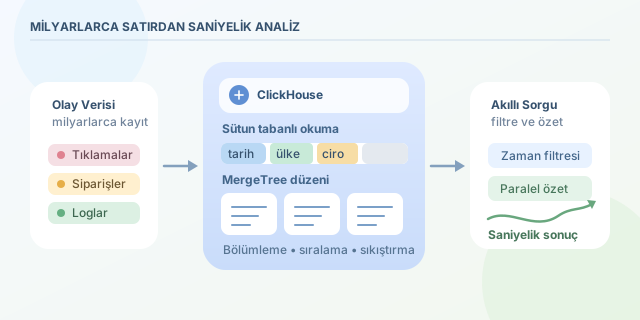
Bir analistin önünde milyarlarca olay kaydı olduğunu düşünün: tıklamalar, siparişler, sensör ölçümleri ve uygulama logları… Klasik satır tabanlı veritabanlarında bu tabloyu taramak bazen kahve molası gerektirir. ClickHouse ise analitik iş yükleri için tasarlanmış sütun tabanlı mimarisiyle, doğru veri modelinde bu molayı birkaç saniyelik bekleyişe dönüştürür. Sırrı yalnızca “hızlı SQL” değildir; veriyi diskten nasıl okuduğu, nasıl sıkıştırdığı ve sorguyu paralel nasıl yürüttüğüdür.
``
Neden sütun tabanlı depolama hızlıdır?
OLTP sistemleri, örneğin sipariş oluşturma ekranları, çoğunlukla tek bir kaydın tüm alanlarına ihtiyaç duyar. Bu yüzden satır tabanlı depolama mantıklıdır. Analitik sorgular ise genellikle milyonlarca satırın yalnızca birkaç sütununu okur: tarih, ülke ve ciro gibi. ClickHouse bu sütunları ayrı bloklarda tuttuğu için gereksiz alanları diskten okumaz.
Bir günlük satış tablosunda 40 sütun olduğunu, sorgunun yalnızca 3 sütun kullandığını varsayalım. Satır tabanlı yaklaşımda yaklaşık 40 alanlık veri dolaşırken, sütun tabanlı yaklaşım hedef alanlara odaklanır. Basitleştirilmiş okuma maliyeti şöyle düşünülebilir:
\[\text{Okuma Maliyeti} \approx \text{okunan sütun sayısı} \times \text{sıkıştırılmış veri boyutu}\]| Özellik | Satır tabanlı sistem | ClickHouse / sütun tabanlı sistem |
|---|---|---|
| Güçlü olduğu iş | Tekil ekleme ve güncelleme | Toplu tarama ve agregasyon |
| Disk okuması | Çoğu zaman tüm satır | Sadece gereken sütunlar |
| Sıkıştırma | Sütun değerleri karışık | Benzer değerlerde çok verimli |
| Tipik kullanım | İşlemsel uygulamalar | Raporlama, log, metrik analizi |
MergeTree: performansın omurgası
ClickHouse’ta analitik tabloların yıldızı genellikle MergeTree ailesidir. Veriler parçalar hâlinde yazılır, arka planda birleştirilir ve belirtilen sıralama anahtarına göre düzenlenir. Buradaki kritik ayrım şudur: ORDER BY, sonuç sırasını zorlamak için değil, fiziksel veri düzenini belirlemek için kullanılır.
Örneğin olay verisini tarih ve kullanıcı kimliğiyle sıralamak, belirli zaman aralıklarını ve kullanıcı kümelerini ararken gereksiz blokların atlanmasını sağlar. ClickHouse’un seyrek birincil indeksi satır satır adres tutmaz; granül denilen bloklara işaret eder. Bu nedenle doğru sıralama anahtarı, “indeks ekledim, artık her şey hızlı” beklentisinden çok daha değerlidir.
CREATE TABLE events
(
    event_time DateTime,
    user_id UInt64,
    country LowCardinality(String),
    event_name LowCardinality(String),
    revenue Decimal(12, 2)
)
ENGINE = MergeTree
PARTITION BY toYYYYMM(event_time)
ORDER BY (event_time, country, user_id);
Bu şema, veriyi aylara ayırır ve her parçada zamanı önceleyerek sıralar. LowCardinality, ülke ve olay adı gibi tekrar eden metinler için sözlük kodlaması kullanarak bellek ile depolama tüketimini düşürür. Ancak sıralama anahtarını rastgele seçmek yerine en sık kullanılan WHERE filtreleriyle uyumlu kurmak gerekir.
Milyarlarca satırı akıllıca sorgulamak
Aşağıdaki sorgu, son yedi gündeki ülke bazlı kullanıcı ve gelir özetini üretir:
SELECT
    country,
    uniqExact(user_id) AS aktif_kullanici,
    sum(revenue) AS toplam_gelir
FROM events
WHERE event_time >= now() - INTERVAL 7 DAY
  AND event_name = 'purchase'
GROUP BY country
ORDER BY toplam_gelir DESC;
Sorgu önce zaman filtresiyle uygun partition’ları, ardından sıralama ve indeks bilgisiyle ilgili granülleri hedefler. Son aşamada paralel çalışan agregasyon motoru sonuçları birleştirir. Çok büyük kümelerde uniqExact kesin sonuç verir fakat bellek maliyeti artabilir; yaklaşık sayım kabul edilebiliyorsa uniqCombined64 iyi bir hız-doğruluk dengesi sunar.
| İhtiyaç | Tercih | Not |
|---|---|---|
| Kesin tekil kullanıcı | uniqExact |
Yüksek bellek tüketebilir |
| Hızlı yaklaşık tekil sayım | uniqCombined64 |
Büyük kümelerde pratiktir |
| Sık tekrarlanan özet | Materialized View | Hesabı yazma anına taşır |
| Zaman aralığı taraması | Partition + ORDER BY |
Veri elemesini artırır |
ClickHouse hızını sihirden değil, veri erişimini azaltmaktan alır. Dar sütunlar seçin, SELECT * alışkanlığını bırakın, filtreleri sıralama anahtarına yakın kurun ve gerçek sorgularla EXPLAIN inceleyin. Doğru modelle, milyarlarca satır korkutucu bir duvar değil; hızlıca cevaplanabilen dev bir soru havuzudur.
Yorumlar