İçindekiler
Modern uygulamalar saniyede binlerce olay, sipariş, metrik veya log üretiyor. Bu kadar yoğun yazma trafiğinde klasik B-Tree tabanlı yapıların disk üzerinde yaptığı rastgele güncellemeler pahalılaşabilir. LSM Tree (Log-Structured Merge Tree), yazmaları önce sıralı ve hızlı alanlara yönlendirip düzenleme işini sonraya bırakan veri yapısı ailesidir. RocksDB, LevelDB, Apache Cassandra ve birçok zaman serisi çözümünün performans hikâyesinde bu yaklaşım bulunur. ``
LSM Tree’nin temel fikri şaşırtıcı derecede pratiktir: Diske her yeni kaydı doğru ağacın doğru sayfasına yerleştirmeye çalışma; önce bellekte biriktir, sıralı biçimde diske yaz, sonra da küçük dosyaları büyük ve düzenli dosyalarla birleştir. Diskler ve SSD’ler ardışık yazma işlemlerini rastgele yazmalardan genellikle daha verimli gerçekleştirir.
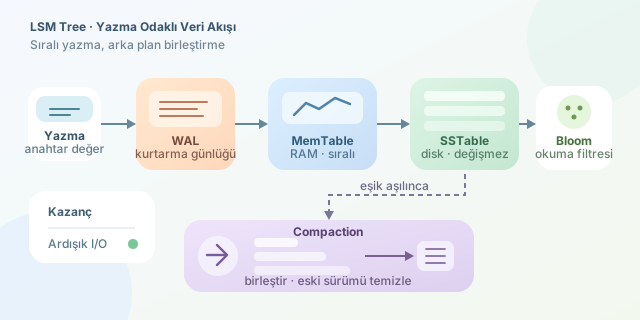
Yazma yolculuğu: WAL, MemTable ve SSTable
Bir put(anahtar, değer) isteği geldiğinde veri çoğunlukla önce Write-Ahead Log (WAL) içine eklenir. WAL, çökme sonrasında son yazıları geri yüklemek için dayanıklılık katmanıdır. Ardından kayıt, bellekte tutulan ve anahtara göre sıralı MemTable yapısına yazılır. MemTable belirli eşiğe ulaşınca değişmez hâle gelir ve diskteki sıralı SSTable (Sorted String Table) dosyasına flush edilir.
Yazma maliyetini basitleştirerek şöyle düşünebiliriz:
\[W_{LSM} \approx W_{WAL} + W_{sıralı\ flush} + W_{compaction}\]İlk iki terim çoğunlukla ardışık I/O olduğu için hızlıdır. Ancak son terim, yani compaction, sistemin bedava öğle yemeği olmadığını hatırlatır: Arka planda dosyalar birleştirilir, eski sürümler temizlenir ve veri seviyeler arasında taşınır.
| Bileşen | Görevi | Performans etkisi |
|---|---|---|
| WAL | Çökme sonrası kurtarma | Dayanıklılık için ek sıralı yazma |
| MemTable | Güncel veriyi RAM’de sıralı tutma | Çok düşük gecikmeli yazma |
| SSTable | Değişmez disk dosyası | Hızlı sıralı üretim, filtrelenebilir okuma |
| Compaction | Dosyaları birleştirme ve temizleme | Arka plan I/O maliyeti |
Okumalar neden biraz daha karmaşıktır?
LSM’de güncel bir anahtar önce MemTable’da, sonra en yeni SSTable’larda, ardından eski seviyelerde aranır. Bu nedenle salt yazma odaklı tasarım, kontrolsüz bırakılırsa okuma maliyetini büyütebilir. Sistemler bunu Bloom filter, indeks blokları ve blok önbelleğiyle dengeler.
Bloom filter, “bu dosyada anahtar kesinlikle yok” diyebilen olasılıksal bir yapıdır. Yanlış pozitif üretebilir ama yanlış negatif üretmez. Yaklaşık yanlış pozitif oranı:
\[p \approx \left(1-e^{-kn/m}\right)^k\]Burada $m$ bit sayısı, $n$ eklenen anahtar sayısı, $k$ ise hash fonksiyonu sayısıdır. Amaç, gereksiz SSTable disk erişimlerini azaltmaktır.
| Özellik | LSM Tree | B-Tree |
|---|---|---|
| Yazma deseni | Çoğunlukla ardışık | Sıklıkla rastgele sayfa güncellemesi |
| Okuma | Birden fazla tabloya bakabilir | Dengeli ağaçta doğrudan yol izler |
| Arka plan işi | Compaction gerekir | Sayfa bölme ve dengeleme gerekir |
| Uygun senaryo | Log, telemetry, ağır ingest | Karma okuma/yazma, aralık sorguları |
Küçük bir akış örneği
Aşağıdaki sözde Python kodu, gerçek bir veritabanı motoru değil; yazma akışının fikrini gösterir:
memtable[key] = value          # RAM'de sıralı yapıya ekle
wal.append((key, value))       # Kurtarma için günlüğe yaz

if memtable.size() >= LIMIT:
    table = memtable.freeze()
    write_sorted_sstable(table)  # Değişmez, sıralı disk dosyası üret
    schedule_compaction()        # Eski ve yeni tabloları sonra birleştir
    memtable = new_memtable()
Silme işlemleri de çoğu zaman kaydı hemen fiziksel olarak kaldırmaz. Bunun yerine tombstone adı verilen silme işareti yazılır; gerçek temizlik compaction sırasında yapılır. Böylece silme de hızlı yazma yolundan yararlanır.
Özetle LSM Tree, yazma işlemini geciktirerek hızlandıran bir tasarımdır. Karşılığında compaction planlaması, disk alanı ve okuma optimizasyonu dikkat ister. Yazma ağırlıklı bir NoSQL sistemi tasarlarken asıl soru “LSM hızlı mı?” değildir; “iş yüküm, bu hızlı yazma ile gelen birleştirme maliyetini kaldırabilir mi?” olmalıdır.
Yorumlar