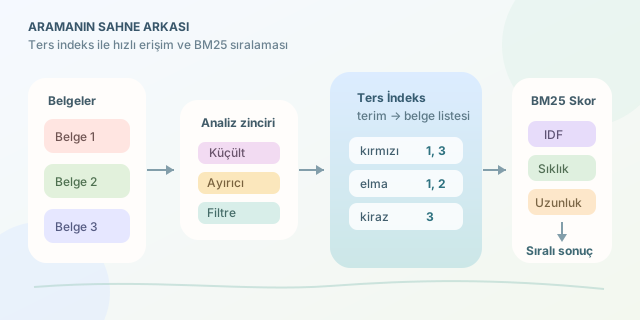
Elasticsearch, milyonlarca belge arasında milisaniyeler içinde arama yapabilmesini büyük ölçüde ters indeks (inverted index) adlı yapıya borçludur. Klasik bir veritabanında “bu belgenin içinde hangi kelimeler var?” sorusu öne çıkarken, ters indeks “bu kelime hangi belgelerde geçiyor?” sorusunu merkeze alır. Arama motoru dünyasının sihirbaz şapkası tam olarak budur. ``
Ters indeks nedir?
Bir kitap dizinini düşünün: Kitabın sonunda “algoritma: 12, 48, 93” gibi kayıtlar bulunur. Ters indeks de benzer biçimde her terimi, o terimin geçtiği belge kimlikleriyle eşleştirir. Elasticsearch, metni doğrudan saklamanın yanında Lucene altyapısı üzerinden bu özel veri yapısını üretir.
Örneğin üç belge ele alalım:
| Belge | İçerik |
|---|---|
| 1 | Kırmızı elma tatlıdır |
| 2 | Yeşil elma ekşidir |
| 3 | Kırmızı kiraz tatlıdır |
Standart bir analizden sonra indeks kabaca şu görünümü alır:
| Terim | Belge listesi (posting list) |
|---|---|
| kırmızı | 1, 3 |
| elma | 1, 2 |
| tatlıdır | 1, 3 |
| yeşil | 2 |
| kiraz | 3 |
elma araması yapıldığında Elasticsearch bütün belgeleri tek tek okumaz; doğrudan elma teriminin posting listesine gider ve 1 ile 2 numaralı belgeleri bulur. Bu nedenle ters indeks, özellikle geniş metin koleksiyonlarında doğrusal taramaya göre dramatik ölçüde hızlıdır.
Analiz zinciri: İndeksin mutfağı
Bir metnin indekse girmeden önce geçirdiği dönüşüm, arama kalitesini doğrudan belirler. analyzer; karakter filtreleri, tokenizer ve token filtrelerinden oluşur. Türkçe metinlerde küçük harfe çevirme, noktalama temizleme ve eklerden kaynaklanan farklılıkları ele alma kritik olabilir.
PUT urunler
{
  "settings": {
    "analysis": {
      "analyzer": {
        "turkce_baslik": {
          "tokenizer": "standard",
          "filter": ["lowercase", "turkish_stop"]
        }
      }
    }
  },
  "mappings": {
    "properties": {
      "baslik": { "type": "text", "analyzer": "turkce_baslik" }
    }
  }
}
Bu yapı, Baslik alanındaki metni aranabilir token’lara ayırır. Ancak stop-word filtresi bazı yaygın kelimeleri kaldırabileceğinden, alanın amacına göre dikkatle seçilmelidir. Aranacak alanlar için text, tam eşleşme, sıralama veya filtreleme gereken alanlar için çoğunlukla keyword kullanılır.
| Özellik | text |
keyword |
|---|---|---|
| Analiz uygulanır mı? | Evet | Hayır |
| Kullanım amacı | Tam metin arama | Kesin eşleşme ve aggregation |
| Örnek | Makale gövdesi | Kategori, etiket, kod |
Skor neden her belgede farklıdır?
Bir match sorgusu yalnızca eşleşen belgeleri döndürmez; onların ne kadar ilgili olduğunu da hesaplar. Elasticsearch’ün varsayılan benzerlik algoritması BM25’tir. Basitleştirilmiş haliyle skor şu fikre dayanır:
Burada $f(t,D)$ terimin belgedeki sıklığı, $\vert D\vert $ belge uzunluğu, $avgdl$ ortalama belge uzunluğudur. $IDF(t)$ ise nadir terimlere daha yüksek değer verir. Yani “elma” binlerce belgede geçiyorsa daha az ayırt edicidir; nadir bir model adı ise skoru daha fazla yükseltir.
BM25’in önemli bir nüansı vardır: Aynı kelimeyi onlarca kez yazmak skoru sonsuza kadar şişirmez. Terim sıklığının katkısı zamanla doygunluğa ulaşır. Ayrıca uzun belgeler, yalnızca çok kelime içeriyor diye haksız avantaj elde etmesin diye uzunluk normalizasyonu uygulanır.
GET urunler/_search
{
  "query": {
    "match": {
      "baslik": {
        "query": "kırmızı elma",
        "operator": "and"
      }
    }
  },
  "explain": true
}
operator: "and", iki terimin de bulunmasını ister; explain: true ise skorun hangi terim, frekans ve normalizasyon bileşenlerinden oluştuğunu gösterir. Üretimde sürekli açık tutulması maliyetli olabileceği için bunu teşhis aracı olarak kullanmak daha doğrudur.
Sonuç olarak iyi Elasticsearch araması, yalnızca doğru sorguyu yazmak değildir: doğru analyzer, mantıklı alan eşlemesi ve BM25’in davranışını anlayan bir relevancy stratejisi gerektirir. Ters indeks kapıyı hızla açar; skor mekanizması ise içeride hangi sonucun önce karşılanacağına karar verir.
Yorumlar