İçindekiler
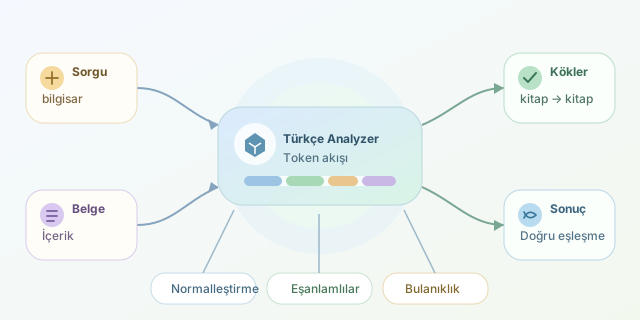
Bir kullanıcı “bilgisayar mühendisliği” yerine “bilgisar muhendisligi” yazdığında arama motorunun küsmek yerine doğru sonuçları getirmesini isteriz. Elasticsearch bunu tek bir sihirli ayarla değil; karakter normalizasyonu, tokenization, kök bulma, durdurma kelimeleri, eşanlamlılık ve bulanık eşleştirme katmanlarını birlikte kullanarak başarır.
``
Analyzer nasıl çalışır?
Bir analyzer, metni aranabilir terimlere dönüştüren bir işleme hattıdır. Bu hat üç temel bileşenden oluşur:
- Character filter: Metin tokenlara ayrılmadan önce karakterleri dönüştürür.
- Tokenizer: Cümleyi kelime veya token parçalarına böler.
- Token filter: Küçük harfe çevirme, kök bulma ve eşanlamlı genişletme gibi işlemleri uygular.
Örneğin “Bilgisayarların ve Yazılımcıların Dünyası” ifadesi analiz sonunda bilgisayar, yazılımcı, dünya benzeri terimlere dönüşebilir. Türkçenin eklemeli yapısı nedeniyle kök bulma özellikle önemlidir: “kitap”, “kitaplar” ve “kitaplardan” aynı kavrama yaklaşmalıdır.
| Araç | Görevi | Örnek |
|---|---|---|
| lowercase | Harfleri normalleştirir | İSTANBUL → istanbul |
| stopwords | Anlam yükü düşük sözcükleri kaldırır | ve, ile, bir |
| stemmer | Sözcüğü kök/gövde biçimine yaklaştırır | arabalar → araba |
| synonyms | Kavramsal alternatifler üretir | pc → bilgisayar |
| fuzziness | Yazım hatalarını tolere eder | bilgisar ≈ bilgisayar |
Türkçe analyzer tanımlamak
Aşağıdaki indeks ayarı, indeksleme ve arama için iki farklı analyzer oluşturur. Eşanlamlıların arama zamanında uygulanması, sözlüğün davranışını daha kontrollü hâle getirir.
PUT urunler
{
  "settings": {
    "analysis": {
      "filter": {
        "tr_stop": {
          "type": "stop",
          "stopwords": "_turkish_"
        },
        "tr_stemmer": {
          "type": "stemmer",
          "language": "turkish"
        },
        "tr_synonyms": {
          "type": "synonym_graph",
          "lenient": true,
          "synonyms": [
            "bilgisayar, pc",
            "cep telefonu, akıllı telefon",
            "televizyon, tv"
          ]
        }
      },
      "analyzer": {
        "tr_index": {
          "tokenizer": "standard",
          "filter": ["lowercase", "tr_stop", "tr_stemmer"]
        },
        "tr_search": {
          "tokenizer": "standard",
          "filter": ["lowercase", "tr_synonyms", "tr_stop", "tr_stemmer"]
        }
      }
    }
  },
  "mappings": {
    "properties": {
      "ad": {
        "type": "text",
        "analyzer": "tr_index",
        "search_analyzer": "tr_search"
      }
    }
  }
}
synonym_graph, “cep telefonu” gibi birden fazla token içeren eşanlamlılarda ifade ilişkilerini korur. Filtre sırası önemlidir: eşanlamlı sözlüğü hangi biçimde yazıldıysa kelimeler önce o biçime normalize edilmelidir. Üretim ortamında büyük listeleri indeks ayarına gömmek yerine yönetilebilir synonym set’leri tercih etmek daha pratiktir.
Yazım hatalarını fuzziness ile yakalamak
Stemmer dilbilgisel ekleri işler; yazım hatalarını düzeltmez. “bilgisar” için sorgu tarafında bulanık eşleştirme gerekir:
GET urunler/_search
{
  "query": {
    "match": {
      "ad": {
        "query": "bilgisar muhendisligi",
        "fuzziness": "AUTO",
        "prefix_length": 1
      }
    }
  }
}
Bulanıklık, Levenshtein düzenleme mesafesine dayanır. İki sözcük arasındaki mesafe kabaca şu işlemlerin en az sayısıdır:
\[d(a,b)=\min(\text{ekleme},\text{silme},\text{değiştirme})\]AUTO, kısa kelimelerde daha katı, uzun kelimelerde daha toleranslı davranır. Ancak fuzziness arttıkça aday terim sayısı ve sorgu maliyeti de yükselir. Bu nedenle prefix_length, alan bazlı ağırlıklandırma ve sonuç skoru mutlaka test edilmelidir.
Sağlam bir arama stratejisi
| İhtiyaç | Önerilen çözüm |
|---|---|
| Çekim ekleri | Turkish stemmer |
| Gereksiz bağlaçlar | Turkish stopwords |
| Kavramsal alternatifler | synonym_graph |
| Klavye ve yazım hataları | fuzziness: AUTO |
| Tam ifade önceliği | match_phrase ile ek boost |
Analyzer değişiklikleri mevcut belgeleri kendiliğinden yeniden analiz etmez. Mapping tasarımı değiştiğinde yeni indeks oluşturup _reindex yapmak gerekir. Son adım ise gerçek kullanıcı sorgularından bir test kümesi hazırlamaktır; çünkü iyi arama sistemi yalnızca sonuç bulan değil, doğru sonucu üst sıralara taşıyan sistemdir.
Yorumlar