İçindekiler
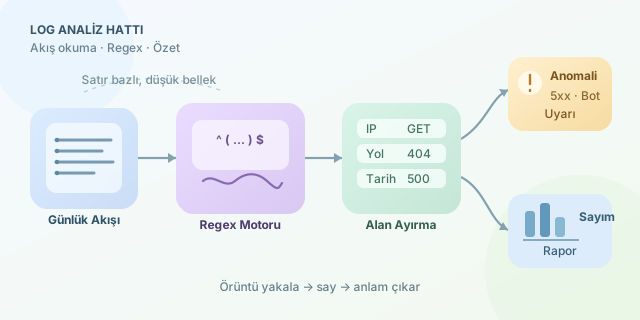
Sunucu günlükleri, bir sistemin hem kara kutusu hem de olay mahallidir: hatalar, ziyaretçi davranışları, şüpheli istekler ve performans darboğazları satır satır burada yaşar. Perl, modern dillerin gölgesinde kalsa da metin işleme konusunda hâlâ son derece etkili bir araçtır. Özellikle büyük log dosyalarında düzenli ifadelerle örüntü yakalama, akış halinde veri okuma ve hızlı özet rapor üretme işlerinde az kodla güçlü sonuçlar verir.
``
Neden Perl ve düzenli ifadeler?
Log analizi çoğunlukla yapılandırılmamış veya yarı yapılandırılmış metni anlamlı alanlara ayırma problemidir. Örneğin bir Apache erişim kaydında IP adresi, tarih, HTTP metodu, durum kodu ve yanıt boyutu tek satırda bulunur. Düzenli ifade motoru bu parçaları yakalama grupları ile ayırır.
Bir satırın uzunluğu $n$, analiz edilen toplam satır sayısı $m$ olsun. Basit ve geri izleme tuzağı içermeyen bir regex için tarama maliyeti yaklaşık olarak $O(m \times n)$ kabul edilebilir. Ancak .* gibi açgözlü ifadelerin art arda ve belirsiz kullanımı, başarısız eşleşmelerde maliyeti dramatik biçimde artırabilir. Bu nedenle regex yazmak, yalnızca desen üretmek değil; aynı zamanda kontrollü bir arama uzayı tasarlamaktır.
| Yaklaşım | Güçlü yönü | Dikkat edilmesi gereken |
|---|---|---|
split |
Sabit ayraçlı kayıtlar için okunaklıdır | Tırnaklı veya eksik alanlarda kırılabilir |
| Regex | Esnek formatları yakalar | Karmaşık desenler pahalı olabilir |
| JSON ayrıştırıcı | Yapısal loglarda güvenilirdir | Her eski log formatında kullanılamaz |
| Perl akış okuma | Dev dosyalarda düşük bellek tüketir | Satır bazlı tasarım gerektirir |
Apache satırını alanlarına ayırmak
Aşağıdaki örnek, Common Log Format benzeri kayıtları dosyayı tamamen belleğe almadan işler. Her satır için IP, istek metodu, yol ve HTTP durum kodu çıkarılır; ardından durum kodlarının frekansı hesaplanır.
use strict;
use warnings;

my %status_count;
my %path_count;

while (my $line = <>) {
    chomp $line;

    if ($line =~ m{^(\S+) \S+ \S+ \[[^\]]+\] "(GET\vert POST\vert PUT\vert DELETE\vert PATCH) (\S+) HTTP/[^ ]+" (\d{3})}) {
        my ($ip, $method, $path, $status) = ($1, $2, $3, $4);
        $status_count{$status}++;
        $path_count{$path}++ if $status >= 400;
    }
}

print "HTTP durum özeti:\n";
print "$_ => $status_count{$_}\n" for sort keys %status_count;
Bu betik perl analiz.pl access.log şeklinde çalıştırılabilir. <> operatörü satırları sırayla okuduğu için 20 GB’lık bir dosya bile teorik olarak tümü RAM’e yüklenmeden incelenebilir. Regex içindeki \S+, boşluk olmayan karakter dizisini; (\d{3}) ise üç haneli durum kodunu temsil eder.
Örüntüleri sayıya dönüştürmek
Ham sayı tek başına her zaman anlam taşımaz. Örneğin hata oranını hesaplamak için toplam istek sayısı $T$, 5xx hata sayısı $E$ ise:
\[\text{Hata Oranı} = \frac{E}{T} \times 100\]Bu oran ani artış gösterdiğinde uygulama, veritabanı veya ağ katmanında bir sorun araştırılmalıdır. Benzer biçimde, tek bir IP’nin çok sayıda farklı URL’ye kısa sürede 404 isteği göndermesi tarama botuna ya da keşif girişimine işaret edebilir.
\vert Gözlem \vert Olası yorum \vert İlk aksiyon \vert \vert —\vert —\vert —\vert \vert 500 kodlarında sıçrama \vert Uygulama veya bağımlılık hatası \vert Hata logunu zaman damgasıyla eşleştir \vert \vert Çok sayıda 404 \vert Bozuk bağlantı veya bot taraması \vert En çok istenen yolları listele \vert \vert Tek IP’den yoğun POST \vert Brute-force veya otomasyon \vert Oran sınırlama ve kimlik doğrulama kayıtlarını incele \vert \vert Uzun yanıt süreleri \vert Performans darboğazı \vert URL ve zaman aralığı bazında grupla \vert
Regex performansı için küçük ama etkili kurallar
Deseni mümkün olduğunca satır başlangıcına ^ ve sonuna $ ile sabitlemek, motorun gereksiz konumlarda arama yapmasını önler. Yakalama sonucuna ihtiyacınız yoksa parantez yerine (?:...) kullanmak da niyeti netleştirir. Ayrıca güvenilmeyen, çok uzun girdilerde aşırı geri izlemeyi önlemek için gevşek .* desenlerinden kaçının; örneğin köşeli parantez içeriği için [^\]]+ daha hedeflidir.
Perl’in asıl gücü, bu filtreleri küçük betiklerle birleştirmesidir. Önce regex ile kayıtları ayıklayın, sonra hash yapılarıyla sayın, en sonunda CSV veya JSON raporu üretin. Eski görünen bu yaklaşım, doğru desen ve akış odaklı tasarımla bugün bile büyük günlük yığınlarını anlamlandıran çevik bir analiz hattına dönüşür.
Yorumlar