İçindekiler
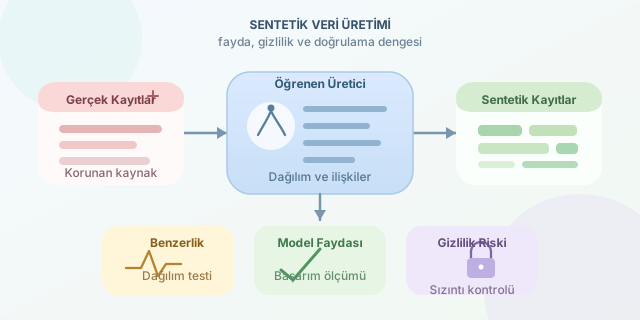
Bir yapay zekâ modelini eğitmek için binlerce sağlık kaydına ihtiyacınız olduğunu, ancak gizlilik yasaları nedeniyle bu kayıtlara dokunamadığınızı düşünün. Çözüm, gerçek kişileri temsil etmeyen fakat gerçek verinin istatistiksel davranışlarını taklit eden sentetik veri üretmektir. Böylece Ayşe Hanım’ın tansiyonunu paylaşmadan, toplumdaki tansiyon dağılımını modellemek mümkün olur.
``
Sentetik veri tam olarak nedir?
Sentetik veri, gerçek bir veri kümesinden öğrenilen dağılımlar, değişken ilişkileri ve iş kuralları kullanılarak algoritmik biçimde üretilen yapay kayıtlardır. Amaç gerçek satırları kopyalamak değil, onların genel özelliklerini korumaktır.
Örneğin yaş değişkeninin ortalaması $\mu=42$, standart sapması $\sigma=12$ ise basit bir üretici şu dağılımdan örnek alabilir:
\[X_{yaş} \sim \mathcal{N}(42, 12^2)\]Ancak yalnızca yaş dağılımını taklit etmek yeterli değildir. Yaş ile gelir arasında ilişki varsa sentetik veride de benzer bir korelasyon görülmelidir. İki değişken arasındaki doğrusal ilişki Pearson katsayısıyla ölçülebilir:
\[r = \frac{\operatorname{cov}(X,Y)}{\sigma_X\sigma_Y}\]Gerçek veride $r=0.65$, sentetik veride ise $r=0.02$ çıkıyorsa tekil dağılımlar doğru görünse bile veri kümesinin hikâyesi kaybolmuş demektir.
Hangi yöntemler kullanılır?
| Yöntem | Temel yaklaşım | Güçlü yanı | Zayıf yanı |
|---|---|---|---|
| İstatistiksel örnekleme | Bilinen dağılımlardan değer üretir | Basit ve hızlıdır | Karmaşık ilişkileri kaçırabilir |
| Copula modelleri | Değişken bağımlılıklarını modeller | Tablosal veride etkilidir | Çok karmaşık örüntülerde sınırlıdır |
| GAN | Üretici ve ayırt edici ağları yarıştırır | Gerçekçi örnekler oluşturabilir | Eğitimi kararsız olabilir |
| VAE | Veriyi gizli bir uzayda temsil eder | Kontrollü üretime uygundur | Sonuçlar bazen fazla yumuşaktır |
| Diferansiyel gizlilik | Üretim sürecine matematiksel gürültü ekler | Gizlilik garantisi sağlar | Veri faydasını azaltabilir |
GAN yaklaşımında üretici $G$, rastgele gürültüyü gerçekçi kayıtlara dönüştürmeye çalışırken ayırt edici $D$, gerçek ve yapay örnekleri ayırmaya çalışır. Bu rekabet kabaca şu hedefle ifade edilir:
\[\min_G \max_D \; \mathbb{E}_{x\sim p_{data}}[\log D(x)] + \mathbb{E}_{z\sim p_z}[\log(1-D(G(z)))]\]Kısacası biri sahte kimlik kartı hazırlarken diğeri sürekli güvenlik kontrolü yapar; ikisi geliştikçe sonuçlar daha inandırıcı hâle gelir.
Python ile küçük bir örnek
Aşağıdaki kod, gerçek bir tabloyu öğrenip yeni müşteri kayıtları üreten Gaussian Copula modelini kullanır:
import pandas as pd
from sdv.metadata import SingleTableMetadata
from sdv.single_table import GaussianCopulaSynthesizer

real_data = pd.read_csv("customers.csv")

metadata = SingleTableMetadata()
metadata.detect_from_dataframe(real_data)

model = GaussianCopulaSynthesizer(metadata)
model.fit(real_data)

synthetic_data = model.sample(num_rows=1000)
synthetic_data.to_csv("synthetic_customers.csv", index=False)
detect_from_dataframe sütun türlerini belirler, fit dağılımları ve sütunlar arası bağımlılıkları öğrenir, sample ise gerçek tabloda bulunmayan yeni satırlar üretir. Yine de çıkan dosyayı doğrudan güvenli ilan etmek doğru değildir.
Gerçekçilik ve gizlilik nasıl ölçülür?
İyi bir sentetik veri kümesi üç sınavdan geçmelidir:
- İstatistiksel benzerlik: Ortalama, varyans, kategorik oranlar ve korelasyonlar karşılaştırılmalıdır.
- Model faydası: Gerçek veriyle eğitilen model ile sentetik veriyle eğitilen modelin doğrulukları yakın olmalıdır.
- Gizlilik riski: Sentetik kayıtların gerçek kişilere aşırı benzemediği doğrulanmalıdır.
| Kontrol | Sorulan soru |
|---|---|
| Dağılım testi | Sütunların istatistikleri korunmuş mu? |
| TSTR testi | Sentetik veride eğitip gerçek veride test edince başarı nasıl? |
| En yakın komşu analizi | Bir sentetik satır gerçek satırı kopyalıyor mu? |
| Üyelik çıkarımı | Bir kişinin eğitim verisinde olduğu anlaşılabiliyor mu? |
Sentetik veri, anonimleştirmenin sihirli ve otomatik bir eş anlamlısı değildir. Model gerçek kayıtları ezberlerse ad, kimlik numarası bulunmasa bile hassas örüntüler sızabilir. Bu nedenle KVKK ve GDPR gibi düzenlemeler açısından amaç, yöntem, erişim kontrolü ve yeniden tanımlama riski ayrıca değerlendirilmelidir.
Doğru üretildiğinde sentetik veri; sağlık, finans, sigorta ve otonom araçlar gibi alanlarda inovasyonun önünü açar. Başarı formülü ise nettir: yüksek istatistiksel fayda, ölçülebilir gizlilik ve sürekli doğrulama. Gerçek insanları riske atmadan gerçek problemlere çalışan modeller geliştirmek, sentetik verinin asıl süper gücüdür.
Yorumlar